O blog da AWS
Reduza a latência entre AZs com o endpoint de metadados do AWS Lambda
Por Daniel Abib, Arquiteto de Soluções Especialista na Amazon Web Services.
Os clientes usam o AWS Lambda para criar aplicações que se conectam a backends com estado e sensíveis à latência, como o Amazon ElastiCache, o Amazon Relational Database Service (Amazon RDS) e outros serviços que expõem endpoints por zona de disponibilidade (AZ). Para alta disponibilidade, o Lambda provisiona automaticamente seus ambientes de execução em várias zonas de disponibilidade de uma Região. Essa resiliência é transparente para o seu código. Isso também significa que, até agora, uma função não tinha como saber em qual zona de disponibilidade estava sendo executada. Quando uma função em uma AZ se conecta a um recurso em outra AZ, a requisição atravessa o limite da AZ, adicionando latência de rede e, em alguns casos, custos de transferência de dados entre AZs.
O Lambda agora expõe metadados da zona de disponibilidade por meio de um endpoint de metadados no ambiente de execução. Sua função pode descobrir o ID da sua AZ (por exemplo, use1-az1) com uma requisição HTTP. Você pode usar essa informação para priorizar endpoints na mesma AZ para serviços downstream, reduzir a latência entre AZs e implementar padrões de resiliência com reconhecimento de AZ, como testes de injeção de falhas específicos por AZ. O recurso está disponível sem custo adicional em todas as Regiões comerciais da AWS em que o Lambda é oferecido. Ele funciona em todos os runtimes, incluindo runtimes personalizados e imagens de container, e é compatível com o SnapStart, a simultaneidade provisionada e funções em uma nuvem privada virtual (VPC). Para obter mais informações sobre esses detalhes de compatibilidade, consulte Usando o endpoint de metadados do Lambda.
Nesta publicação, você aprenderá como o endpoint de metadados do Lambda funciona, como obter o ID da AZ usando o Powertools for AWS Lambda ou chamando o endpoint diretamente, e como usar o ID da AZ para rotear para recursos na mesma AZ com menor latência.
Por que o reconhecimento da zona de disponibilidade é importante
Considere um caminho de leitura sensível à latência: uma função Lambda acionada por uma API que lê de um cluster do ElastiCache com um nó em cada uma de três zonas de disponibilidade. O Lambda distribui seus ambientes de execução por essas mesmas AZs para fins de resiliência, mas o posicionamento é independente de onde cada nó de cache está localizado. Aproximadamente duas em cada três invocações acabam se comunicando com um nó de cache em uma AZ diferente daquela em que a função está sendo executada.
Um round trip na mesma AZ normalmente leva poucos milissegundos. Um round trip entre AZs adiciona mais latência e, em um caminho de leitura de alto volume executado milhares de vezes por segundo, esses milissegundos se acumulam em maior latência p99 e cobranças adicionais de transferência de dados entre AZs. Antes deste recurso, evitar o tráfego entre AZs a partir do Lambda exigia soluções alternativas personalizadas. Elas incluíam incorporar dicas de AZ em variáveis de ambiente por versão de função ou inferir a localidade a partir de intervalos de IP, e nenhuma delas era confiável.
O mesmo padrão aparece em muitos dos serviços baseados em VPC e com escopo de AZ aos quais suas funções se conectam. Com o Amazon RDS e o Amazon Aurora, a instância de gravação reside em uma única AZ e cada réplica de leitura reside em sua própria AZ. Uma função com muitas leituras que distribui suas consultas entre as réplicas, na maioria das vezes, alcançará uma réplica em uma AZ diferente. Quando sua função conhece o próprio ID de AZ, você pode direcionar as leituras para a réplica que está na mesma AZ. Isso mantém o caminho de consulta de alto volume dentro da AZ e ainda faz failover para outra réplica quando nenhuma da mesma AZ está disponível. Para obter mais informações, consulte Configurando o balanceamento de carga de réplicas de leitura do Aurora.
O Amazon MemoryDB estende a mesma ideia para uma topologia durável de primário/réplica: as gravações vão para o primário do shard em uma AZ, enquanto as leituras podem ser atendidas por réplicas distribuídas pelas demais. Considere um caminho de alto volume e predominantemente de leitura que tolera consistência eventual, como a consulta de dados de referência ou o atendimento de consultas em cache. Direcionar as leituras para a réplica na AZ da função mantém a parte mais intensa da carga de trabalho dentro da AZ, enquanto as gravações continuam sendo roteadas para o primário onde quer que ele esteja. Como as réplicas têm um pequeno atraso assíncrono em relação ao primário, envie qualquer leitura que precise refletir sua própria gravação diretamente ao primário, em vez de a uma réplica na mesma AZ.
As plataformas de containers apresentam o mesmo comportamento quando o Lambda as chama. Se sua função invoca um serviço em execução no Amazon Elastic Kubernetes Service (Amazon EKS) ou no Amazon Elastic Container Service (Amazon ECS), os pods ou tarefas por trás desse serviço são distribuídos entre as AZs e, por padrão, uma requisição pode chegar a qualquer um deles. Você pode combinar o ID da AZ da função com roteamento com reconhecimento de topologia para manter o tráfego leste-oeste dentro da AZ. Os exemplos incluem o Topology Aware Routing do Kubernetes ou um balanceador de carga interno com o balanceamento entre zonas ajustado. O mesmo raciocínio se aplica a uma função que chama um serviço privado exposto por um Application Load Balancer interno ou descoberto por meio do AWS Cloud Map: conhecer a AZ do chamador transforma “qualquer destino íntegro” em “o destino íntegro mais próximo”.
O endpoint de metadados elimina essa adivinhação. Sua função pergunta ao ambiente de execução onde ela está sendo executada, recebe um ID de AZ estável e roteia de acordo.
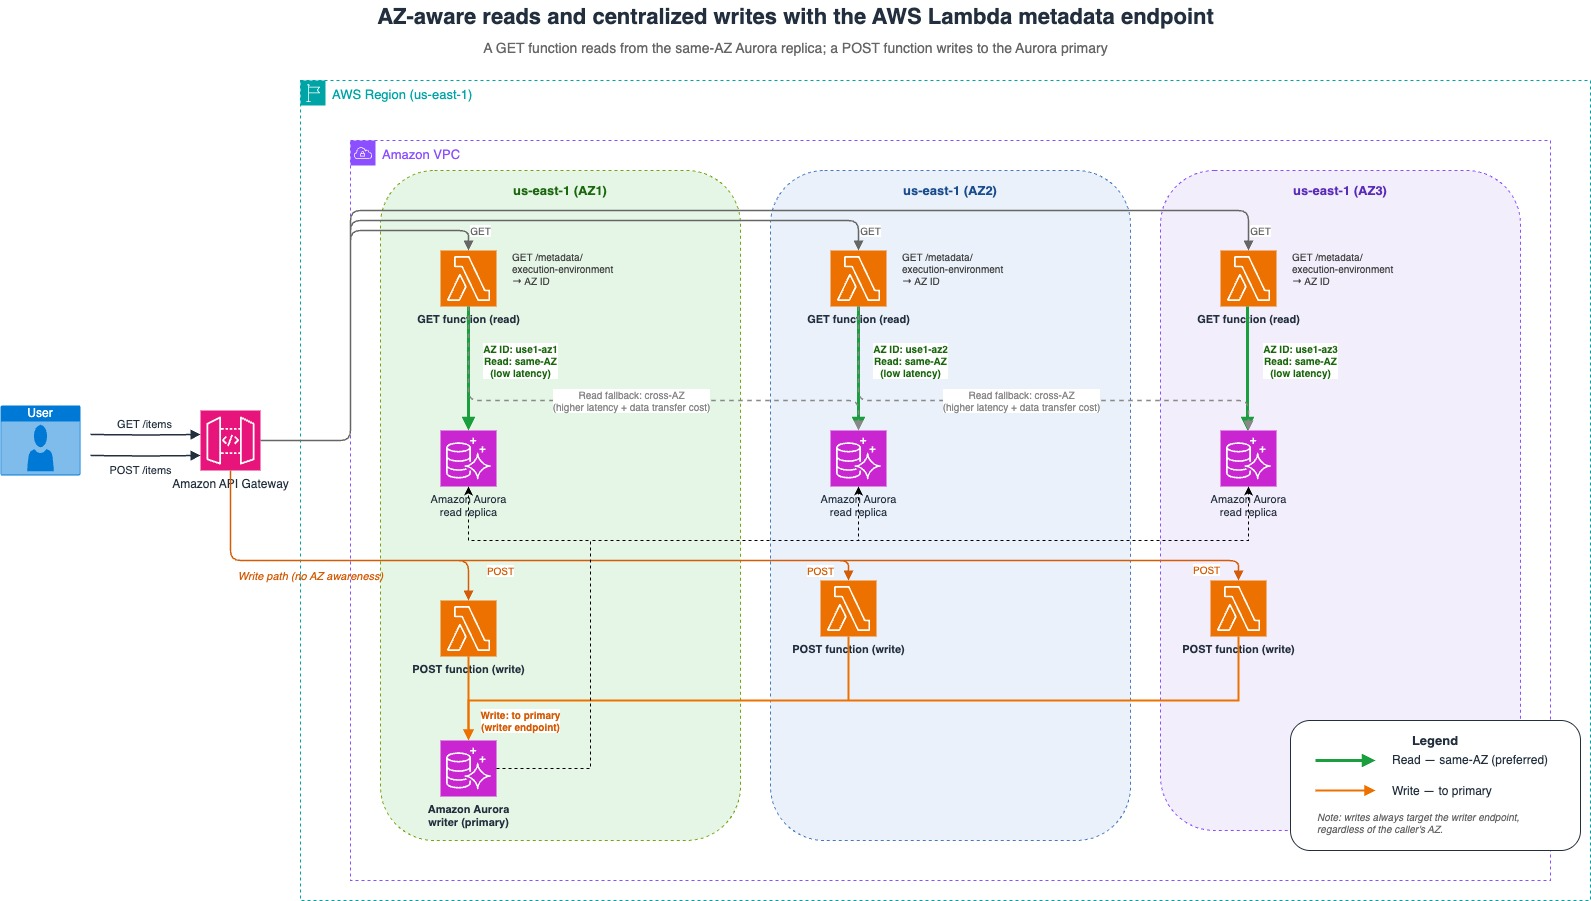
Figura 1: Leituras com reconhecimento de AZ e gravações centralizadas com o endpoint de metadados do AWS Lambda
Como o endpoint de metadados funciona
O endpoint de metadados é uma API HTTP de loopback disponível dentro do ambiente de execução do Lambda, acessível tanto por runtimes quanto por extensões. O Lambda define automaticamente duas variáveis de ambiente em cada ambiente de execução:
AWS_LAMBDA_METADATA_API– O endereço do servidor de metadados no formato{ipv4_address}:{port}(por exemplo,169.254.100.1:9001). Para obter mais informações sobre como esse endereço e essa porta são atribuídos, consulte Usando o endpoint de metadados do Lambda.AWS_LAMBDA_METADATA_TOKEN– Um token de autenticação exclusivo para o ambiente de execução atual, gerado automaticamente na inicialização. Você o inclui em todas as requisições à API de metadados.
Você recupera os metadados com uma requisição GET autenticada:
A resposta é um pequeno documento JSON:
O cabeçalho Authorization deve conter um token Bearer (Authorization: Bearer <token>). Essa autenticação baseada em token oferece defesa em profundidade contra vulnerabilidades de Server-Side Request Forgery (SSRF). Cada ambiente de execução recebe seu próprio token gerado aleatoriamente, portanto, uma URL vazada ou adivinhada, por si só, não é suficiente para ler os metadados.
A resposta é imutável dentro de um ambiente de execução e retorna o cabeçalho Cache-Control: private, max-age=43200, immutable. Recomendamos que você armazene a resposta em cache e respeite o TTL, em vez de chamar o endpoint a cada invocação. Para funções com SnapStart, o TTL é reduzido durante a inicialização para que os clientes atualizem os metadados após a restauração, já que um ambiente de execução restaurado pode ser iniciado em uma AZ diferente. Para obter mais informações, consulte Comportamento dos metadados do Lambda SnapStart.
Obter o ID da AZ com o Powertools for AWS Lambda
A maneira mais direta de usar o endpoint é com o utilitário de metadados do Powertools for AWS Lambda, disponível para Python, TypeScript, Java e .NET. O utilitário armazena a resposta em cache após a primeira chamada e gerencia automaticamente a invalidação de cache do SnapStart, portanto, você não precisa gerenciar tokens, requisições HTTP ou TTLs por conta própria. Os exemplos a seguir mostram como usar o Powertools em cada linguagem.
Python
Instale o pacote do Powertools:
Use o utilitário de metadados no seu handler:
TypeScript
Instale o pacote do Powertools:
Use o utilitário de metadados no seu handler:
Java
Adicione a dependência do Powertools ao seu pom.xml:
Use o cliente de metadados no seu handler:
.NET
Instale o pacote do Powertools:
Use a classe de metadados no seu handler:
Chamar o endpoint de metadados diretamente
Se você usa um runtime personalizado, uma imagem de container ou prefere não adicionar uma dependência, pode chamar o endpoint diretamente usando as variáveis de ambiente que o Lambda define para você. O exemplo a seguir usa curl e jq para ler o ID da AZ:
Observe a configuração:
AWS_LAMBDA_METADATA_API: o Lambda define essa variável com o endereço do servidor de metadados, portanto, você nunca precisa fixar o host ou a porta no código.Authorization: Bearer ${AWS_LAMBDA_METADATA_TOKEN}: o token é obrigatório em toda requisição. Um token ausente ou inválido retorna401 Unauthorized.GETsomente: o endpoint aceita requisiçõesGET. Qualquer outro método retorna405 Method Not Allowed.
Ao chamar o endpoint diretamente, obtenha o ID da AZ uma vez durante a inicialização (fora do handler) e armazene-o em cache durante todo o ciclo de vida do ambiente de execução, em vez de chamar a cada invocação. Se sua função usa o SnapStart, atualize o valor após a restauração, pois o ambiente restaurado pode ser executado em uma AZ diferente.
Entender os IDs de zona de disponibilidade
O endpoint retorna um ID de AZ (por exemplo, use1-az1), e não um nome de AZ (por exemplo, us-east-1a). Antes de usá-lo, é útil saber ler o próprio ID. Um ID de AZ segue o padrão <region-code>-az<number>:
use1é o código abreviado da Região, neste caso US East 1 (us-east-1). Outras Regiões seguem a mesma convenção, comousw2para Oeste dos EUA (Oregon) eeuw1para Europa (Irlanda).az1identifica a zona de disponibilidade individual dentro dessa Região. Portanto,use1-az1deve ser lido como “zona de disponibilidade az1 em us-east-1”.
Essa distinção é importante. Os IDs de AZ sempre se referem ao mesmo local físico em todas as contas da AWS, enquanto os nomes de AZ podem corresponder a infraestruturas físicas diferentes em cada conta em determinadas Regiões. Em outras palavras, o nome us-east-1a na sua conta e o nome us-east-1a em outra conta podem apontar para duas zonas de disponibilidade físicas diferentes, mas use1-az1 é a mesma zona física em todas as contas. Não há mapeamento fixo entre um nome como us-east-1a e um ID como use1-az1. A AWS atribui os nomes de forma independente por conta para equilibrar os recursos entre as zonas. É exatamente por isso que o endpoint retorna o ID: comparar IDs de AZ permite verificar, de forma consistente e independente da conta, se a sua função e um recurso downstream compartilham a mesma zona de disponibilidade física. Para obter mais informações, consulte IDs de AZ para consistência entre contas.
Se você precisar do nome da AZ (por exemplo, para registro em log ou para uma API que espera um nome), converta o ID da AZ usando a API DescribeAvailabilityZones do Amazon Elastic Compute Cloud (Amazon EC2). Para chamá-la, adicione a permissão ec2:DescribeAvailabilityZones ao perfil de execução da sua função:
Rotear para recursos na mesma AZ
Obter o ID da AZ só é útil se você agir com base nele. O exemplo em Python a seguir mostra o padrão comum ilustrado na Figura 1: consultar o ID da AZ uma vez na inicialização, selecionar o endpoint de conexão que reside na mesma AZ e recorrer a uma alternativa de forma controlada quando não houver correspondência na mesma AZ.
Observe as escolhas de design:
- Resolva na inicialização:
AZ_IDeCACHE_ENDPOINTsão calculados uma vez por ambiente de execução, e não por invocação, de modo que a consulta de metadados e a seleção do endpoint não adicionam latência ao caminho da requisição. - Sempre forneça uma alternativa: se não houver um nó na AZ da sua função (por exemplo, o serviço não está implantado em todas as AZs em que a função é executada), recorra a qualquer endpoint disponível. O funcionamento correto não deve depender da existência de uma correspondência na mesma AZ.
- Compare IDs de AZ, não nomes: como o endpoint retorna IDs de AZ, e serviços como ElastiCache e RDS expõem a AZ de seus nós, você pode compará-los diretamente para tomar uma decisão confiável sobre a mesma AZ.
Além do roteamento com reconhecimento de latência, o mesmo ID de AZ viabiliza testes de resiliência. Você pode, por exemplo, injetar falhas apenas em funções executadas em uma AZ específica para validar que sua aplicação se degrada de forma controlada durante uma falha simulada de AZ, sem afetar o tráfego atendido por outras AZs.
Práticas recomendadas
Com base no comportamento do endpoint, tenha estas recomendações em mente:
- Armazene os metadados em cache: a resposta é imutável durante o ciclo de vida de um ambiente de execução. Leia-a uma vez na inicialização e reutilize-a. Se você chamar o endpoint diretamente, respeite o TTL de
Cache-Controlem vez de fazer requisições a cada invocação. - Trate o SnapStart corretamente: um ambiente restaurado do SnapStart pode ser retomado em uma AZ diferente daquela em que o snapshot foi criado. Atualize o ID da AZ após a restauração. O Powertools gerencia essa invalidação para você automaticamente.
- Ignore campos desconhecidos: campos adicionais podem ser incluídos na resposta no futuro. Faça o parsing de forma defensiva e não falhe se novos campos aparecerem.
- Degrade de forma controlada: trate o roteamento para a mesma AZ como uma otimização, não como um requisito. Mantenha sempre um caminho alternativo funcional para que sua função continue funcionando corretamente quando nenhum recurso na mesma AZ estiver disponível.
- Mantenha o token no lado do servidor: o
AWS_LAMBDA_METADATA_TOKENtem escopo limitado a um único ambiente de execução. Nunca o registre em log nem o encaminhe para fora da função.
Conclusão
Nesta publicação, você aprendeu como o endpoint de metadados do Lambda ajuda suas funções a descobrir a zona de disponibilidade em que são executadas. Com uma única requisição HTTP autenticada, ou uma chamada por meio do Powertools for AWS Lambda, sua função pode obter um ID de AZ estável e usá-lo para rotear para recursos na mesma AZ, reduzindo a latência entre AZs e a transferência de dados em caminhos de alto volume, e para criar padrões de resiliência com reconhecimento de AZ, como injeção de falhas direcionada. O recurso funciona em todos os runtimes, integra-se ao SnapStart, à simultaneidade provisionada e a funções conectadas a uma VPC, e está disponível sem custo adicional em todas as Regiões comerciais da AWS em que o Lambda é oferecido.
O principal aprendizado: se sua função Lambda lê ou grava em recursos com escopo de AZ, como ElastiCache ou RDS, em um caminho sensível à latência, obtenha o ID da AZ na inicialização, prefira o endpoint da mesma AZ e mantenha sempre uma alternativa. Você obtém uma latência menor e mais previsível, sem nenhuma mudança na forma como o Lambda gerencia a alta disponibilidade para você.
Para começar, consulte Usando o endpoint de metadados do Lambda no Guia do Desenvolvedor do AWS Lambda.
Recursos adicionais
- Usando o endpoint de metadados do Lambda.
- Powertools for AWS Lambda.
- IDs de AZ para consistência entre contas.
- API DescribeAvailabilityZones do Amazon EC2.
- AWS Lambda SnapStart.
Este conteúdo foi traduzido da publicação original do blog, que pode ser encontrada aqui.
Autor
 |
Daniel Abib é Arquiteto de Soluções Sênior e Especialista em Amazon Bedrock na AWS, com mais de 25 anos trabalhando com gerenciamento de projetos, arquiteturas de soluções escaláveis, desenvolvimento de sistemas e CI/CD, microsserviços, arquitetura Serverless & Containers e especialização em Machine Learning. Ele trabalha apoiando Startups, ajudando-os em sua jornada para a nuvem. https://www.linkedin.com/in/danielabib/ |
Tradutores
|
Daniel Abib é Arquiteto de Soluções Sênior e Especialista em Amazon Bedrock na AWS, com mais de 25 anos trabalhando com gerenciamento de projetos, arquiteturas de soluções escaláveis, desenvolvimento de sistemas e CI/CD, microsserviços, arquitetura Serverless & Containers e especialização em Machine Learning. Ele trabalha apoiando Startups, ajudando-os em sua jornada para a nuvem. https://www.linkedin.com/in/danielabib/ |
 |
Rodrigo Peres é Arquiteto de Soluções na AWS, com mais de 20 anos de experiência trabalhando com arquitetura de soluções, desenvolvimento de sistemas e modernização de sistemas legados. |