Amazon Web Services ブログ
Amazon OpenSearch Ingestion と Amazon RDS および Amazon Aurora の統合
数百万件のアイテムに対する強力な検索は、高い関連性を維持しつつ、高速かつ正確で、手軽に実現できるべきです。リレーショナルデータベースは構造化データの保存手段として広く普及しており、多くの組織がコアとなるビジネス情報の格納に活用しています。リレーショナルデータベースは構造化データの保存と取得に優れていますが、大量の非構造化テキストの検索には苦労することが多く、パフォーマンス上の理由から、通常はすべての列にインデックスを付けているわけではありません。
対照的に、OpenSearch などの検索エンジンはすべてのフィールドにインデックスを付けるため、セマンティック検索を含む豊富な検索機能や、数値データを要約・分析するための強力な集計機能を利用できます。従来、組織は検索インデックスをデータベースと最新の状態に保つために、ETL(抽出・変換・ロード)パイプラインを含む、複雑で非効率的、かつコストのかかるデータ同期プロセスを管理してきました。高度な検索機能でアプリケーションを強化したい場合、カスタムデータ同期プロセスを管理するオーバーヘッドなしに、データベースとの検索インデックスの同期を維持できる、よりシンプルなソリューションが求められます。
Amazon OpenSearch Service と Amazon Relational Database Service (Amazon RDS) および Amazon Aurora の統合が一般提供開始されたことを発表できることを嬉しく思います。この新しい統合により、複雑なデータパイプラインが不要になり、Amazon Aurora (Amazon Aurora MySQL 互換エディションおよび Amazon Aurora PostgreSQL 互換エディションを含む) および Amazon RDS データベース (Amazon RDS for MySQL および Amazon RDS for PostgreSQL を含む) と Amazon OpenSearch Service の間でニアリアルタイムのデータ同期が可能になります。トランザクションデータベース上でハイブリッド検索、ランク付き検索、ファセット検索などの高度な検索機能を活用できるようになります。データ同期を管理する代わりに、優れた顧客体験の創出に集中しながら、低レイテンシで高スループットの検索結果、リアルタイムの在庫更新、パーソナライズされたレコメンデーションなどを提供できるようになりました。この統合により、複雑な ETL パイプラインの維持にかかる運用負荷とコストが削減されるとともに、検索データを即座に利用できるようになります。
Amazon OpenSearch Ingestion は、Amazon Aurora または Amazon RDS と OpenSearch Service の間でニアリアルタイムのデータ同期を提供します。Aurora または RDS データベースを選択すれば、残りは OpenSearch Ingestion が処理します。Aurora MySQL または RDS for MySQL (8.0 以降)、Aurora PostgreSQL または RDS for PostgreSQL (16 以降) の両方をサポートします。
これらのサービスがどのように機能するかを以下に示します。
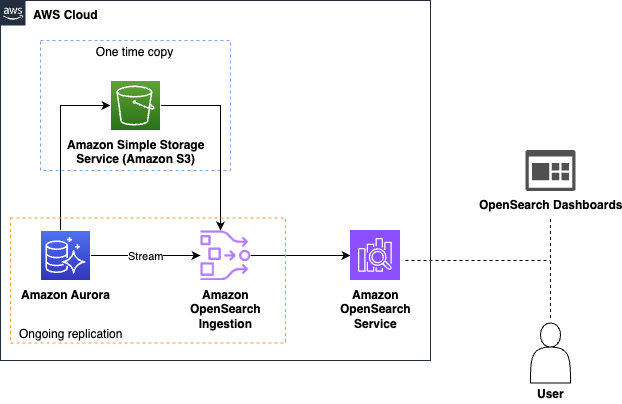
- データ取り込み – まず、Aurora または Amazon RDS が初期データを Amazon Simple Storage Service (Amazon S3) にエクスポートし、OpenSearch Ingestion がそのスナップショットを S3 からロードします。次に、Aurora または Amazon RDS の変更データキャプチャ (CDC) ストリームを使用して、以降の変更をニアリアルタイムでレプリケートし、OpenSearch Service にインデックスします。この自動化されたプロセスにより、データは OpenSearch 内で一貫して最新の状態に保たれ、手動による介入なしに検索と分析にすぐに利用できるようになります。
- リアルタイムクエリ – OpenSearch Service は、データに対して複雑な検索と集計を実行できる強力なクエリ機能を提供します。トレンドの分析、異常の検出、あるいはアプリケーションに検索結果を返すクエリの実行など、いずれのユースケースにも OpenSearch Service は必要なツールを提供します。
次の図は、Amazon Aurora をソースとした場合のソリューションアーキテクチャを示しています。
データベースソースの構成
同期を設定する前に、ソースデータベースのロギング設定を行う必要があります。Aurora MySQL の場合は、クラスターパラメータグループで拡張バイナリログ設定を有効にします。Amazon RDS の場合は、インスタンスパラメータグループの設定を通じて、基本的なバイナリロギングまたは論理レプリケーションを有効にします。これらのロギング設定により、OpenSearch Ingestion はデータベースからの変更をキャプチャしてレプリケートできるようになります。
Aurora MySQL のサンプル HR データベースは、この統合がどのように機能するかを示す良いサンプルです。
ビューを作成する前に、OpenSearch がこのデータをどのように表現するかを説明します。OpenSearch マッピングは、ドキュメントとそのフィールドの保存・インデックス方法を定義するもので、データベーススキーマがテーブルと列を定義するのと同様の役割を果たします。OpenSearch Ingestion パイプラインはデフォルトで動的マッピングを使用し、Aurora または Amazon RDS のデータ型を適切な OpenSearch フィールド型に自動的に変換します。例えば、データベースの DATE フィールドは OpenSearch の日付型になり、数値フィールドは対応する OpenSearch の数値型にマッピングされます。インデックステンプレートを使用してマッピングをカスタマイズすることも可能ですが、デフォルトのマッピングは通常、日付、数値、テキストフィールドなどの一般的なデータ型を正しく処理します。
GET employees/_mapping
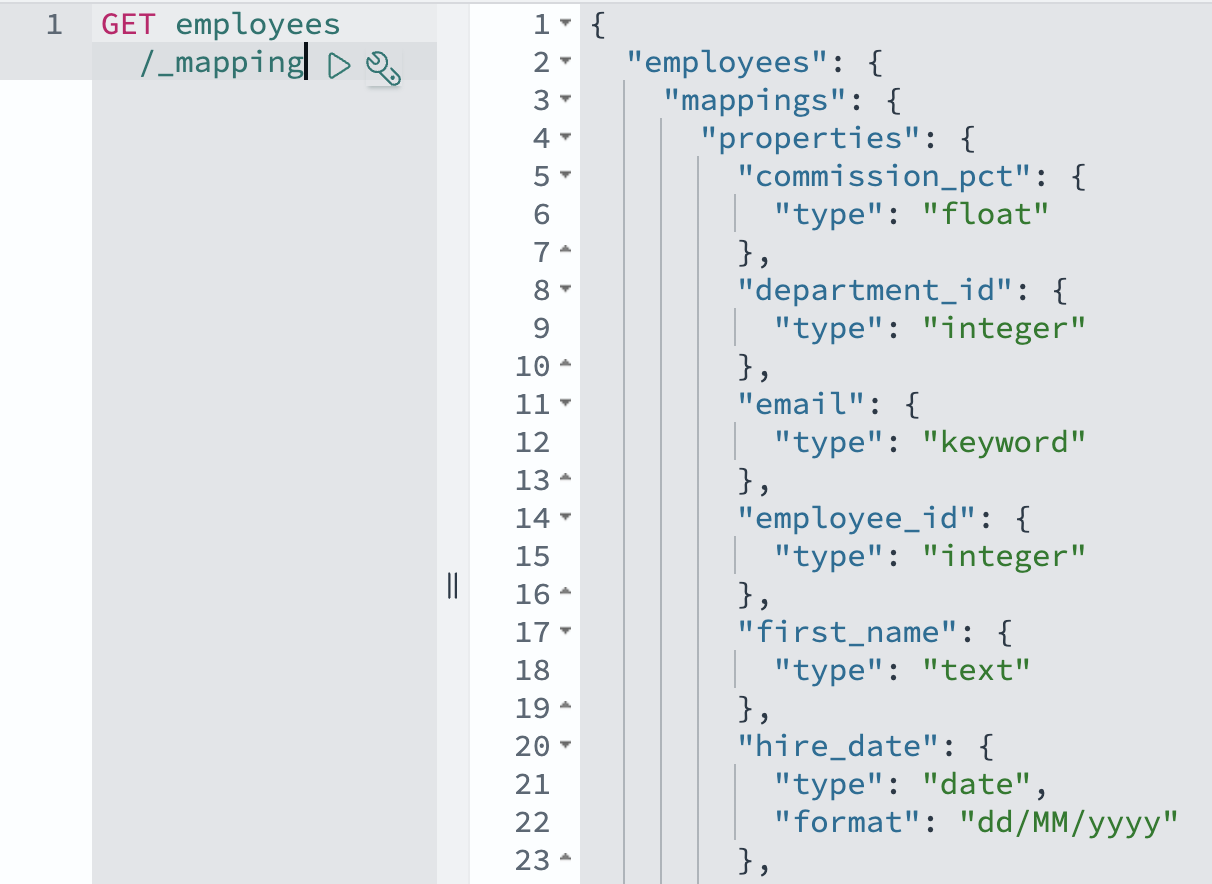
この統合が複雑なデータリレーションシップを処理できることを示すために、OpenSearch Ingestion が結合されたデータをどのように扱うかを見ていきましょう。サンプル HR データベースにビューを作成し、複数の関連テーブルからの情報を OpenSearch 内の単一の検索可能なドキュメントに統合します。このアプローチは、正規化されたデータベース構造を、検索操作に最適化された非正規化ドキュメントに変換する方法を示しています。
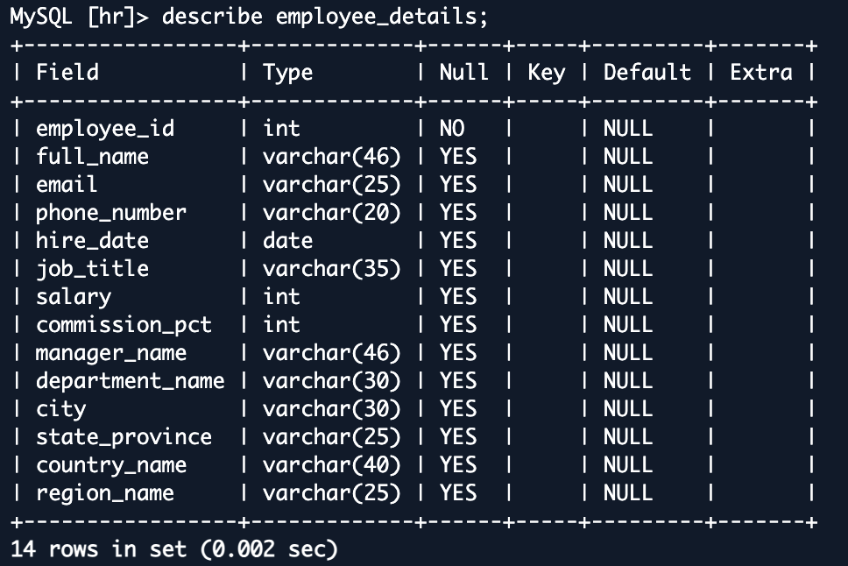
この employee_details ビューは、複数テーブルからのデータを統合し、豊富で非正規化された従業員情報を表現しています。OpenSearch Ingestion パイプラインは、ビュー (MySQL ベースのソースの場合) またはビューとマテリアライズドビュー (PostgreSQL ベースのソースの場合) の取り込みをサポートしていないことに注意してください。論理レプリケーションシステムの制限により、パイプラインは基盤となるベーステーブルからの変更のみを追跡します。したがって、ビュー自体は取り込めないため、ビューで定義したカラム構成を参考に、基盤となるベーステーブルをレプリケートするようにパイプラインを構成します。これにより、OpenSearch 上では各従業員が単一の包括的なドキュメントとして表現されます。この構造により、元々は別々だったテーブルにまたがる高速で複雑なクエリが可能になります。例えば、特定の部門や国の従業員を検索したり、地域間の給与分布を分析したりするなど、正規化されたデータベース構造では複雑で遅くなるクエリを簡単に実行できます。
次のスクリーンショットに示すパイプライン構成では、OpenSearch Ingestion が HR データベースに接続し、ソースデータベースとレプリケート対象のベーステーブルを識別する様子を確認できます。ビュー (および PostgreSQL ベースのソースでのマテリアライズドビュー) は取り込みソースとしてサポートされていないため、パイプラインはビュー自体ではなく、基盤となるベーステーブルからの変更を追跡します。OpenSearch Ingestion はこれらの関係を自動的に維持するため、これらのテーブルへの変更が OpenSearch インデックスに反映され、検索データがソースデータベースと一貫性を保つようになります。
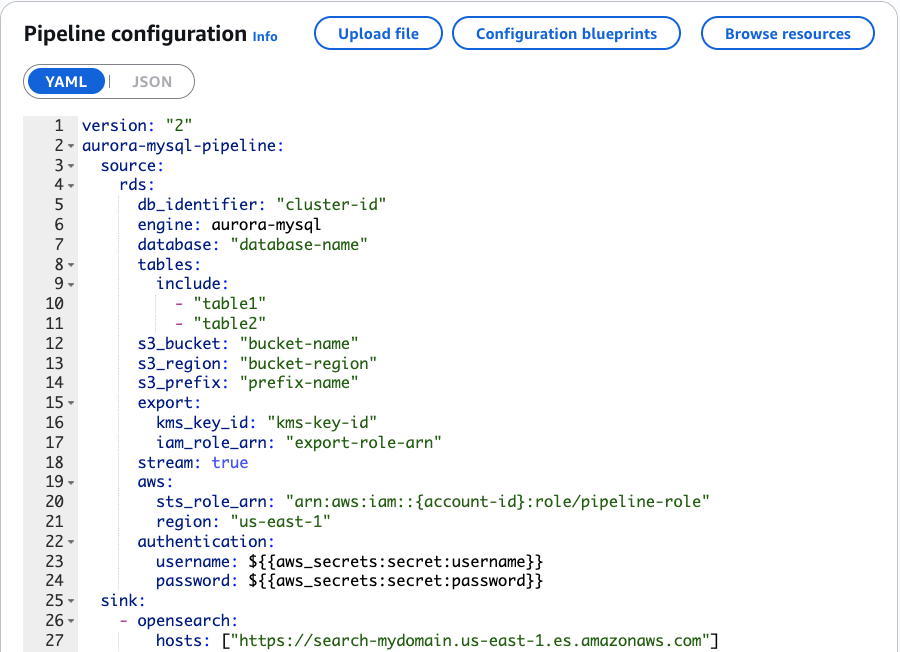
以下に示す GIF では、OpenSearch Ingestion のビジュアルエディタを使用してこの統合を設定するデモを確認できます。
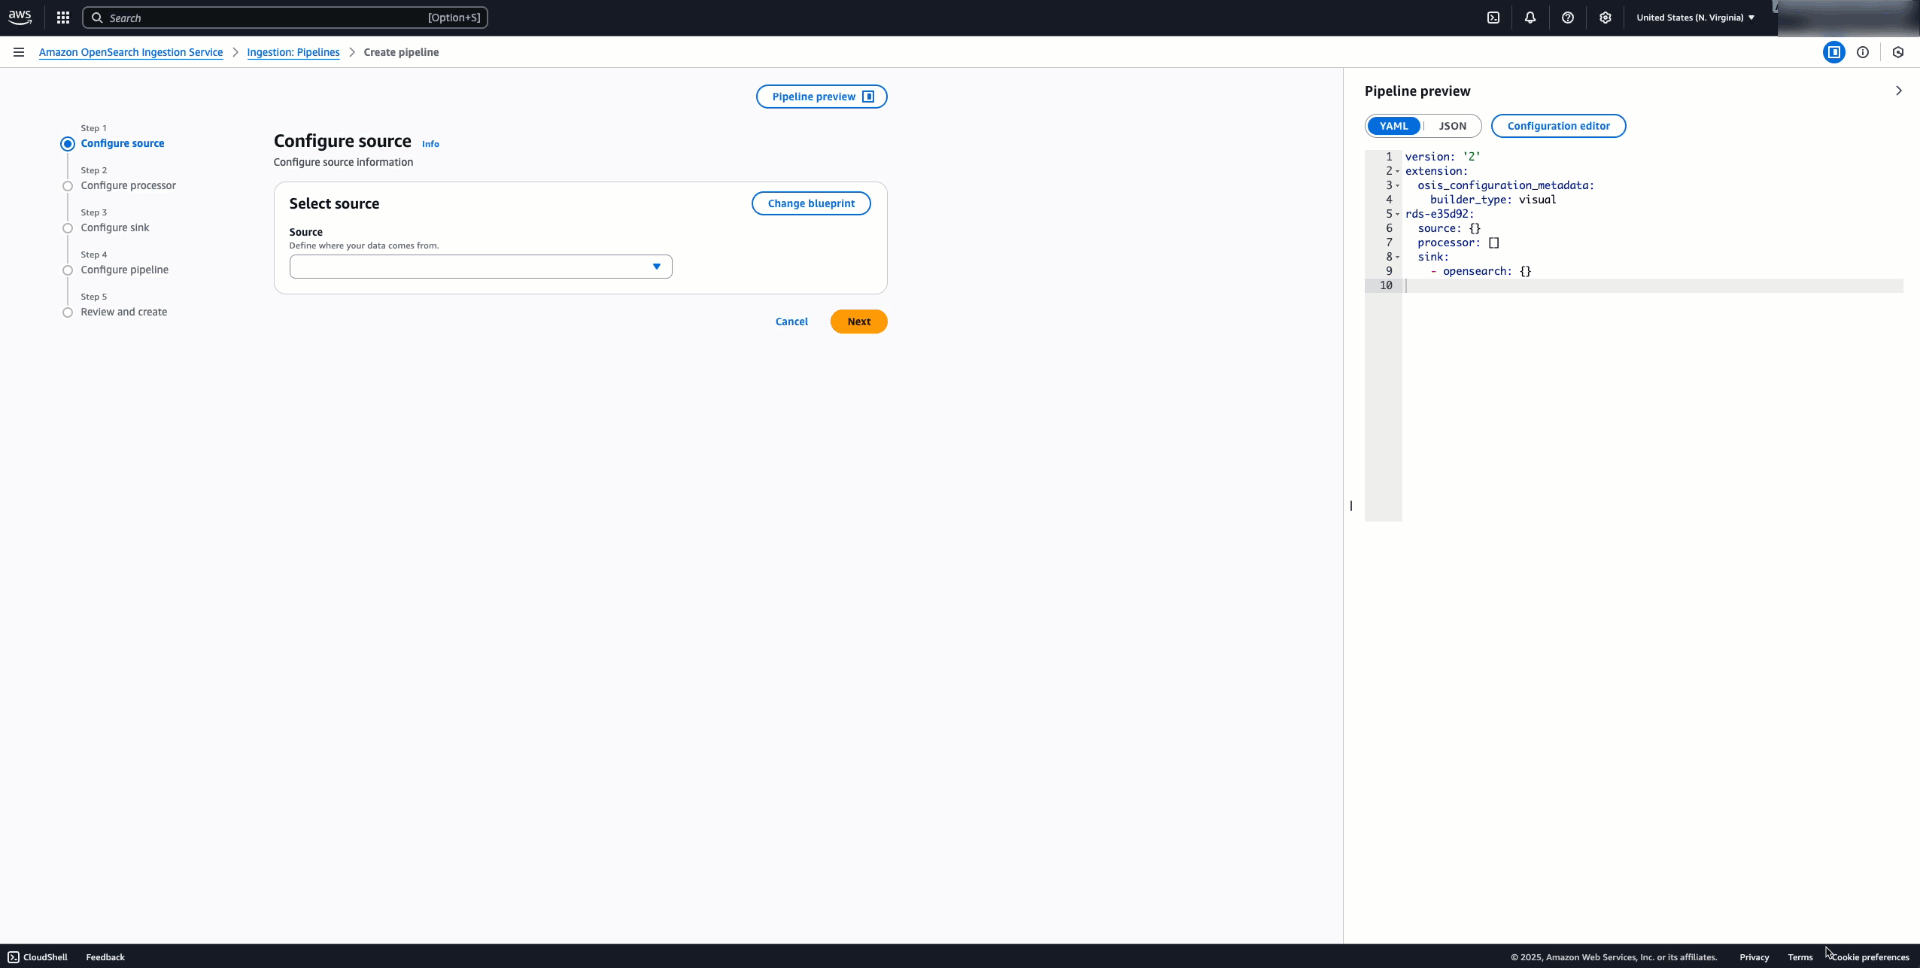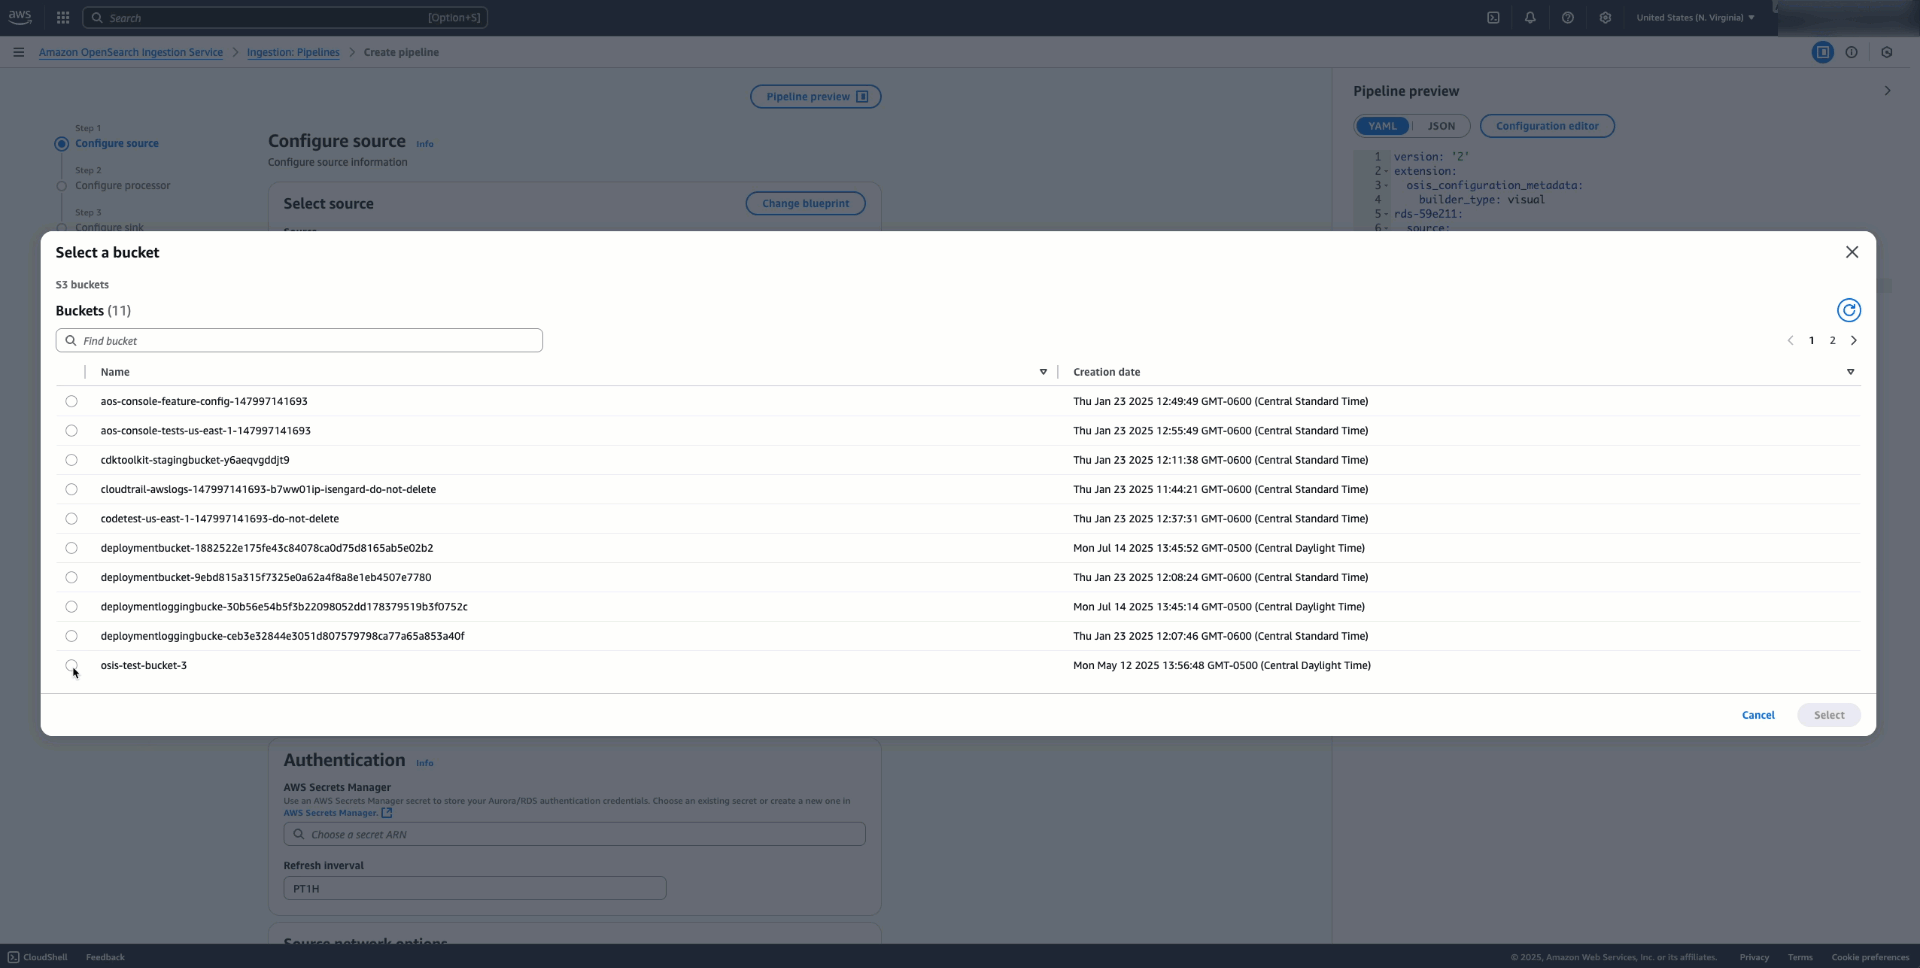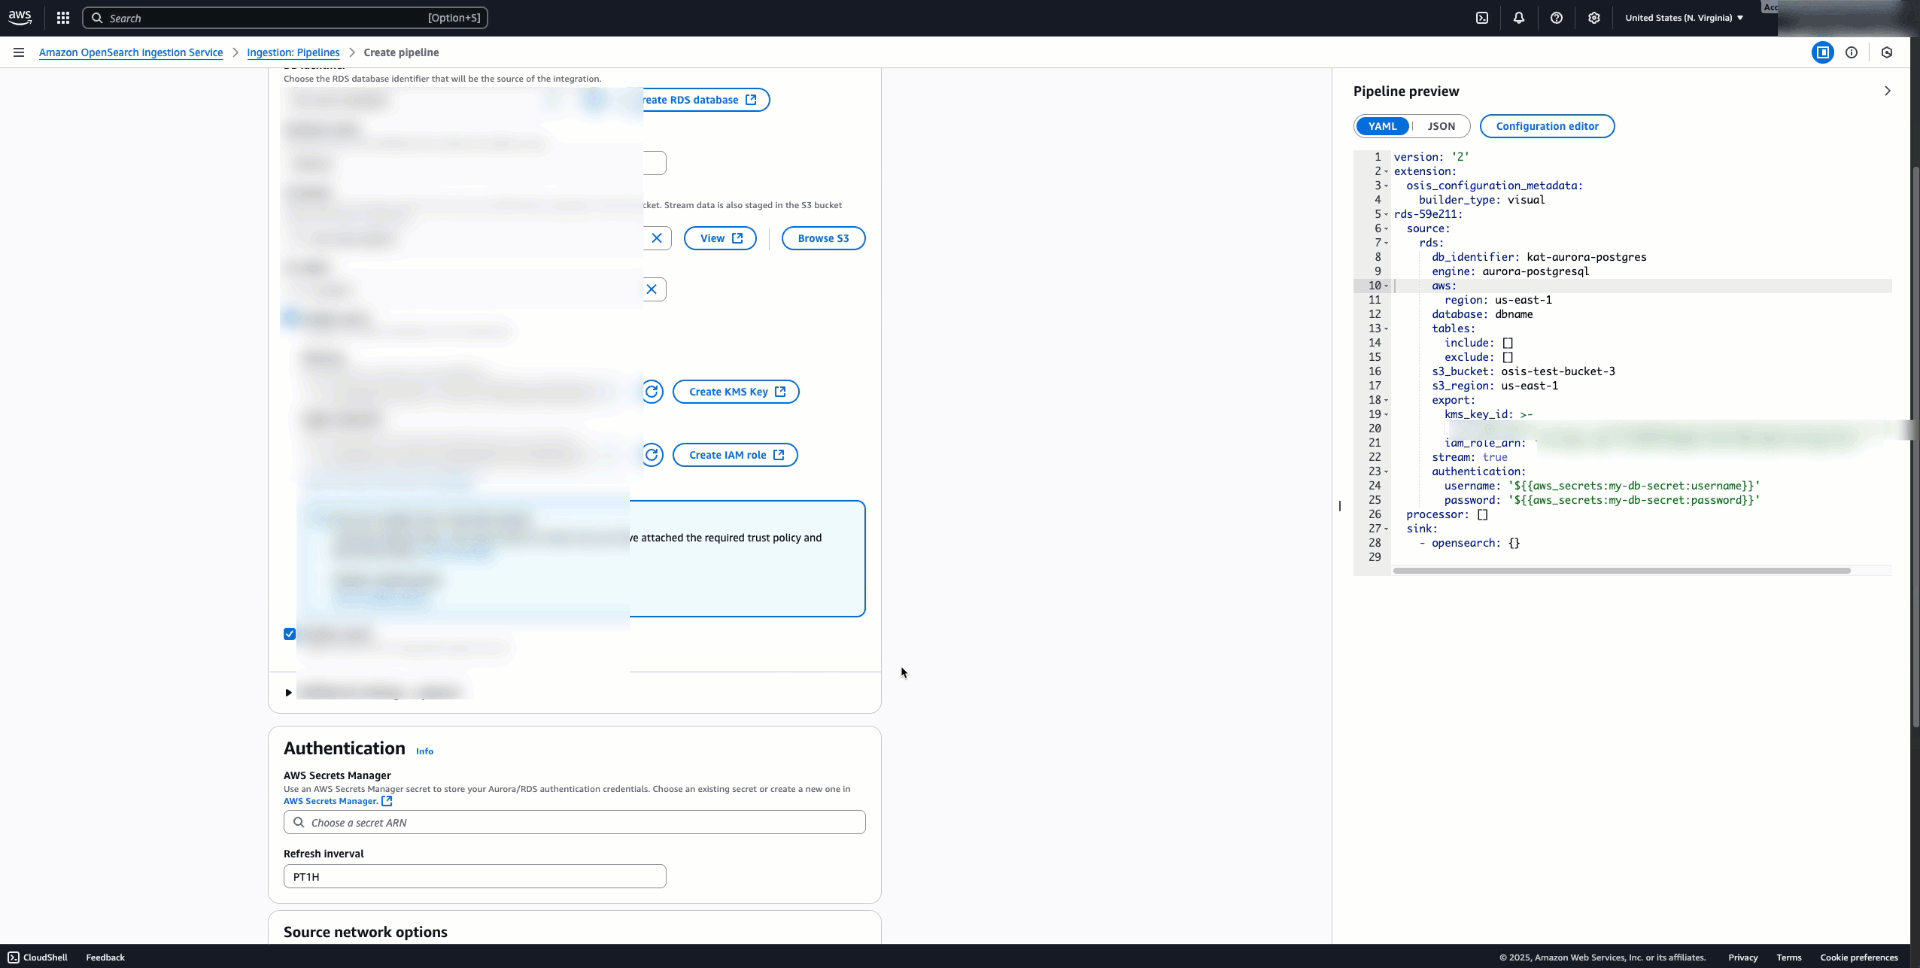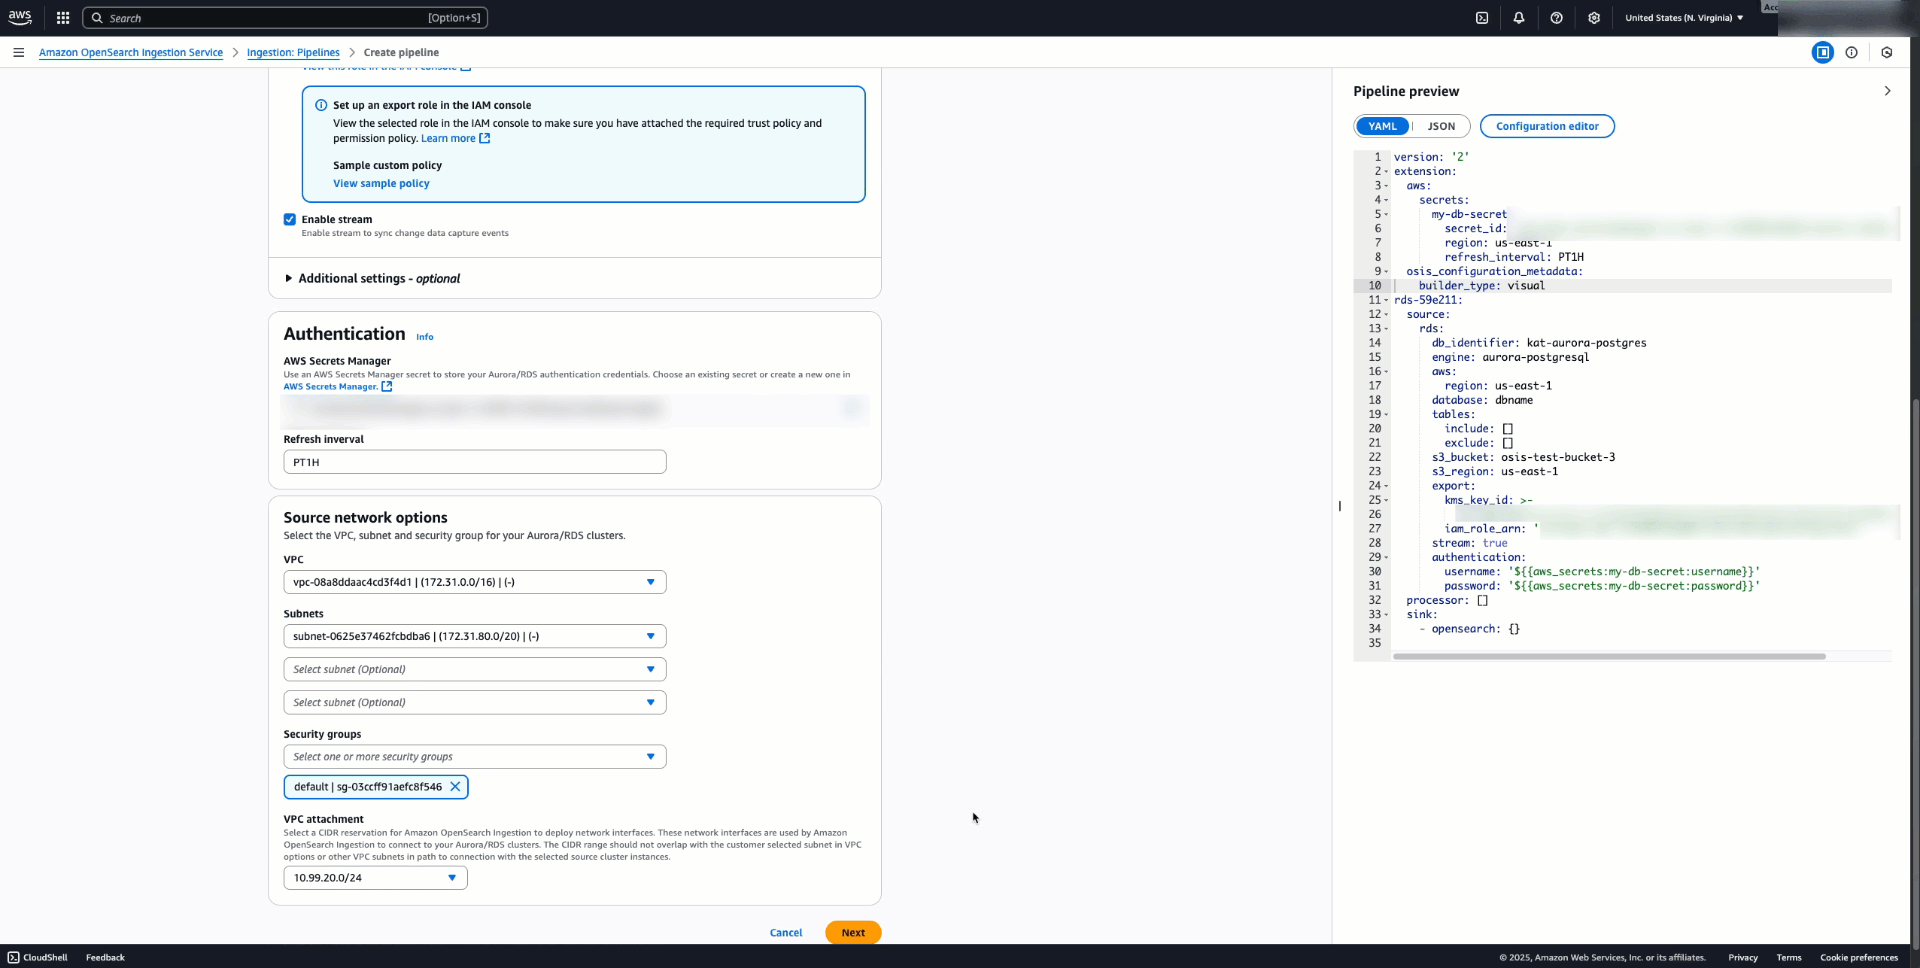
また、インデックスマッピングテンプレートを指定して、Aurora または Amazon RDS のフィールドを OpenSearch Service インデックスの適切なフィールドにマッピングすることもできます。
パイプラインの包括的な設定概要については、OpenSearch Data Prepper のドキュメントを参照してください。パイプラインには AWS Identity and Access Management (IAM) ロールを設定する必要があります。手順については、パイプラインロールの構成を参照してください。
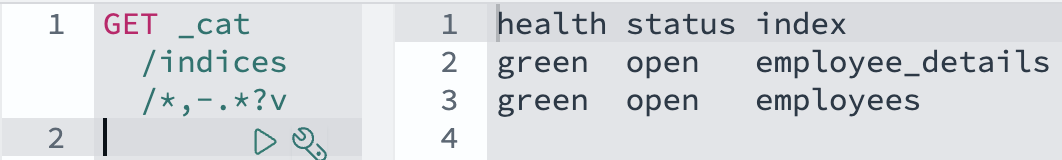
OpenSearch Ingestion で統合を構成すると、パイプラインは OpenSearch Dashboards で表示できるインデックスを自動的に作成します。OpenSearch Ingestion はまず、Aurora または Amazon RDS データベースの Amazon S3 への自動エクスポートをトリガーし、次に S3 からこのスナップショットデータを OpenSearch クラスターにロードして初期インデックスを作成します。この初期ロードの後、OpenSearch Ingestion は MySQL ベースのデータベースの場合はバイナリログ (binlog)、PostgreSQL ベースのデータベースの場合は先行書き込みログ (WAL) を使用して変更を継続的にキャプチャします。これにより、OpenSearch インデックスはソースデータベースとニアリアルタイムで同期された状態を保ちます。以下を呼び出すことで、OpenSearch Dashboards でインデックスを表示できます。
GET _cat/indices
レスポンスの例:
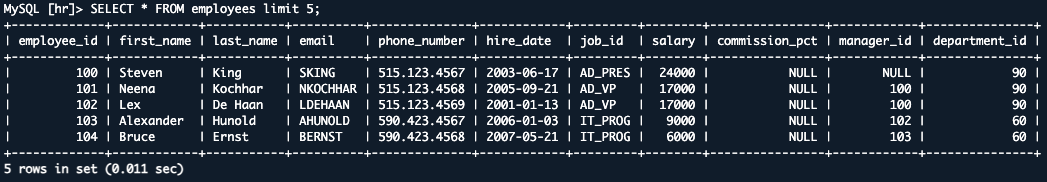
employee テーブルの最初の 5 つのエントリを考えてみましょう。
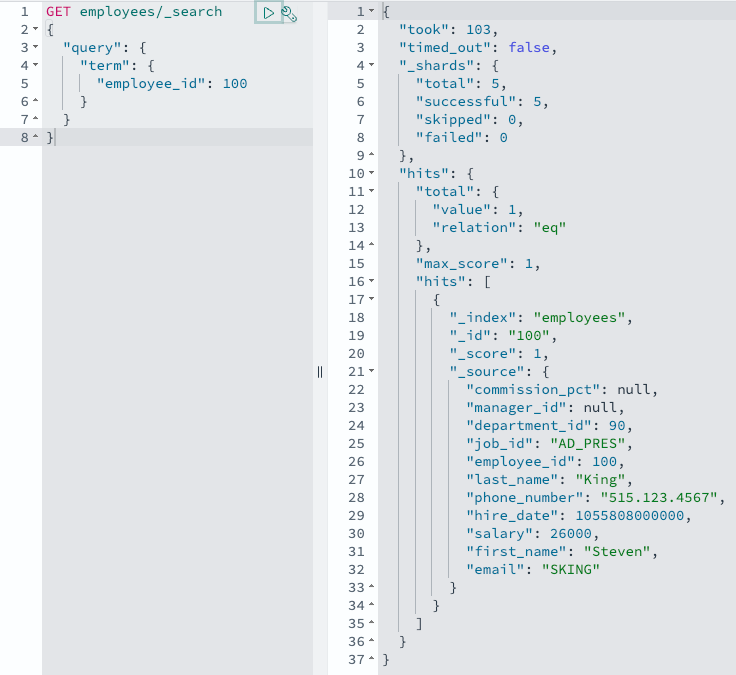
データベースに変更を加えると、OpenSearch Ingestion は変更データで Amazon OpenSearch Service を更新します。例えば、次のコードは従業員の給与を更新します。
UPDATE hr.employees SET SALARY = 26000 WHERE EMPLOYEE_ID = 100;

Amazon Aurora が変更通知を送信し、OpenSearch Ingestion パイプラインがそれを取得して、OpenSearch Ingestion が変更されたレコードをニアリアルタイムで OpenSearch に送信します。これは OpenSearch クエリで確認できます。
GET employees/_search
この機能に関する重要な詳細:
- モニタリング – CloudWatch メトリクスと OpenSearch Ingestion ダッシュボードを通じて、パイプラインのパフォーマンスとデータ同期を追跡します
- 制限事項: 同一リージョンおよび同一アカウントでのデプロイが必須で、最適な同期のためにプライマリキーが必要です。現在、データ定義言語 (DDL) ステートメントのサポートはなく、ビュー (MySQL) またはビューとマテリアライズドビュー (PostgreSQL) の取り込みはサポートされていません。論理レプリケーションシステムを通じて追跡されるのはベーステーブルのみです
Amazon Aurora または Amazon RDS と Amazon OpenSearch Service の統合は、OpenSearch Ingestion が利用可能なすべての AWS リージョンで一般提供開始されました。
詳細については、Aurora または Amazon RDS と Amazon OpenSearch Service の統合に関する AWS ドキュメントを参照してください。
- Using an OpenSearch Ingestion pipeline with Amazon Aurora – Amazon OpenSearch Service
- Using an OpenSearch Ingestion pipeline with Amazon RDS – Amazon OpenSearch Service
About the authors
 Michael Torio は、カリフォルニア州マウンテンビューを拠点とし、Amazon OpenSearch Service を専門とする AWS のアソシエイトスペシャリストソリューションアーキテクトです。Michael は、お客様がクラウドテクノロジーを活用してビジネス上の課題を解決するためのサポートに取り組んでいます。
 Sohaib Katariwala は、イリノイ州シカゴを拠点とし、Amazon OpenSearch Service を専門とする AWS のシニアスペシャリストソリューションアーキテクトです。彼の関心はデータと分析に関するあらゆるものにあります。お客様がデータ戦略の中で AI を活用して現代の課題を解決するためのサポートに喜びを感じています。
 Arjun Nambiar は、Amazon OpenSearch Service のプロダクトマネージャーです。彼は、さまざまなソースからのデータを大規模に Amazon OpenSearch Service に取り込むことを可能にする取り込みテクノロジーに注力しています。Arjun は大規模分散システムとクラウドを中心としたテクノロジーに関心があり、ワシントン州シアトルを拠点としています。
原文はこちらです。