Amazon Web Services ブログ
国内大手製造業のグローバル製品サポートを支える Amazon Bedrock AgentCore Runtime V2
グローバルに製品を展開する企業にとって、利用者が普段使っている言語で製品の使い方に答えるサポートの提供は共通の課題です。対応する言語が増えるほど、すべての言語で問い合わせに応じる体制を整えることは難しくなります。
この課題を解決する手段の一つが、生成 AI を活用したサポートチャットです。利用者の質問に関連する情報をオンラインマニュアルから検索し、その内容を根拠に回答を生成することで、利用者の言語で製品の使い方を案内できます。
ただし、このようなサポートチャットでは、回答の正確さに加えて、回答までの速さも利用者の体験を大きく左右します。多言語のマニュアルを扱う場合、検索基盤の容量や運用負荷を抑えるために索引を特定の言語に絞ると、質問の翻訳や対象言語の本文取得といった処理が増え、待ち時間が伸びやすくなります。また、利用者の多くは製品を操作している途中で分からない点に直面し、その場で解決したいと考えてチャットを開きます。最初の質問に続けて利用環境などの条件を補足するやり取りも多く、1 回ごとの待ち時間が積み重なるほど、解決までの体験は損なわれます。
本記事では、30 以上の言語で製品のオンラインマニュアルを提供する国内の大手製造業のお客様と AWS が取り組んだ、製品サポートチャットの開発事例を紹介します。このサービスは既に提供を開始しており、オンラインマニュアルから質問に関連する情報を探し、その内容を根拠に回答します。
製品の使い方に答えるサポートチャット
今回のサポートチャットは、製品を使う方がオンラインマニュアルに基づく回答を得るための、提供開始済みのサービスです。利用者向けアプリケーションの機能として、事前に定義した Q&A に沿って進む固定シナリオと、利用者が自由に質問を入力する AI チャットを提供しています。
固定シナリオでは、あらかじめ用意した案内に沿って操作を進めます。一方で AI チャットでは、入力された質問から関連するマニュアルを検索し、その内容を根拠に回答を生成します。この 2 つの機能を組み合わせ、定型的な案内と、自由入力による問い合わせの両方に対応しています。
AI チャットの設計における主な要件は、次の 3 点です。
- 応答時間:
- 質問の翻訳、検索、文書取得、回答生成を含むアプリケーションの応答時間を 10 秒以内に収める要件がありました。新しい実行環境が必要な場合には、その起動も待ち時間に関わります。
- 会話文脈の保持:
- 利用者が最初に使い方を質問し、続けて利用環境などの条件を補足する場面もあります。同一セッション内のやり取りを保持し、追加された条件を前の質問と合わせて扱うことが、会話を継続するための要件です。
- 多言語対応:
- 30 以上の言語に対応しています。言語別のオンラインマニュアルを回答に使う一方、検索基盤の容量を考慮し、索引に取り込む文書は英語のマニュアルに絞っています。そのため、利用者の質問を検索できる形に変換し、見つかった文書から対象言語の本文を取得する処理が必要でした。
これらの要件を踏まえ、モデルの選択と検索処理の組み立てに加え、実行環境の準備と会話情報の扱いを含めて設計しました。
ソリューションの全体構成
図 1 に、Amazon Bedrock AgentCore (以下 AgentCore) を使ったサポートチャットの主な構成を示します。
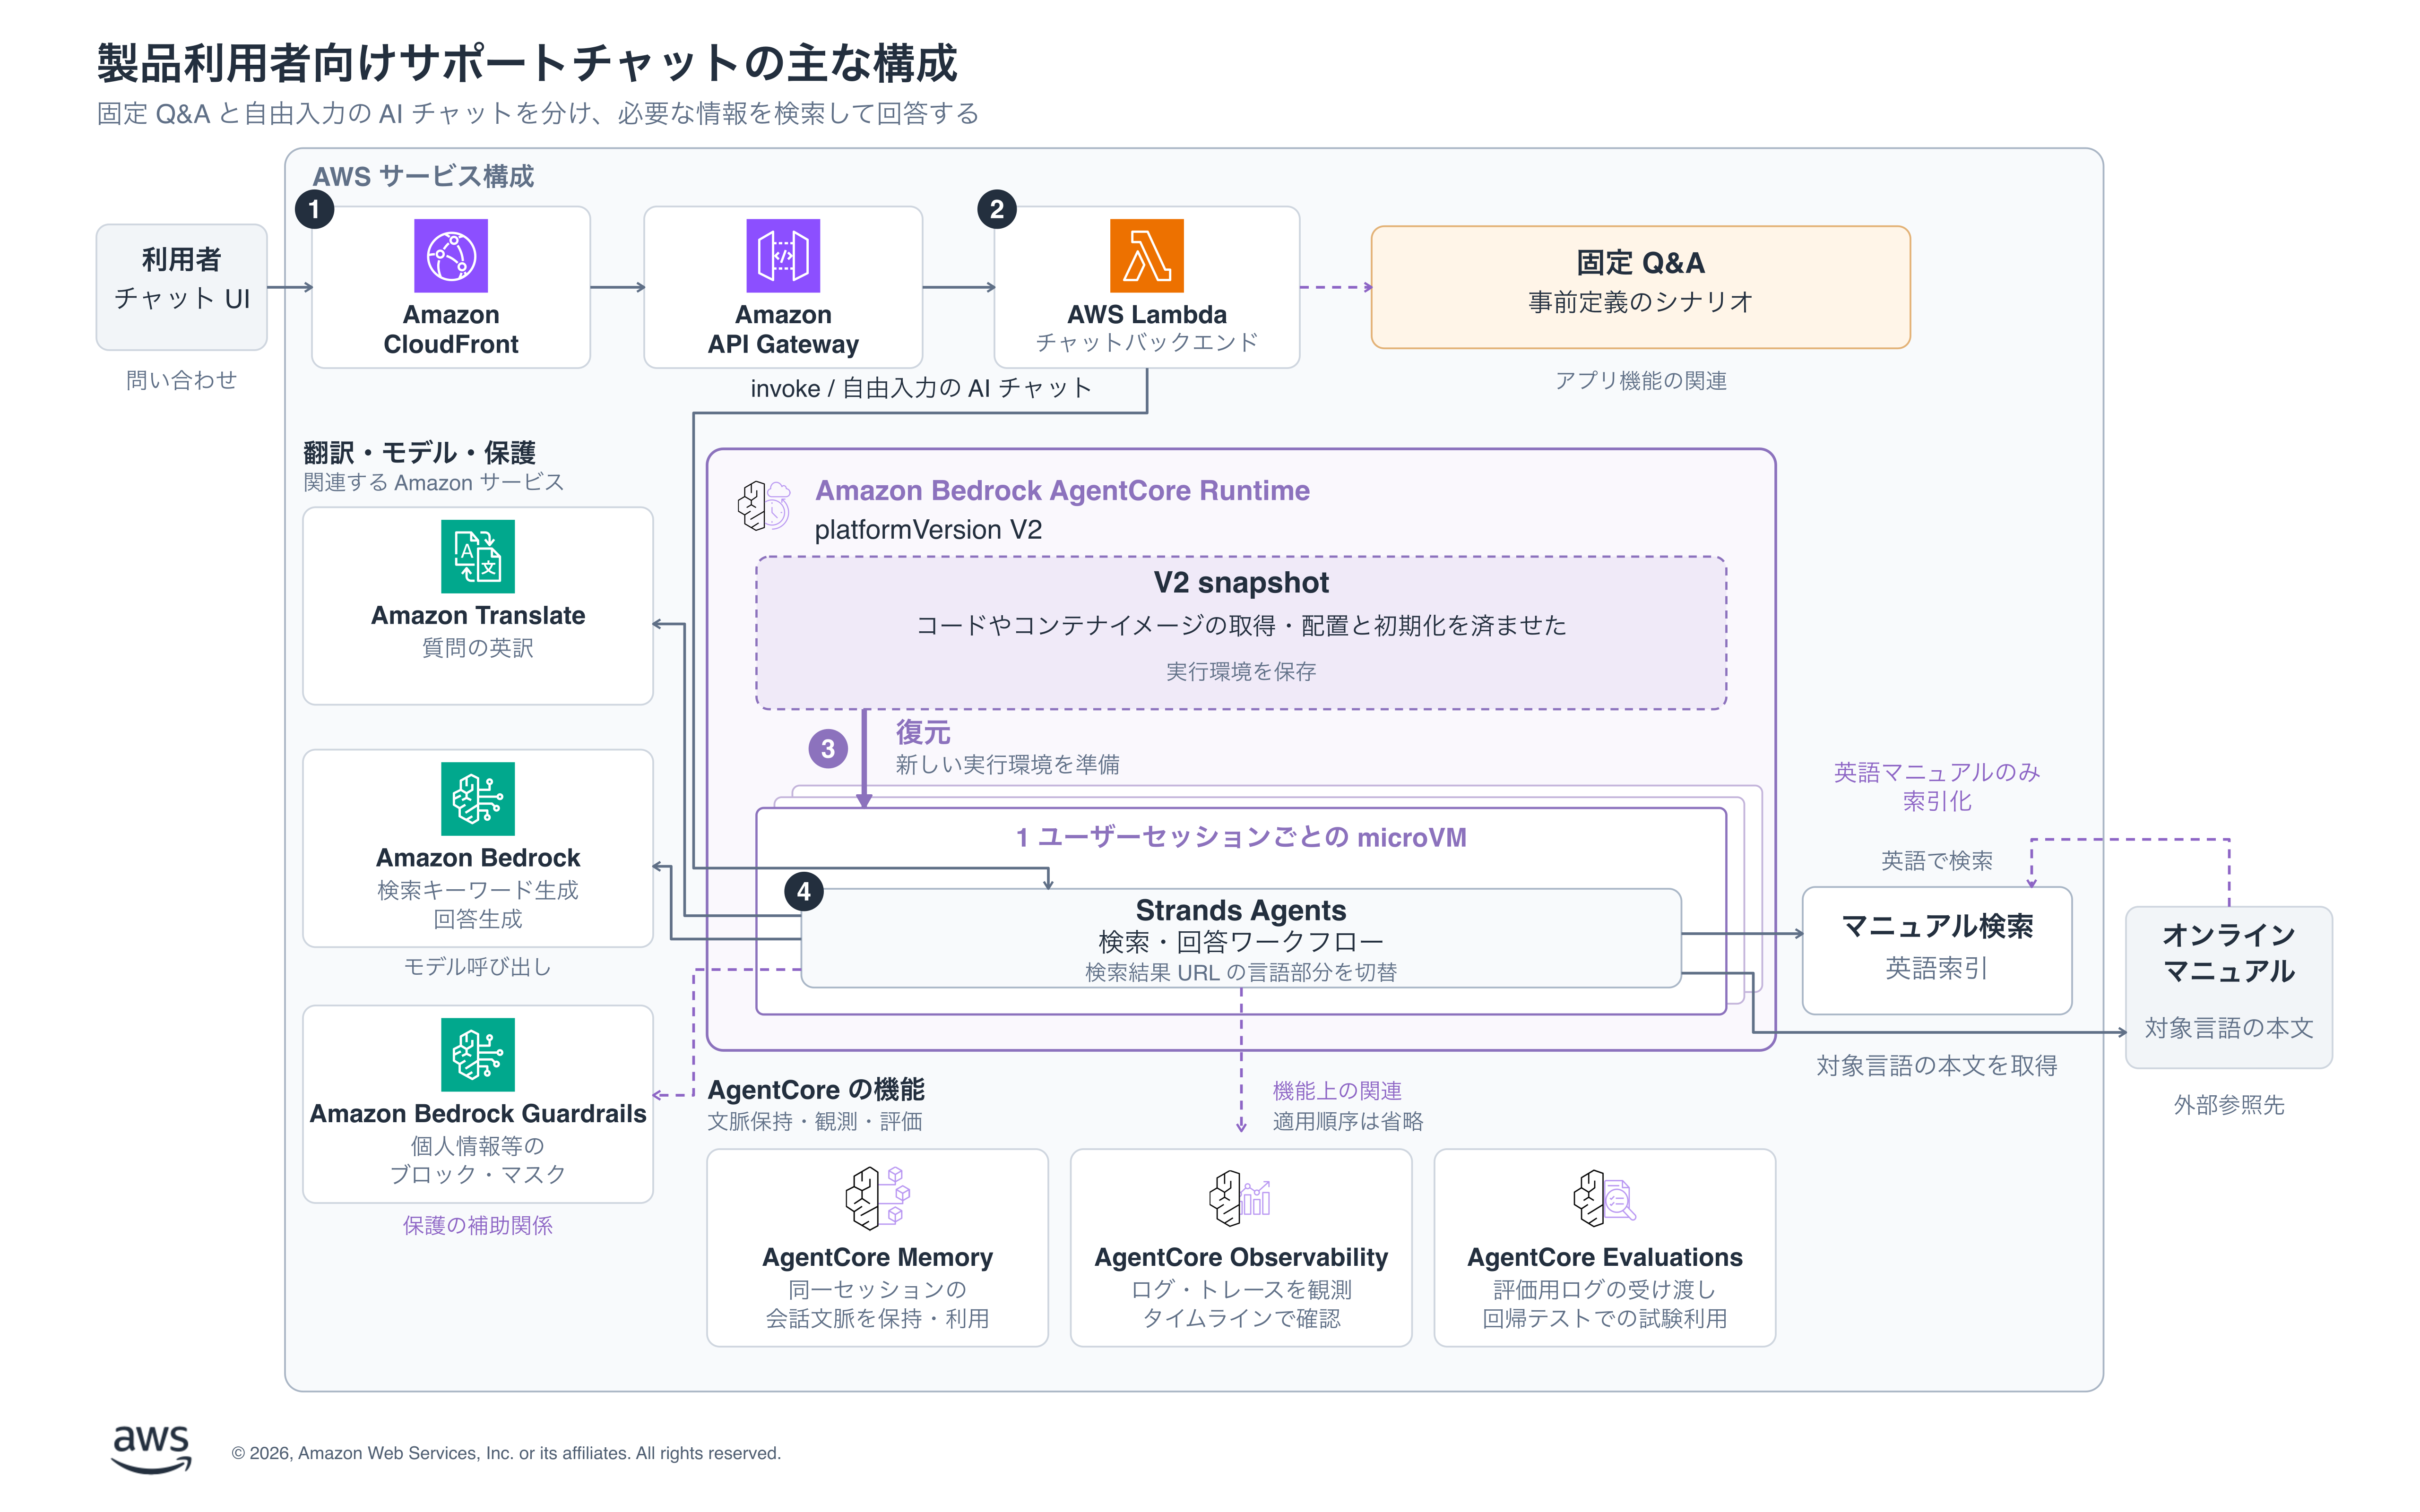
図 1. 製品利用者向けサポートチャットの主な構成。
図中の番号に沿って、問い合わせの受付から検索・回答までの役割を説明します。
- ステップ 1: 利用者のアプリケーションからの問い合わせを、Amazon CloudFront と Amazon API Gateway を経由して受け付けます。
- ステップ 2: AWS Lambda で実装したチャットバックエンドが、事前定義のシナリオを使う固定 Q&A と、自由入力の AI チャットを振り分けます。自由入力の場合は AgentCore Runtime を呼び出します。
- ステップ 3: 新しい実行環境が必要な場合は、AgentCore Runtime V2 が初期化済み環境のスナップショットから復元し、セッション用の microVM を準備します。復元対象は実行環境であり、会話データではありません。
- ステップ 4: AgentCore Runtime 内の microVM で動く Strands Agents が、マニュアルの検索と回答生成のワークフローを実行します。
英語の索引を用いた検索と対象言語の本文に基づく回答
ステップ 4 の処理を、日本語の質問を例に見ていきます。Strands Agents のワークフローは、Amazon Translate で質問を英訳し、Amazon Bedrock の検索用モデルを呼び出して検索キーワードを生成します。そのキーワードで、英語版マニュアルだけを取り込んだ索引を検索します。
検索結果から得るのは、英語版マニュアルの URL です。ワークフローは、その URL に含まれる言語部分を日本語へ切り替え、オンラインマニュアルから対応する日本語版の本文を取得します。図中のマニュアル検索は必要な文書を見つけるための検索基盤、オンラインマニュアルは対象言語の本文を取得する参照先という役割です。
取得した日本語の本文を根拠として、検索キーワードの生成とは別の Amazon Bedrock のモデルで回答を生成します。検索キーワード生成に Amazon Nova 2 Lite、回答生成に Claude Haiku 4.5 を使用しました。検索用と回答用のモデルを使い分け、必要な文書を探す処理と、その文書を基に利用者へ説明を返す処理を分担させています。
Strands Agents がこの一連の処理をつなぐことで、英語の索引で文書を探し、利用者の言語の本文を根拠に回答するワークフローを実現しています。
Amazon Bedrock AgentCore の採用理由
PoC から本番運用へ進むには、エージェントロジックに加え、セッションごとの実行環境の分離や認証・認可、会話管理、回答品質の評価も検討する必要がありました。AgentCore は、実行基盤の AgentCore Runtime、会話情報を扱う AgentCore Memory、評価を行う AgentCore Evaluations などをマネージドで提供し、こうした開発・運用を支援します。
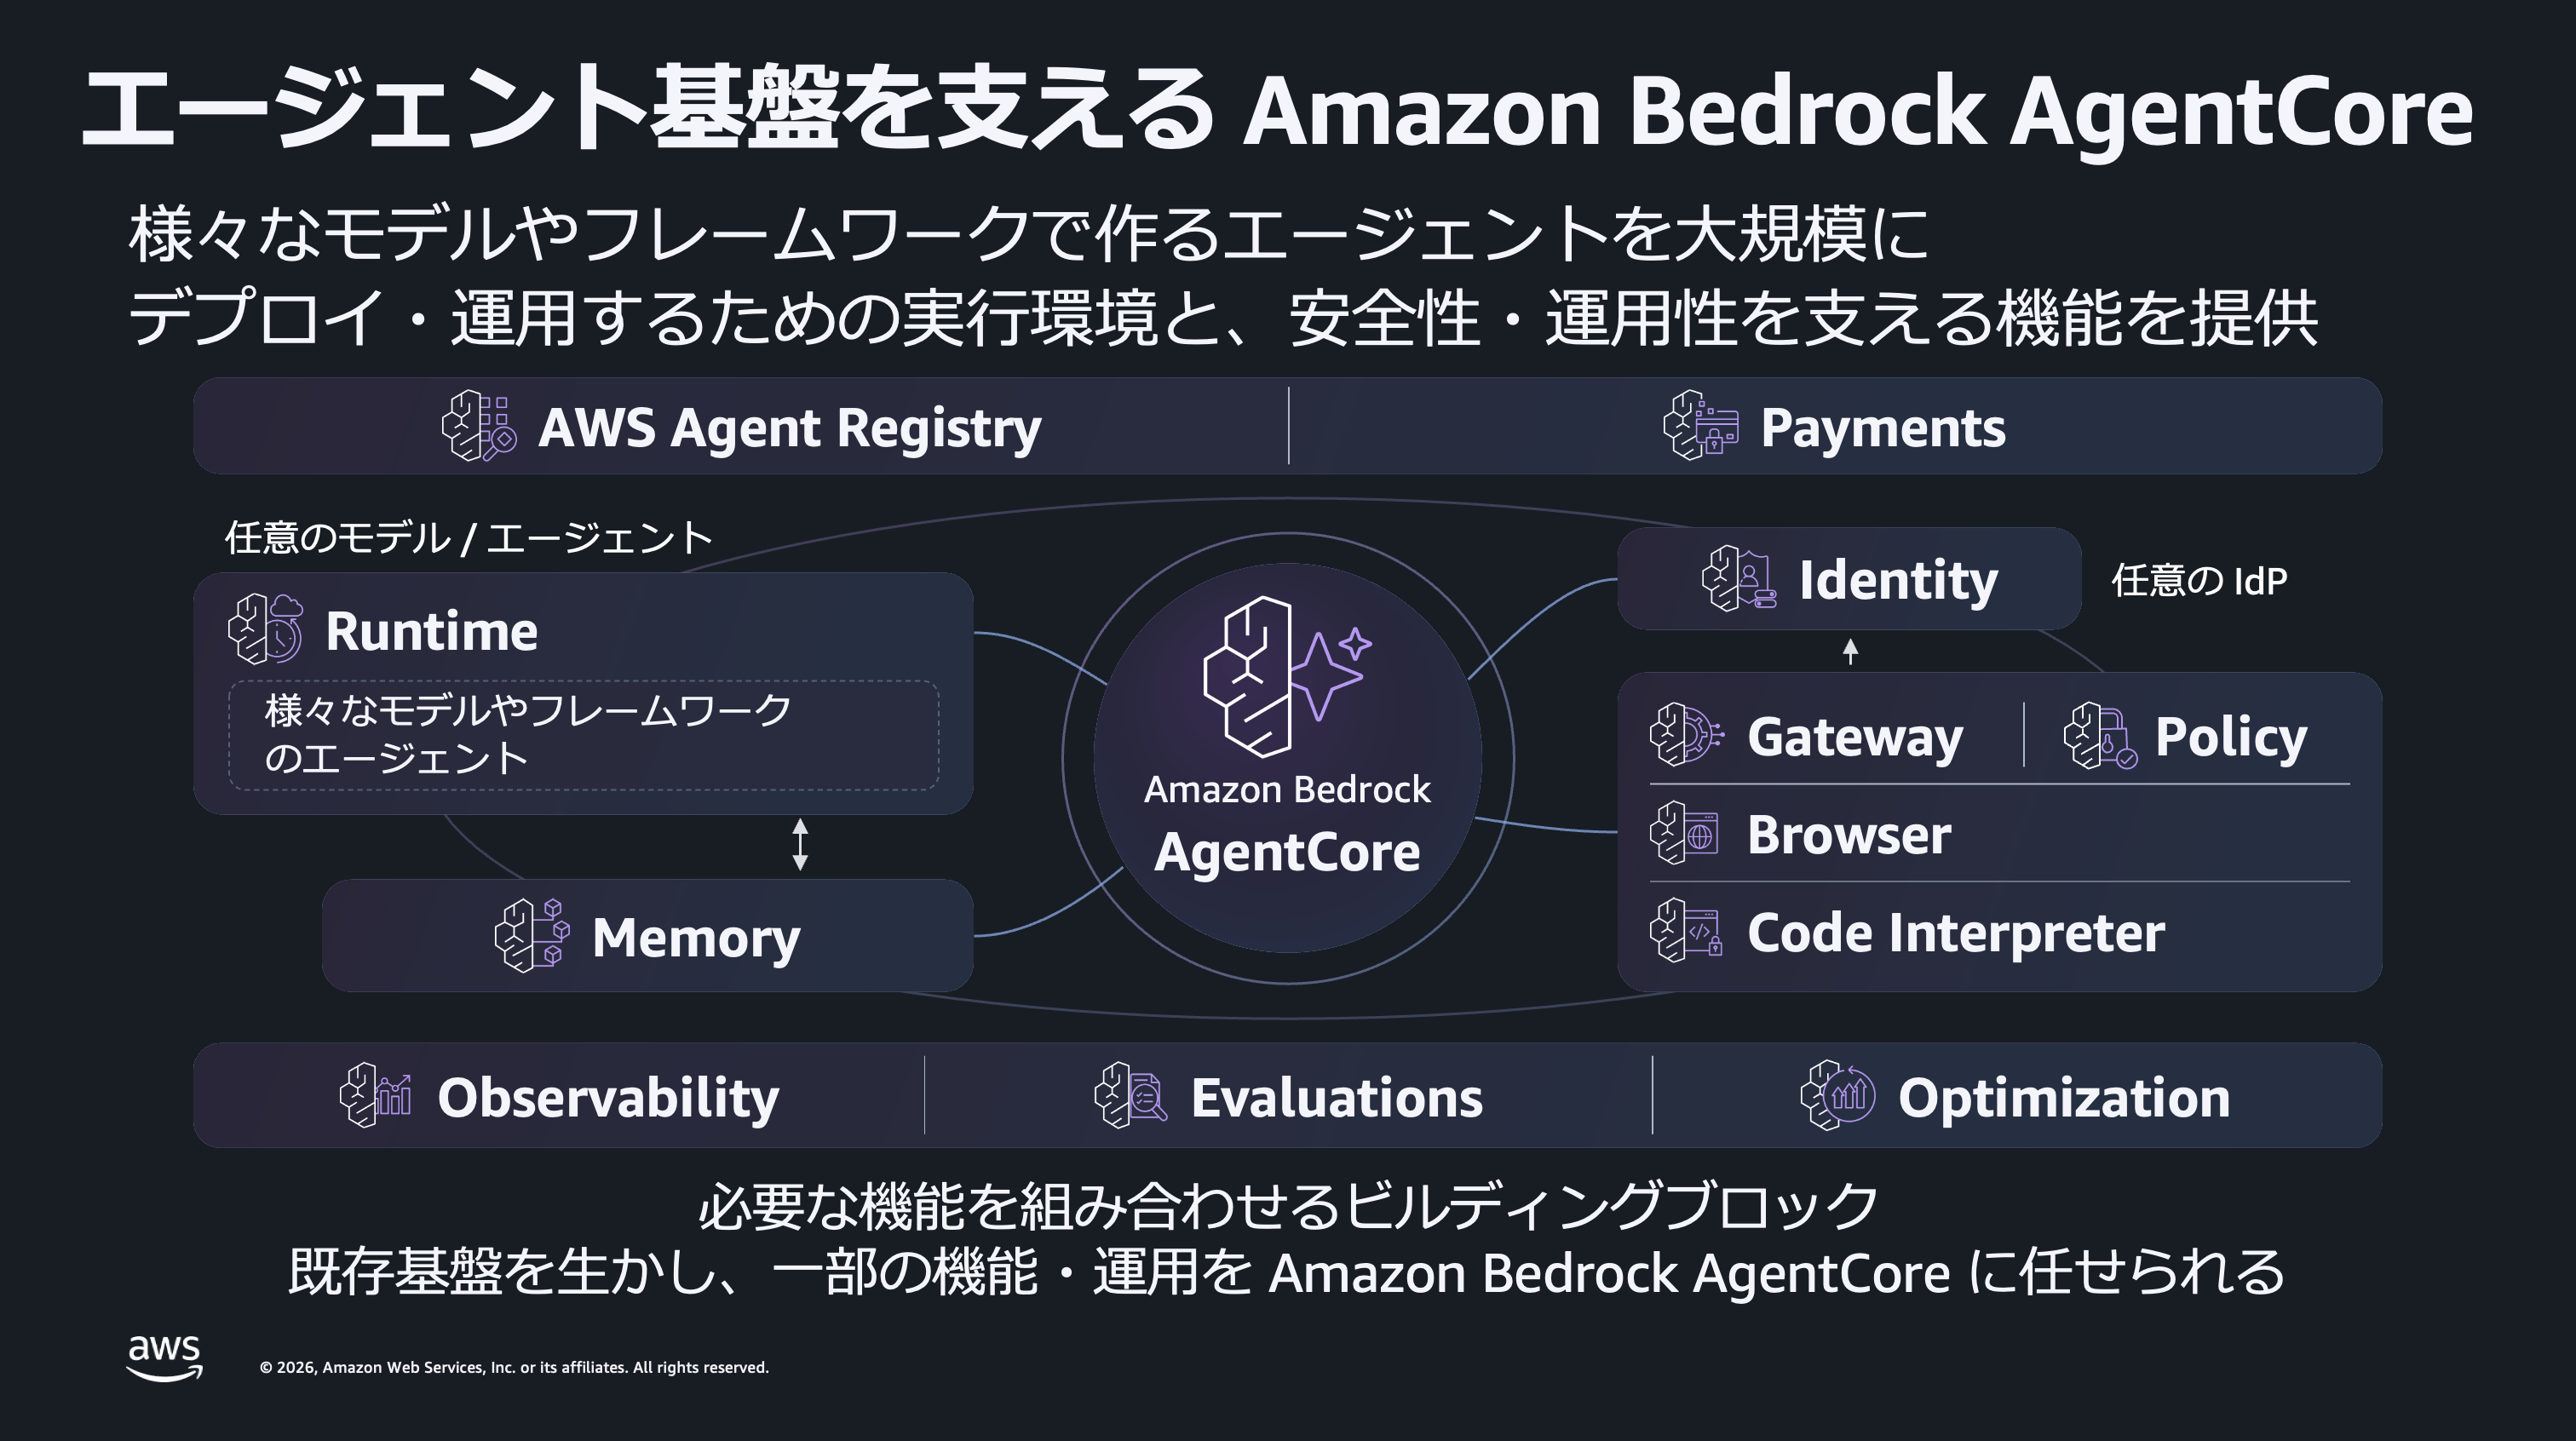
図 2. Amazon Bedrock AgentCore が提供する機能群。
共通機能を自前で一から実装せず、必要な機能から選んで組み合わせられることが、導入のハードルを下げました。AgentCore Runtime 上の Strands Agents で独自の検索・回答ワークフローを組み立て、基盤の共通機能を AgentCore に任せることで、AI チャットのエージェントロジックに注力できました。
今回の AI チャットでは、AgentCore Runtime を実行基盤に、AgentCore Memory を同一セッションの会話文脈の保持に利用しています。Amazon Bedrock Guardrails の個人情報等のブロック・マスク機能も組み合わせています。AgentCore Observability では、トレースとタイムラインを使い、コンテナの初期化とエージェントの処理を切り分け、レイテンシーの調査に活用しました。AgentCore Evaluations は、回答品質を確認する回帰テストに試験利用しました。
AgentCore Runtime V2 の導入と対話の待ち時間の設計
サポートチャットの提供開始に合わせて AgentCore Runtime V2 を導入しました。現時点では、利用者から 1 日あたり数百のリクエストがありますが、10 秒以内のエンドツーエンドのレイテンシーで応答する要件において、AgentCore Runtime V2 の基盤で一貫したレイテンシーを実現できています。
ここからは、応答を支える実行基盤として採用した AgentCore Runtime V2 の起動の仕組みを見ていきます。
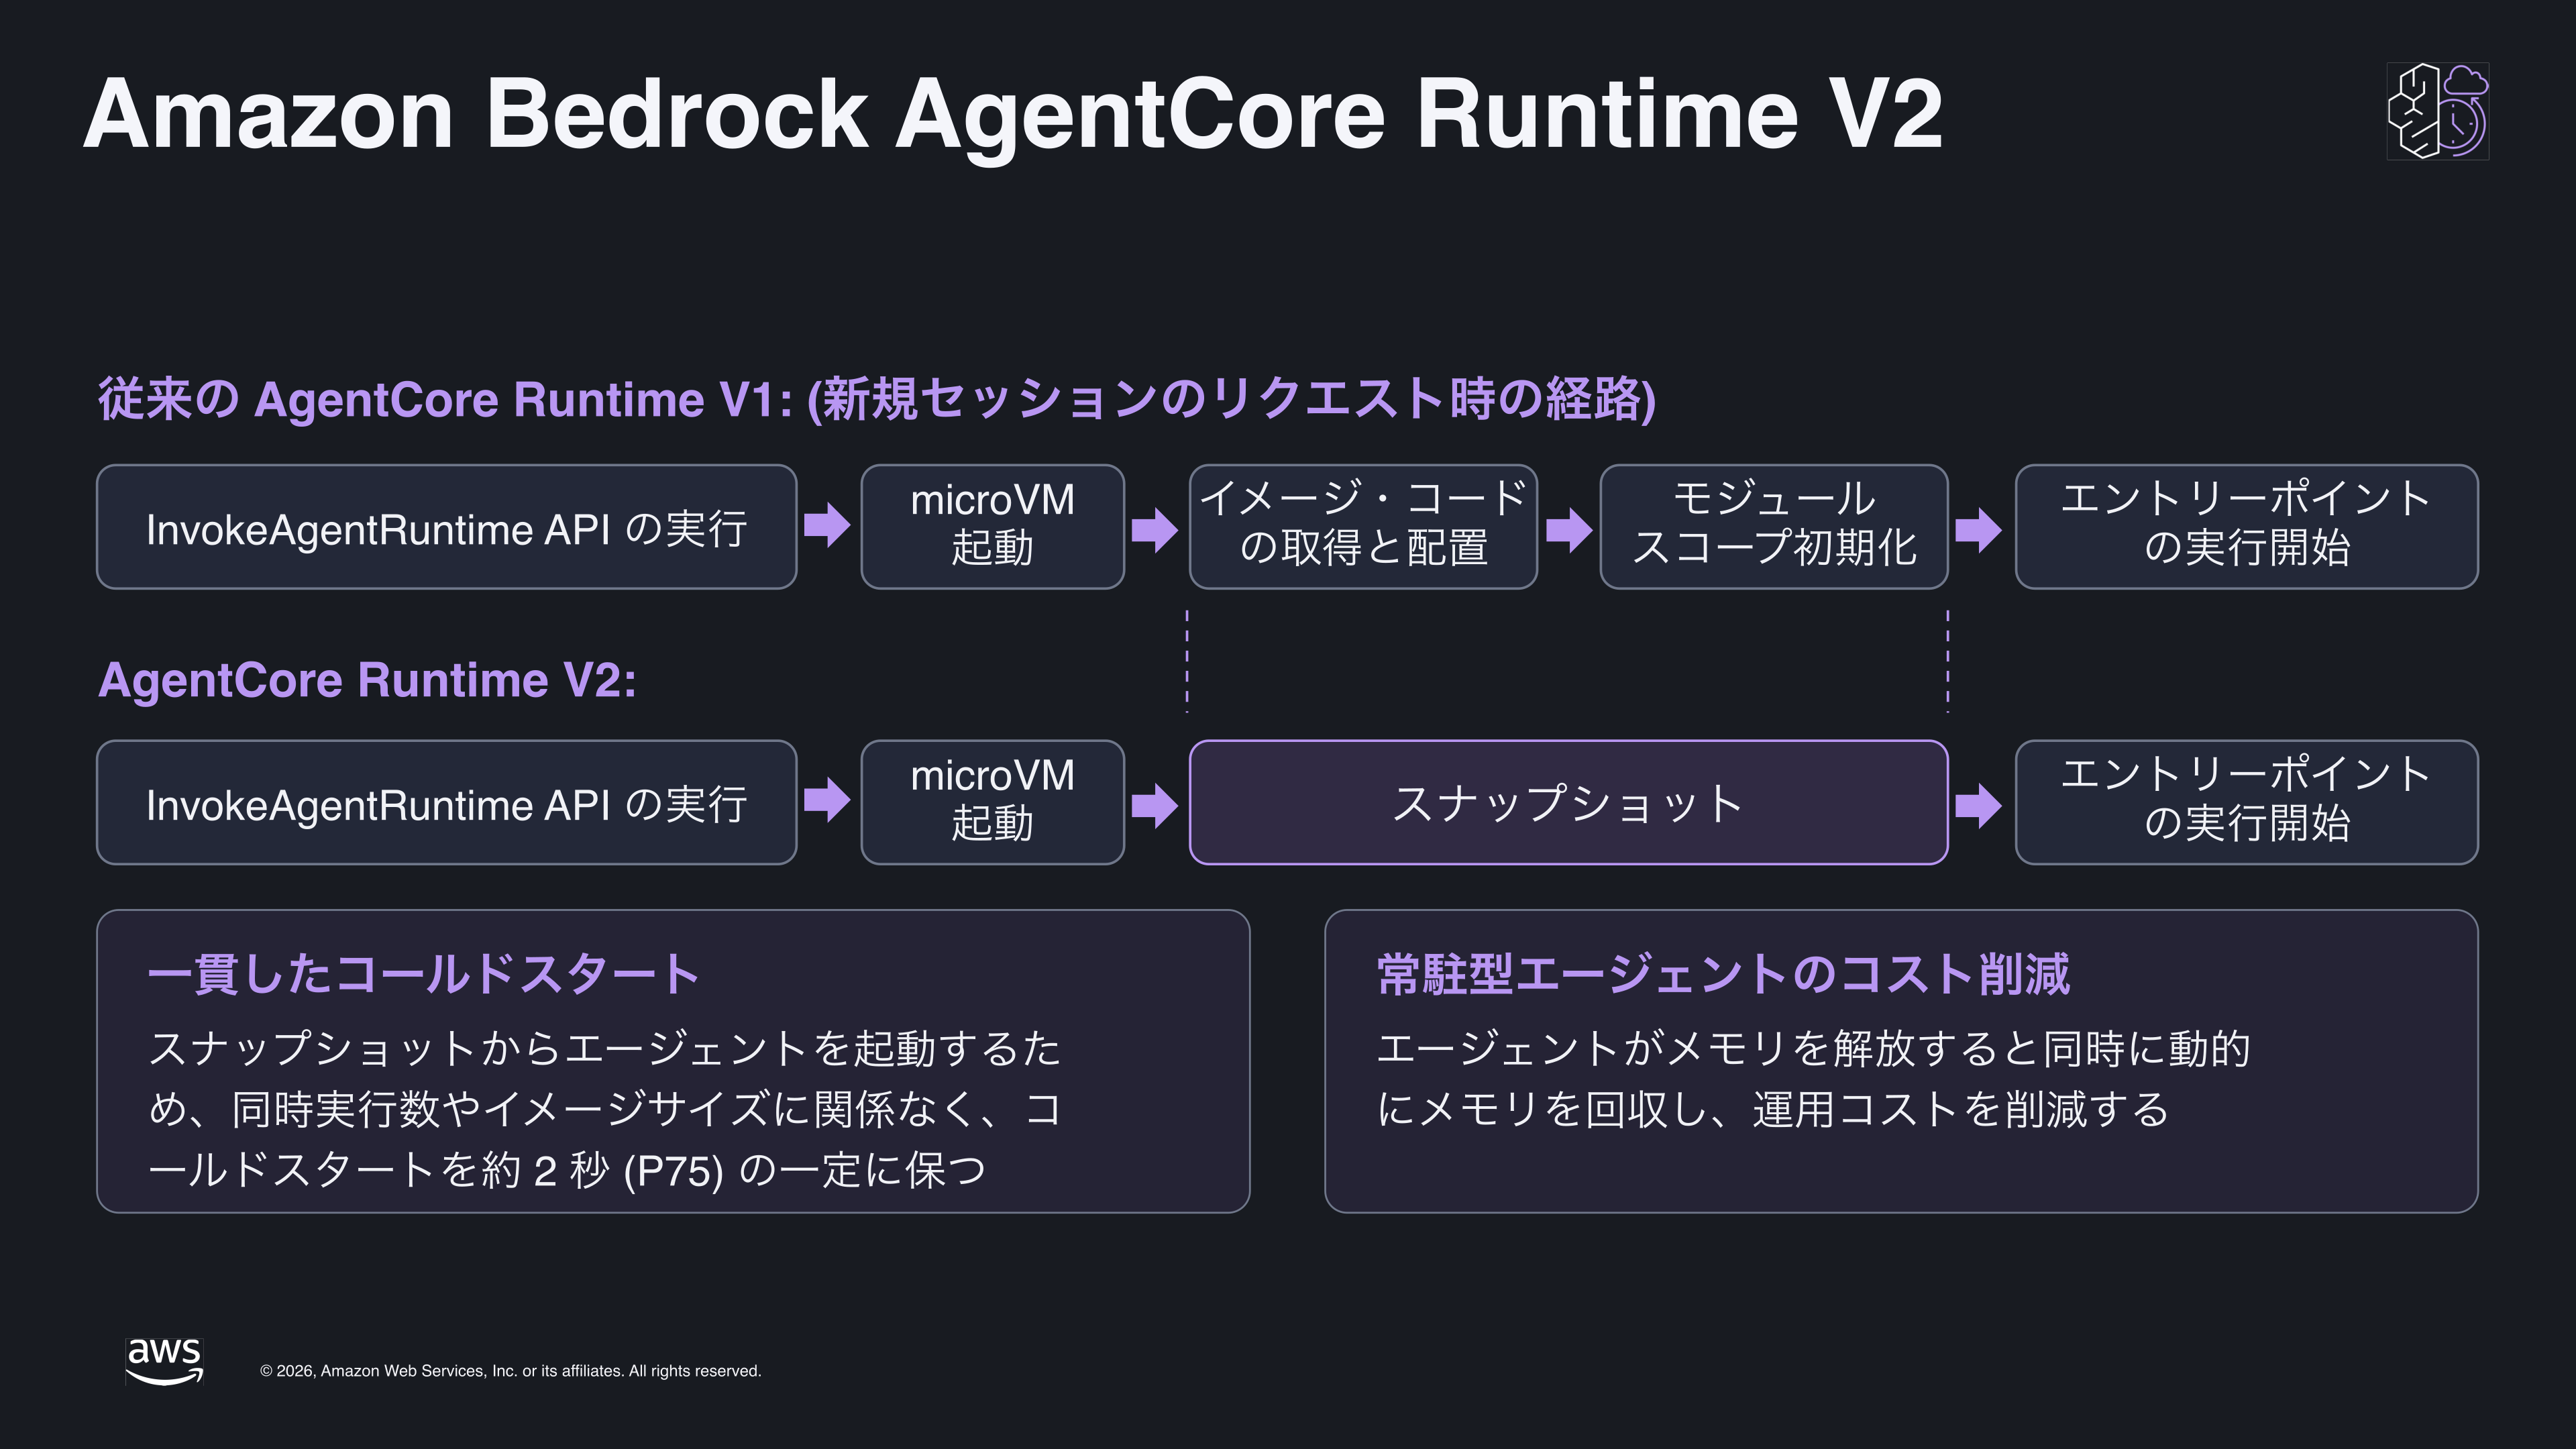
図 3. Runtime V1・V2 の起動方式の概念比較。
図中の約 2 秒 (P75) は、モデルやツールを呼び出さない echo agent を用いた AWS ブログの測定例であり、今回の AI チャットの実測値ではありません。
スナップショットを用いた初期化済み環境の復元
AgentCore Runtime V2 は、初期化済みの実行環境をスナップショットから復元することで、イメージサイズや同時実行数にかかわらず、コールドスタートを高速かつ一貫させることが可能です。リソースを作成または更新した時点で環境を一度のみ準備してスナップショットを取り、以降は新しい microVM ごとに環境を初期化するのではなく、そのスナップショットから復元しています。
スナップショットに含まれるのは、エージェントの初期化済みの状態です。コンテナイメージやコードの取得と配置、モジュールスコープの初期化が含まれます。
V2 では、実行環境のメモリ利用も見直されています。必要に応じてメモリを取り込み、エージェントが解放した領域や、再び参照される可能性が低い領域を回収します。ここでのメモリ回収は実行環境のリソース管理であり、AgentCore Memory に保持した会話情報の削除とは異なります。
AgentCore Runtime V1 から V2 への移行における最適化
V1 から V2 への移行では、スナップショットから初期化結果を再利用できるように、処理を実行するタイミングを見直します。依存関係やデプロイに含まれる静的設定の読み込み、再利用できるクライアントの構築などを、スナップショット取得前に済ませます。初回リクエストで行っていた処理のうち、各実行環境で共通して使えるものを初期化時へ移すことで、復元後に必要な準備を減らせます。
AgentCore SDK を使う場合は、こうした処理を app.run() より前のモジュールスコープに配置します。AgentCore Runtime は最初の正常な /ping 応答でスナップショットを取得するため、独自の HTTP サーバーを使う場合も、初期化が完了してから正常応答を返します。ただし、再デプロイせずに変更する設定はスナップショットに固定せず、変更を反映できるタイミングで読み込みます。
あわせて、V1 で起動時に生成していた値が、復元後もそのまま使えるかを確認します。現在時刻やリクエスト固有の識別子は、リクエストを処理する際に生成し、有効期限のある認証情報は期限切れ時に更新します。起動時の値をスナップショットに含めると、複数の復元先で同じ値が引き継がれるためです。初期化処理を前倒しする際は、再利用できる状態と、その都度更新すべき状態を分けます。
詳細は V2 向けの最適化 のドキュメントをご参照ください。
利用者の入力中のセッション準備プラクティス
対話型エージェントでは、環境をどのように起動するかに加え、いつ起動を始めるかも、利用者の待ち時間に関わります。AWS ブログでは、利用者がチャットを開いた時点など、入力欄に文字を入力する前からセッションを開始する工夫を紹介しています。チャットで挨拶を表示している間や、利用者が最初の質問を入力している間に環境を準備する warm-up の考え方です。
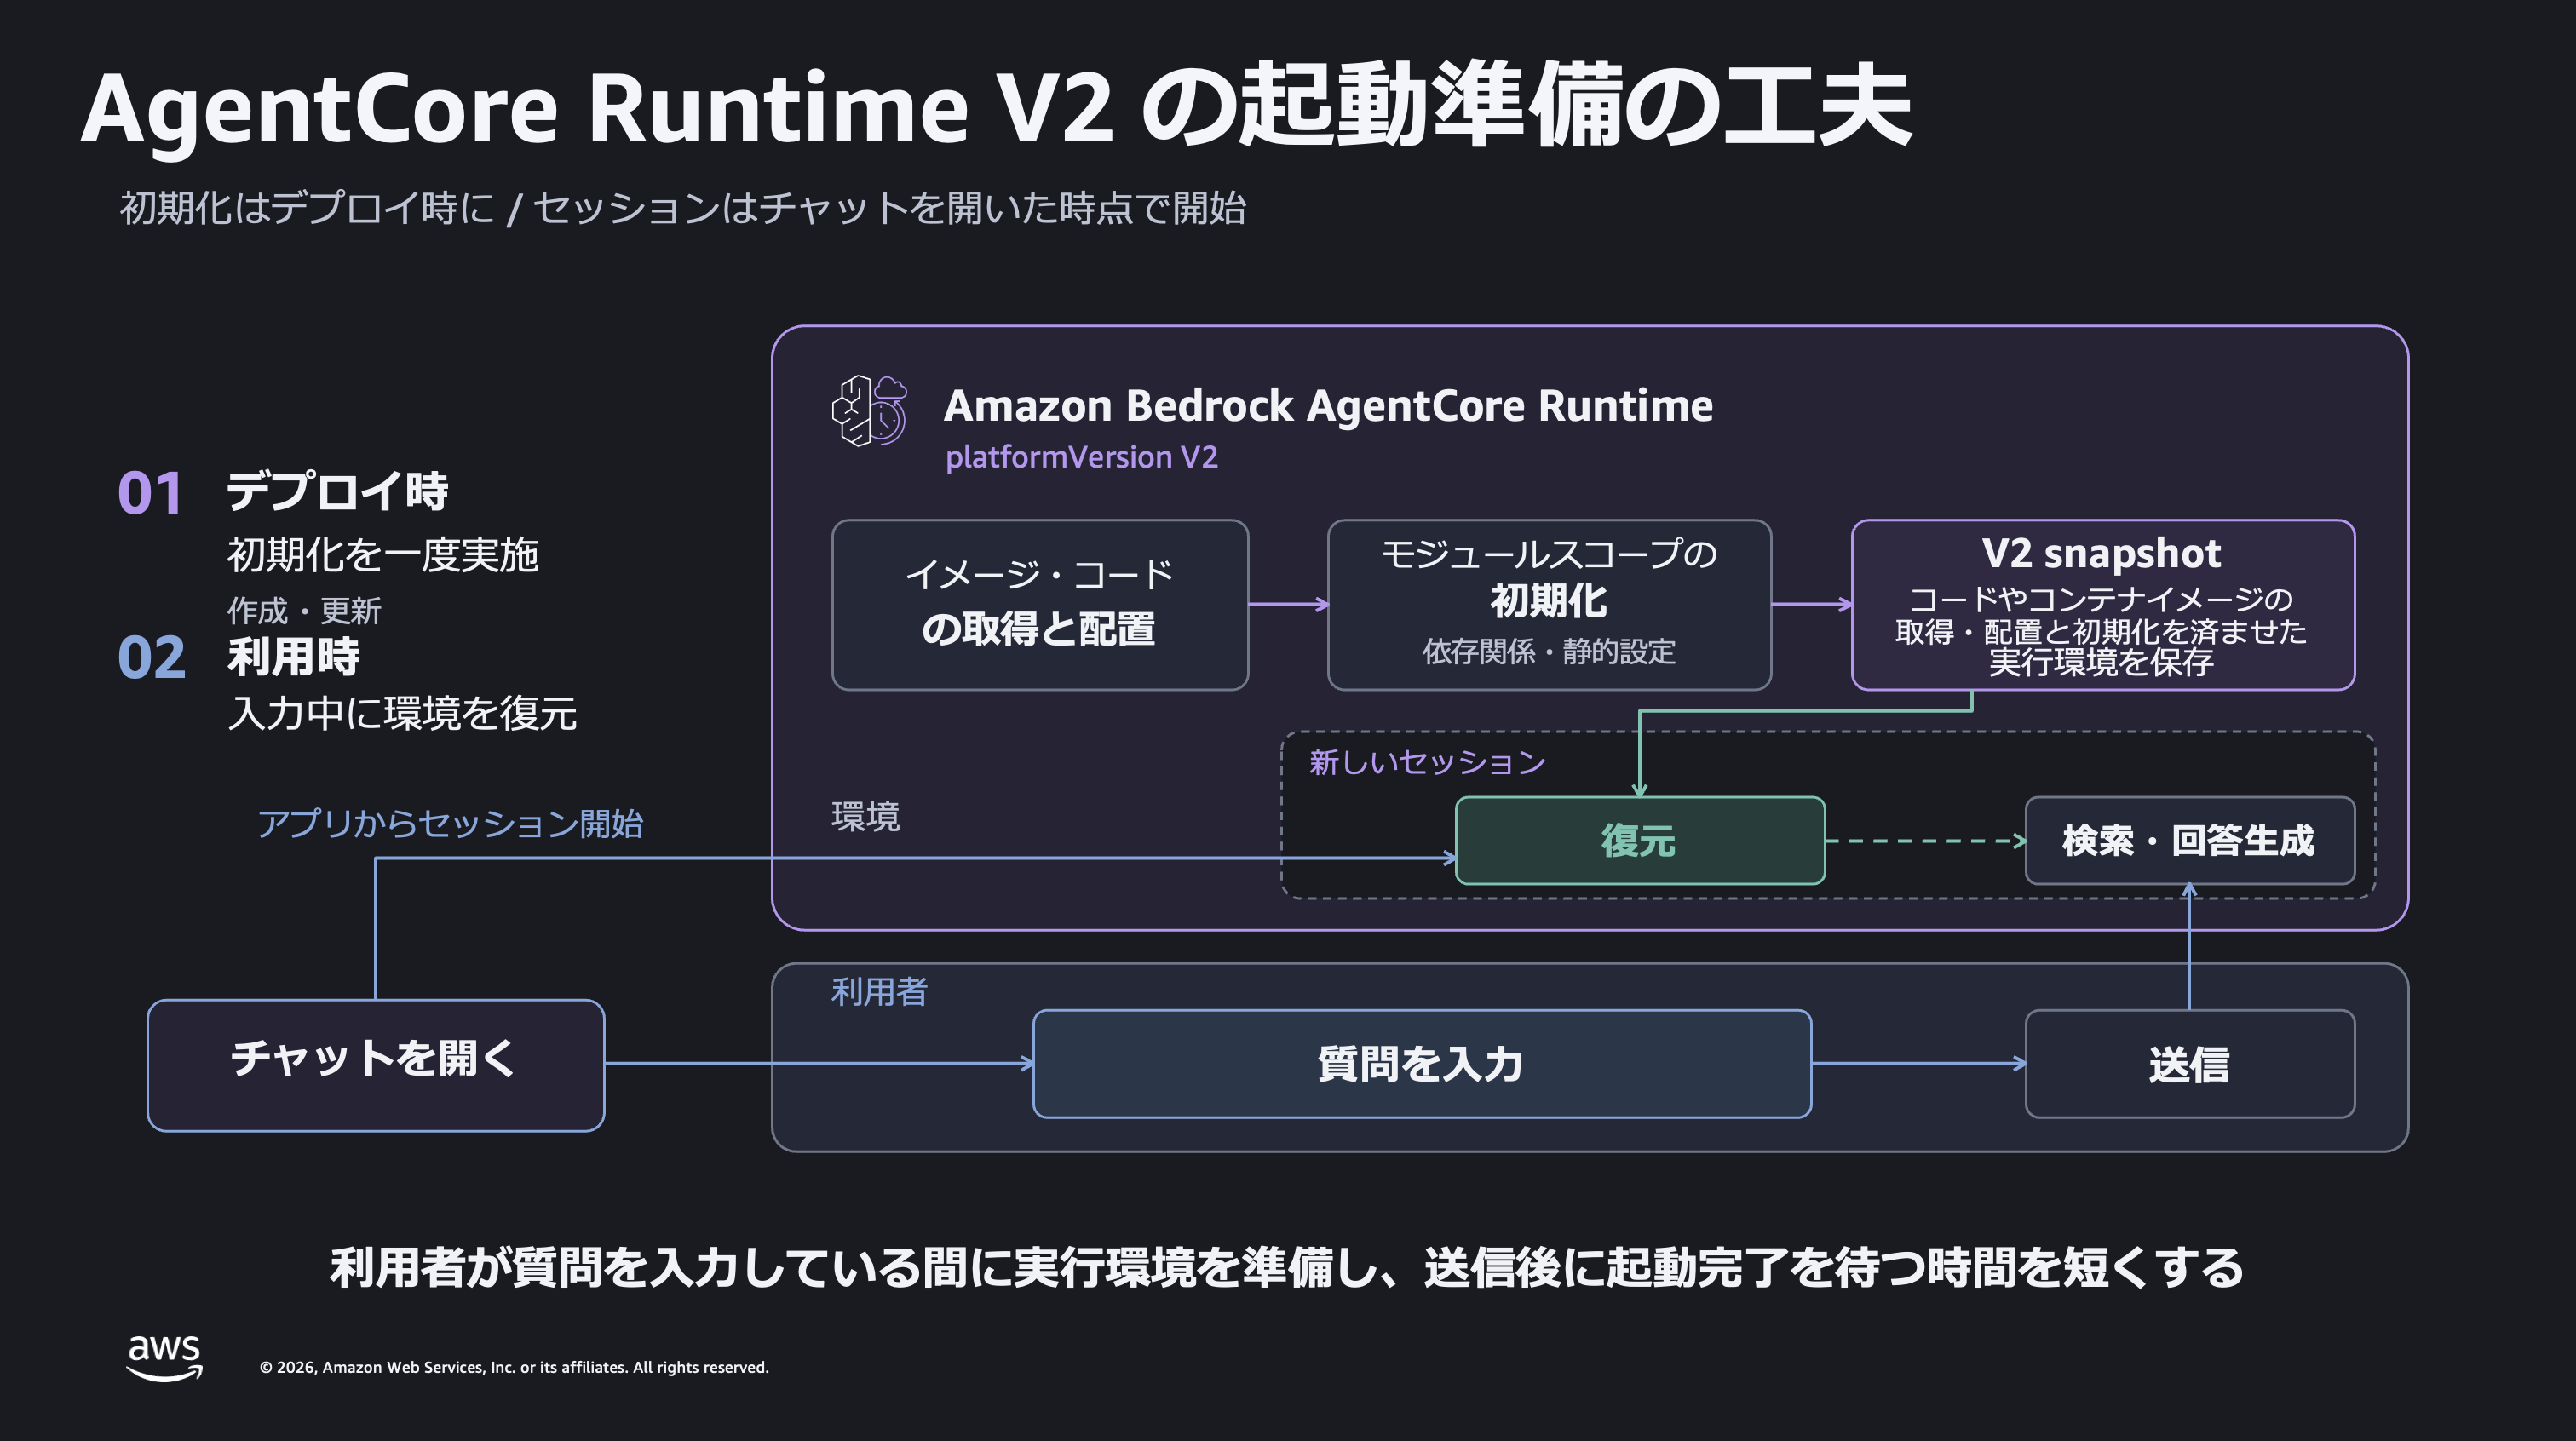
図 4. AgentCore Runtime V2 の起動方式と、入力前にセッションを準備する一般的な設計例。
図 4 のスナップショット取得は、AgentCore Runtime の作成・更新に伴う環境準備です。入力前のセッション開始は、アプリケーションが利用者の操作に合わせて準備を始める設計です。V2 が準備済みの環境を復元する仕組みと、その復元を入力中に進める工夫を組み合わせることで、質問送信後に起動完了を待つ時間を短くすることを狙えます。
会話文脈の保持、処理の観測、回答の評価
今回のサポートチャットでは、AgentCore Runtime 上の Strands Agents による検索・回答を中心に、AgentCore Memory による会話文脈の保持、AgentCore Observability による処理の観測、AgentCore Evaluations による回帰テストでの評価の試験利用を組み合わせています。これらの機能の関係を図 5 に示します。
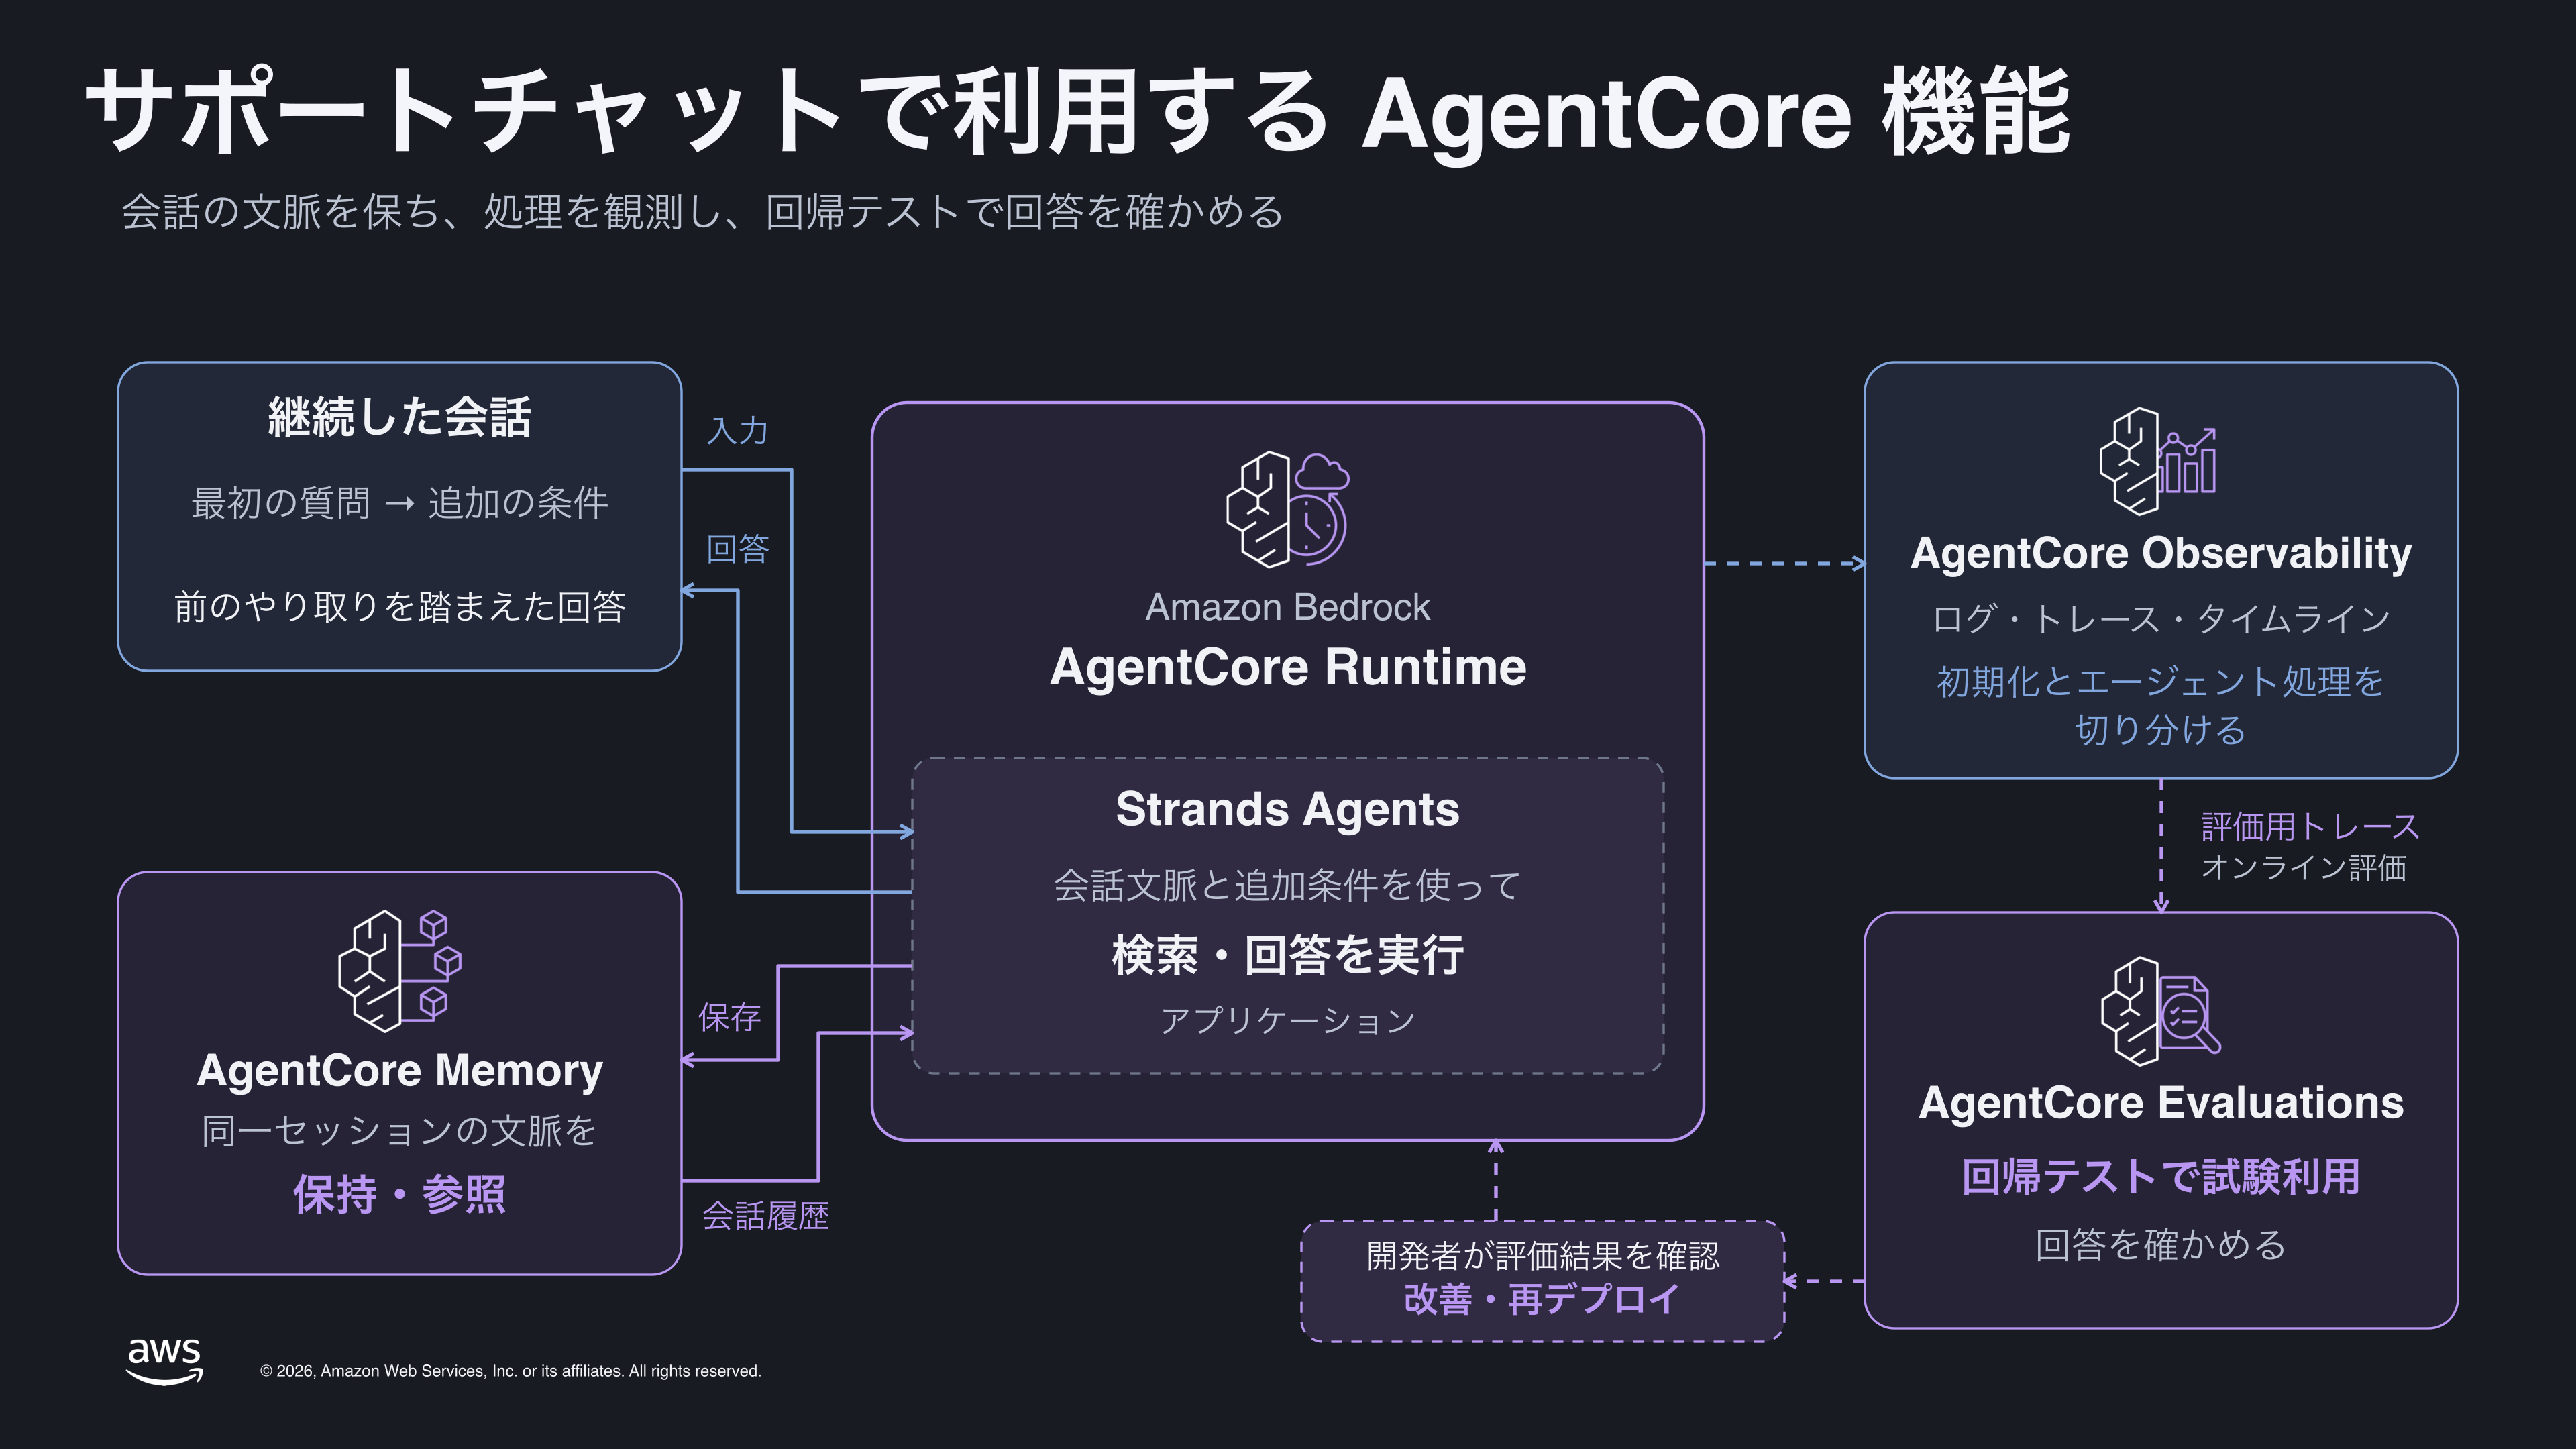
図 5. AgentCore Runtime を中心に会話文脈の保持、処理の観測、回帰テストでの評価の試験利用を組み合わせるサポートチャットの AgentCore 機能。
AgentCore Memory は、同一セッション内の短期的な会話文脈の保持に使っています。使い方に関する質問の後で利用環境などの条件が補足されたとき、前のやり取りと合わせて入力を扱うためです。保持した会話情報のうち、どの情報を今回の質問に結び付けるかを決め、追加質問を解釈する処理はアプリケーションで設計しています。
AgentCore Observability のトレースとタイムラインは、導入後の処理確認に役立ちました。コンテナの初期化とエージェントの処理を切り分け、どこに時間がかかっているかを確認できました。翻訳、検索、文書取得、モデル呼び出しを含む総応答時間に加えて処理の内訳を見ることで、実行環境の起動と検索・回答側のどちらを調べるべきかを判断する手掛かりを得られます。
回答品質については、AgentCore Evaluations を回帰テストに試験利用しました。AgentCore Evaluations は、エージェントやツールのタスク実行、例外的な入力への対応、出力の信頼性などを評価するサービスですが、今回紹介する活用範囲はこの試験利用です。
運用中の回答品質を継続的に確認する機能として、オンライン評価も利用できます。評価対象のログと評価器を設定すると、Amazon CloudWatch に出力されるエージェントの実行トレースを基に自動で評価します。評価結果は Amazon CloudWatch に保存され、スコアの推移や個々の評価内容を確認できます。
図 5 の AgentCore Observability から AgentCore Evaluations への矢印には、このオンライン評価で使うトレースの流れを示しています。開発者は評価結果を確認し、コードやプロンプトを見直して再デプロイします。開発者から AgentCore Runtime への破線はこの改善の流れを表し、利用者への応答経路と分けて示しています。
同様の取り組みを始める際は、代表的な質問、回答に必要な参照情報、期待する回答を用意し、構成変更の前後で確かめる方法を提案します。点数だけでなく、マニュアルの内容に沿っているか、追加条件を踏まえているかを確認し、サービスの目的に合う評価基準を具体化していきます。結果を基に開発者がコードやプロンプトなどを見直し、再デプロイ後に同じ質問で確かめる流れを、開発・運用の改善として取り入れられます。
この改善サイクルをさらに発展させる手段として、AgentCore Optimization の活用も考えられます。実行トレースと評価器を基に、システムプロンプトやツール説明の改善案を生成し、その候補をテスト用データセットで評価する流れを組めます。開発者が評価結果を確認して変更を採用することで、回答品質の確認から、改善案の検討と検証へと取り組みを広げられます。
プロジェクトの学びと、AgentCore Harness から始める実践
試作を通じた独自処理の明確化
本プロジェクトでは、Amazon Bedrock Agents (Classic) で土台を作り、要件が具体化した段階で AgentCore Runtime 上の Strands Agents を使って処理を作り込みました。
Bedrock Agents でまず動くエージェントを作ることで、実際の動作を基に要件を考え、その後、独自のワークフローを実装できました。移行を通じて、Bedrock Agents が内部で行っていた推論を省く工夫などへの理解も深まり、設計の参考になりました。
この経験から得られたのは、まず動くエージェントで要件を確かめ、必要になった部分を独自実装へ広げていく進め方です。
Bedrock Agents (Classic) は 2026 年 7 月 30 日から新規のお客様への提供を終了しており、既存のお客様向けに継続提供されています。これから同じように試作を始める際は、AWS が推奨する AgentCore Harness を入口として検討できます。
AgentCore Harness による試作とコードへの Export
AgentCore Harness は、Strands Agents を基にしたマネージドなエージェントループを提供します。モデル、システムプロンプト、ツールなどを設定すると、AgentCore がループを実行します。ここからは、今回の AI チャットの採用構成とは区別して、試作の進め方を紹介します。
AgentCore Harness の標準構成と、必要に応じて追加する機能を図 6 に示します。
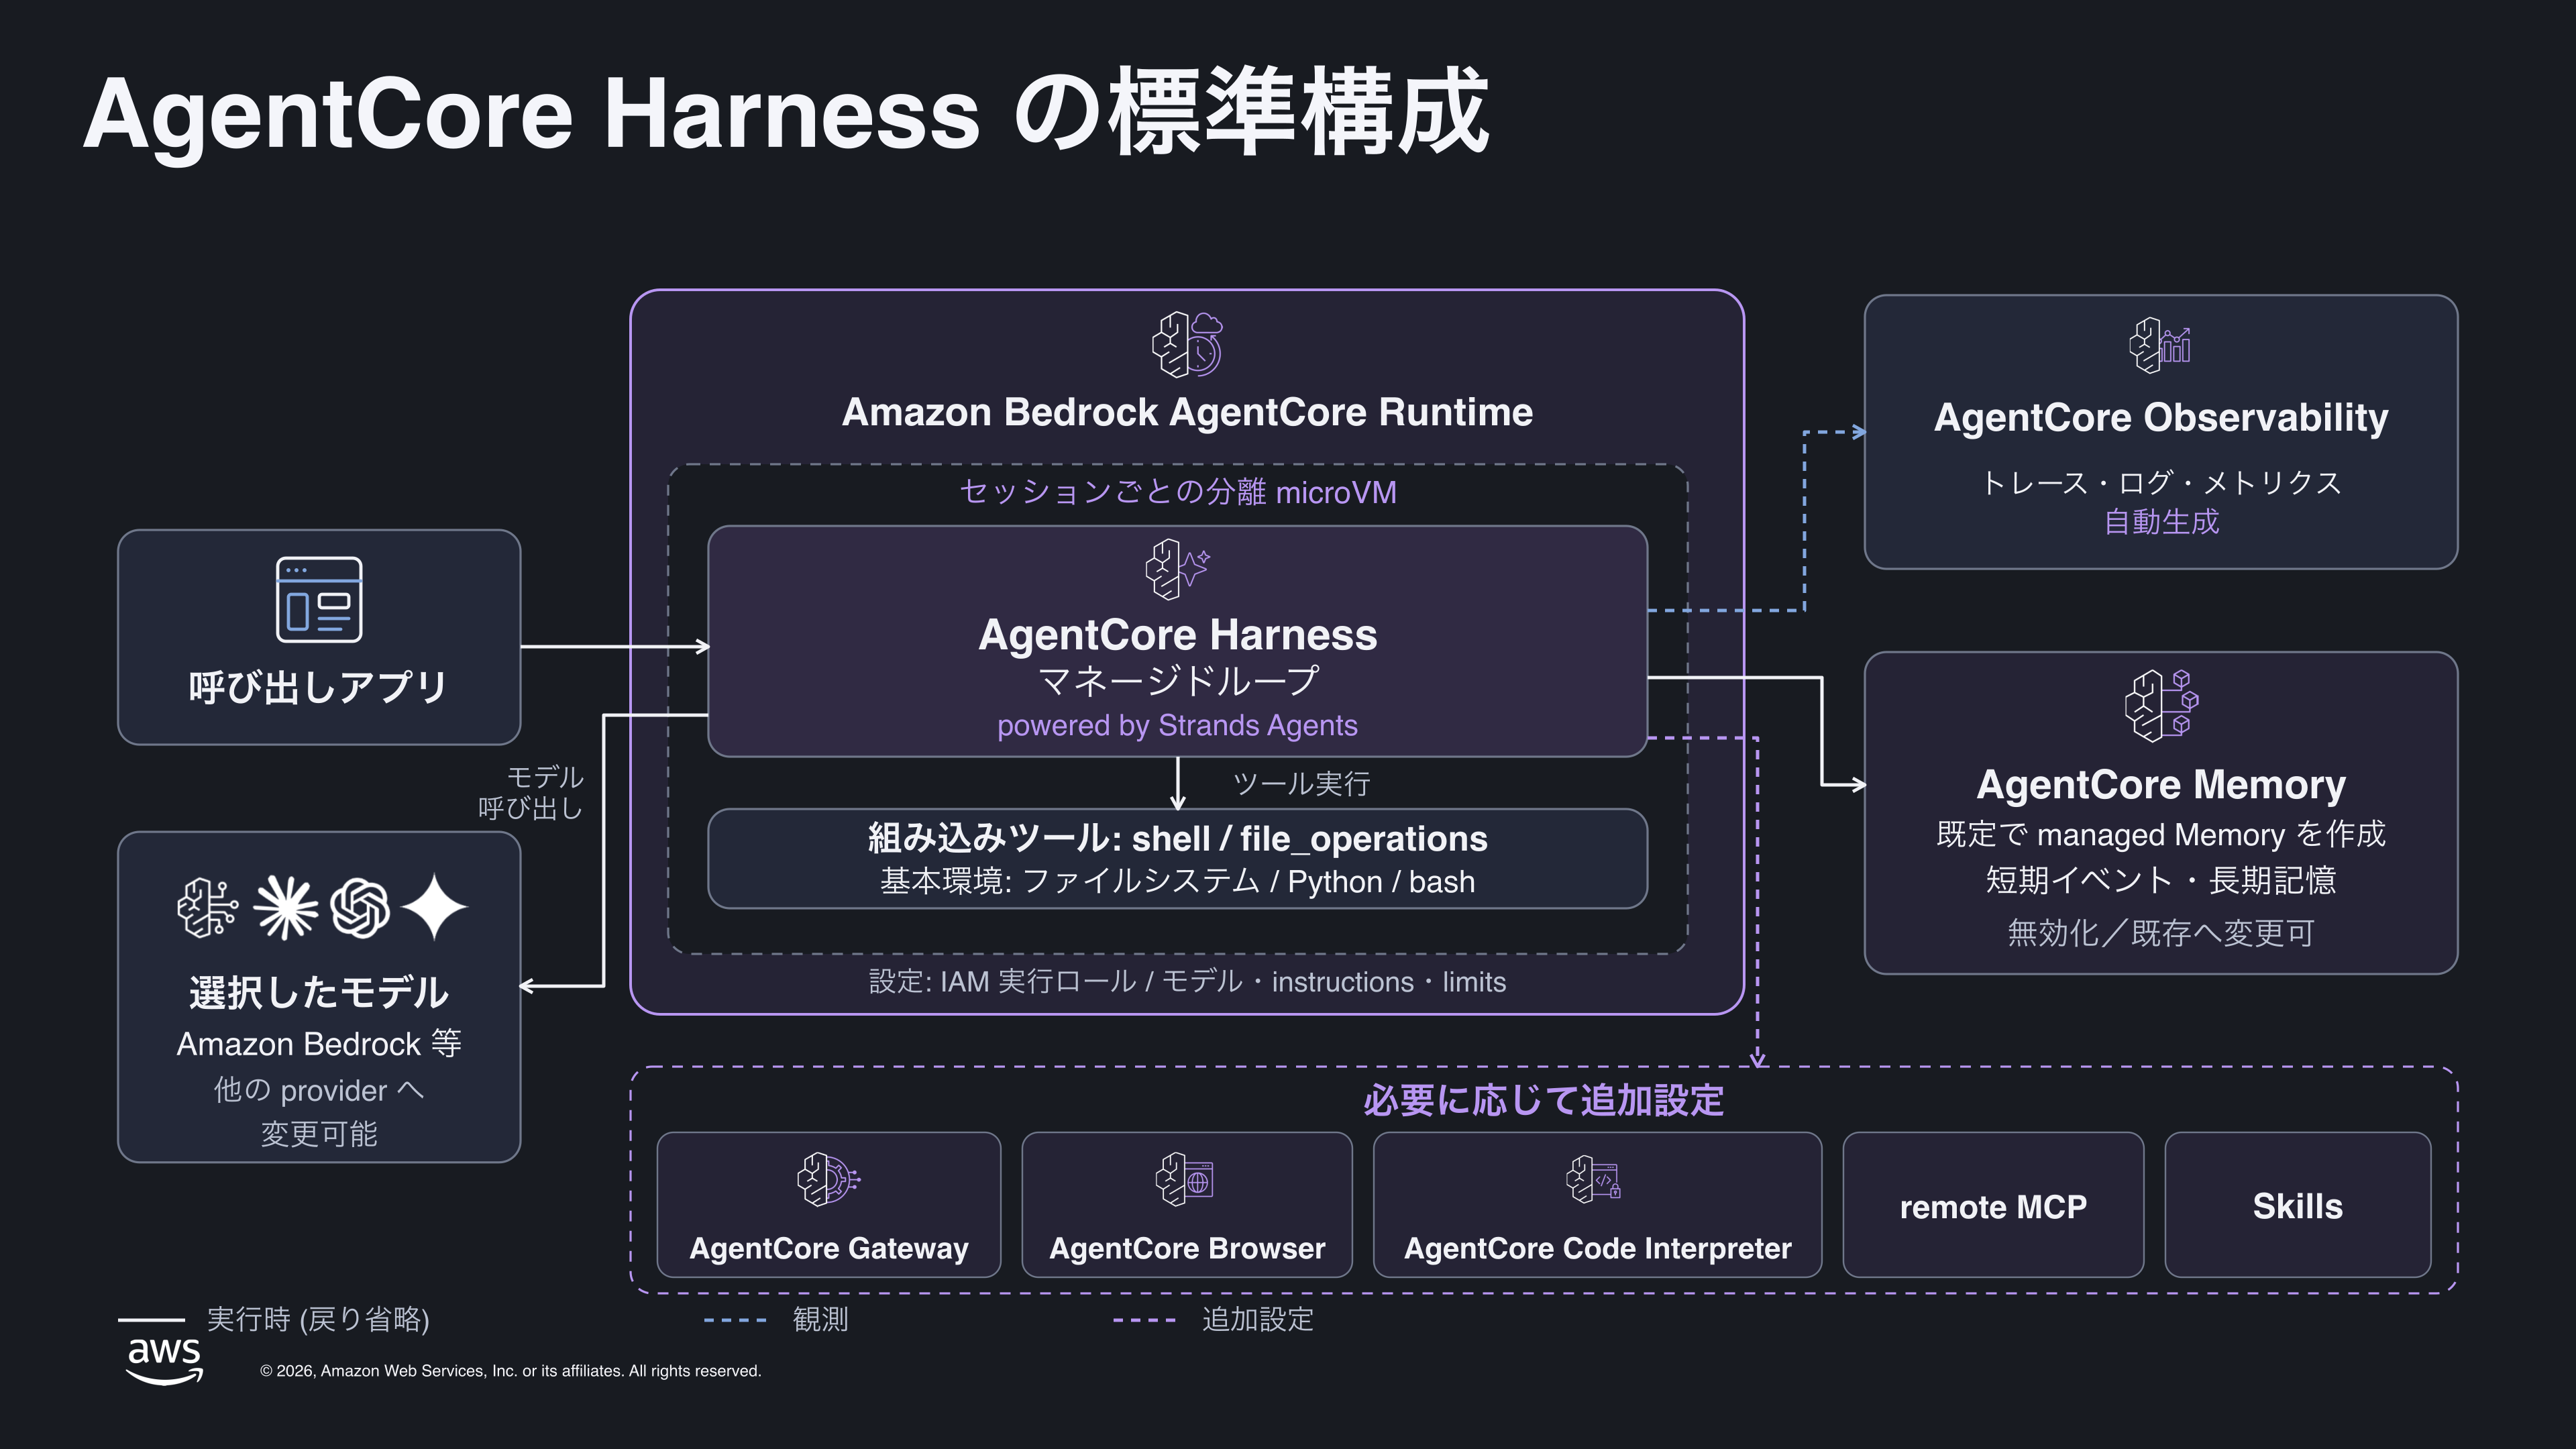
図 6. AgentCore Harness が標準で備える構成と追加設定。
- AgentCore Runtime 内の Strands ベースのループが、選択したモデル / プロバイダー を呼び出します。セッションの実行環境 には分離された microVM と専用のファイルシステムがあり、Python / bash を備えています。組み込みツール の shell と file_operations は標準で利用できます。
- 標準で用意される AgentCore Memory は短期イベントと長期記憶を扱い、AgentCore Observability は呼び出しごとのトレース・ログ・メトリクスを自動生成します。Memory の自動作成・取得やトレースの閲覧に関する設定条件は、実践補足で説明します。
- AgentCore Gateway、外部 MCP サーバー、AgentCore Browser、AgentCore Code Interpreter は、ツールの接続設定で追加する機能です。Skills も必要に応じて設定します。
同様のチャットを試作する際は、対象言語の根拠本文に沿って答えられるか、同じセッションで追加された条件を踏まえられるかを確かめます。そのうえで、検索や本文取得などの独自処理を、どこまで自ら内製・運用する必要があるかを検討します。
AgentCore Harness の設定だけで要件を満たす場合は、そのまま利用を続けられます。より細かなワークフロー制御が必要になったら、設定を Export し、編集可能なエージェントコードとして引き継ぐ方法があります。AgentCore Harness 自体も Runtime 内で動くため、これはマネージドなループから、開発者が管理するコードへ実装を引き継ぐ選択です。
AgentCore Harness の詳細やワークショップはそれぞれ以下の資料をご参照ください。
- Amazon Bedrock AgentCore harness is now generally available: Go from idea to production-grade agent in minutes
- Getting Started with Amazon Bedrock AgentCore
今後の展開
今後は、この多言語サポートチャットの利用者数を増やしていくことを目指しています。検索基盤については、Amazon Bedrock Managed Knowledge Base へ移す開発を進めています。
移行先では、取り込み・保存・索引化・検索の基盤を Amazon Bedrock が管理するほか、取り込む情報や検索方法を広げる機能を利用できます。Advanced Indexing を有効にすると、文書内の図や画像なども取り込み対象にできます。Agentic Retrieval では、質問に応じて検索計画を立て、複数回の検索や必要に応じた文書全体の取得を行う処理をサービス側に任せられます。
また、AgentCore Gateway との連携では、接続先と権限を設定することで、ナレッジベースの検索機能を MCP ツールとしてエージェントから利用できます。検索機能を独自にツール化する実装を減らせることも、エージェントとの連携を進めるうえでのメリットです。移行後も、取り込む文書を英語のマニュアルに絞る方針は継続する予定です。
まとめ
今回の AI チャットでは、実行環境や会話情報の保持に AgentCore の共通機能を利用し、AgentCore Runtime V2 上の Strands Agents で多言語の検索・回答を実装しました。英語の索引から対象言語の本文へたどり着き、その内容を根拠に答える流れは、マニュアルの持ち方に合わせて設計しています。共通基盤に任せる部分を定めることで、利用場面に応じた独自のロジックに注力できました。
AgentCore Memory で同一セッションの会話文脈を保持し、アプリケーション側で追加質問の解釈に利用しています。AgentCore Observability では、初期化とエージェント処理を切り分け、待ち時間の内訳を確認できました。AgentCore Evaluations は、構成変更後も回答品質が維持されているかを確認する回帰テストに試験利用しました。
これから同様のチャットを開発する際は、AgentCore Harness で試作し、代表的な質問や追加質問への回答を、期待する内容やマニュアル本文と照らして確認できます。応答時間も測りながら要件を具体化し、より細かな処理の制御が必要になったら、Strands Agents のコードへ Export して AgentCore Runtime 上で作り込む方法も選べます。