Amazon Web Services ブログ
ERP例外処理をAWSエージェント型標準作業手順書(SOP)で自動化
背景
最近の調査(McKinsey)によれば、世界中のエンタープライズ ERP システムでは毎月膨大な数の手作業による介入が発生し、波及しています。たとえば、あるグローバル製造企業では、入金された銀行支払いが請求書と何日も突き合わせられないまま残り、キャッシュフローを悪化させ、売掛金(AR)チームが日々数百件の取引を手作業で消し込むことで売上債権回転日数(DSO)が膨らんでいます。ここで、内部統制マネージャーに「AI がこれらの支払いを自動的に消し込み、計上します」と提案する場面を想像してみてください。返ってくる答えは決まって「間違いを起こさないとどうして分かるのか?」です。複雑な業務プロセスを AI に確実に実行させることへの信頼は、今日多くのユーザーが直面している最大の課題のひとつであり続けています。
SAP のスリーウェイマッチのような高度な組み込み自動化でさえ十分とは言えず、請求書の例外、購買発注(PO)の承認ブロック、月次決算、会社間消し込みなど、ほぼあらゆる業界で手作業の介入が横断的に発生しています。これまでの自動化アプローチも同様でした。ロボティック・プロセス・オートメーション(RPA)は UI のクリック操作を自動化しましたが、画面レイアウトが変わると壊れてしまいました。従来型の機械学習(ML)は例外を予測できても、それを解決することはできませんでした。
お客様の IT ランドスケープは、SAP インスタンス、レガシーシステム、クラウドサービス、サードパーティアプリケーションが入り乱れたパッチワークとなり、それぞれが互換性のないプロトコルと分断されたデータを抱え、ますます複雑化しています。SAP は財務報告の検証済みコアとして機能します。したがって、システム横断的な自動化はいずれも、Sarbanes-Oxley 法(SOX)、ISO、内部監査の要件を満たすために、セキュアなアクセス制御、検証済みのユーザー ID、完全な監査証跡を強制する必要があります。
状況を変えたのは、非構造化された手順を推論し、システム境界を越えてツールを呼び出し、複数ステップのワークフローにわたってコンテキストを維持できる基盤モデル(foundation model)の登場です。
これらの例外を大規模に解決するには、エージェント型標準作業手順書(Agentic Standard Operating Procedures、SOP)が必要です。これは、ナレッジベースからエンタープライズの手順を解釈し、SAP システムと非 SAP システムをまたいで複数ステップの例外を自律的に解決する、単一かつ統合された AI 駆動エージェントです。判断や承認が必要な箇所では、ヒューマン・イン・ザ・ループ(human-in-the-loop)の制御が働きます。
エージェント型 AI は有望な道を示しますが、新たな課題ももたらします。それは、エージェントがガバナンスの追いつかない速さで増殖していくということです。分断されたシステム間でセキュアに連携するエージェントを構築するのは複雑でコストがかかります。「あらゆる問題に対してエージェントを作る」という無制約なアプローチではなく、段階的に成熟し、各段階で価値を提供し、人間の信頼を漸進的に獲得していく、構造化されたフレームワークが必要です。
本稿では、SAP ユースケース向けの AWS Agentic AI Solutions Framework を紹介します。これは、ヒューマン・イン・ザ・ループ制御による漸進的な信頼、SOP 駆動の統合エージェントアーキテクチャ、決定論的で監査可能なアクションのためのガード付き MCP サーバー、ID を意識したセキュリティとコンプライアンス、監査水準のドキュメンテーションのための永続的な状態管理という 5 つのコア機能に基づいて構築された、プロダクショングレードのアプローチです。続いて、Amazon Bedrock AgentCore を用いて SAP 環境に対してこのフレームワークをデプロイするためのリファレンスアーキテクチャと技術的ベストプラクティスを解説します。
コア機能
さまざまな業界や事業部門のお客様と協働する中で、AWS は、エンタープライズ ERP ランドスケープにおいて安全かつ効果的に稼働するためにお客様のエージェント型 AI システムが備えるべきコア機能のセットに収束しました。次のセクションのリファレンスアーキテクチャは、これらの各機能に対応しています。
リスクを抑えながら段階的に信頼を獲得する: エージェントはまずアドバイザリーモードで開始し、すべてのアクションは人間が実行します。信頼が積み上がるにつれて、エージェントは監督付き実行へと移行し、最終的には、信頼度が定義済みのしきい値を超えた場合にのみ独立して動作する自律的な解決へと進みます。自動化は、信頼を確立した分だけ拡大していきます。
すべてのプロセスに 1 つのエージェントをデプロイする: 業務プロセスごとに別々のエージェントを構築する代わりに、単一のエージェントが、キュレーションされたナレッジベースから SOP を動的に解釈・実行し、例外の種類やプロセスのコンテキストに応じて適切なツールを実行時に呼び出します。お客様の業務チームが SOP を自然言語で作成・所有するため、変更にはコードの再デプロイではなく SOP の更新だけで済みます。エージェントは SOP を厳格なルールではなく推論のコンテキストとして扱い、キュレーションされたプロンプト、構造化されたツールオーケストレーション、ガードレールを通じて、あらゆるステップを決定論的かつ監査可能に保ちます。
一貫した再現性のある結果を得る: 同じ入力は、常に同じ出力を生成しなければなりません。大規模言語モデルは本質的に確率的であるため、決定論(モデルがハルシネーションを起こしたり一貫性のない結果を生成したりするのを防ぐこと)を達成するには意図的な制御が必要です。本ソリューションは、制御されたモデルパラメータ、構造化されたプロンプトエンジニアリング、ハルシネーションを防ぐための信頼できる SOP コンテンツとライブシステムデータからの取得、ポリシーとグラウンディング検証のための実行時ガードレール、アクション実行前に推奨事項をクロス検証するマルチエージェントによる相互検証を通じて、これを強制します。
誰が、いつ、何をしたかを正確に把握する: すべてのエージェントのアクションを適切な ID に帰属させなければなりません。エージェントが自律的に動作する場合は自身のサービスアカウントで認証し、人間が介入する場合はシステムがその人間の検証済み ID に切り替えます。この分離により、コンプライアンスチームはエージェントのアクションと人間が承認したアクションを区別できます。あらゆるツールの呼び出し、データの読み取り、アクションは、SOX、ISO、内部監査の要件を満たす改ざん検知可能な証跡とともにログ記録されます。
初日から監査担当者と運用チームを満足させる: 専用の永続的な状態レイヤーが、例外のライフサイクル全体を記録します。エージェントの推論トレース、認証済み ID を伴うツールの呼び出し、人間へのエスカレーションイベント、解決結果を、すべて不変(immutable)で追記専用(append-only)のレコードとして保持します。リアルタイムのオブザーバビリティがエージェントのパフォーマンスを監視し、振る舞いが想定されるベースラインから逸脱した際に運用チームへ通知します。
リファレンスアーキテクチャ
高いレベルで見ると、本アーキテクチャは ERP の例外をスケジュールに従って検知し、AI エージェントを呼び出して該当する SOP を取得し、SAP および接続されたシステム全体で例外を解決し、監査コンプライアンスのためにあらゆるステップをログ記録します。信頼度が低い場合や承認が必要な場合、エージェントは人間へエスカレーションし、返答を受け取ると再開します。
下記の図 1 は、エンドツーエンドのアーキテクチャを示しています。このアーキテクチャには 3 つの境界があります。お客様の SAP 環境、AWS クラウド、そしてオプションのユーザーインターフェイスです。ここでは、単一の例外が検知から解決までシステム内をどのように流れるかを説明します。
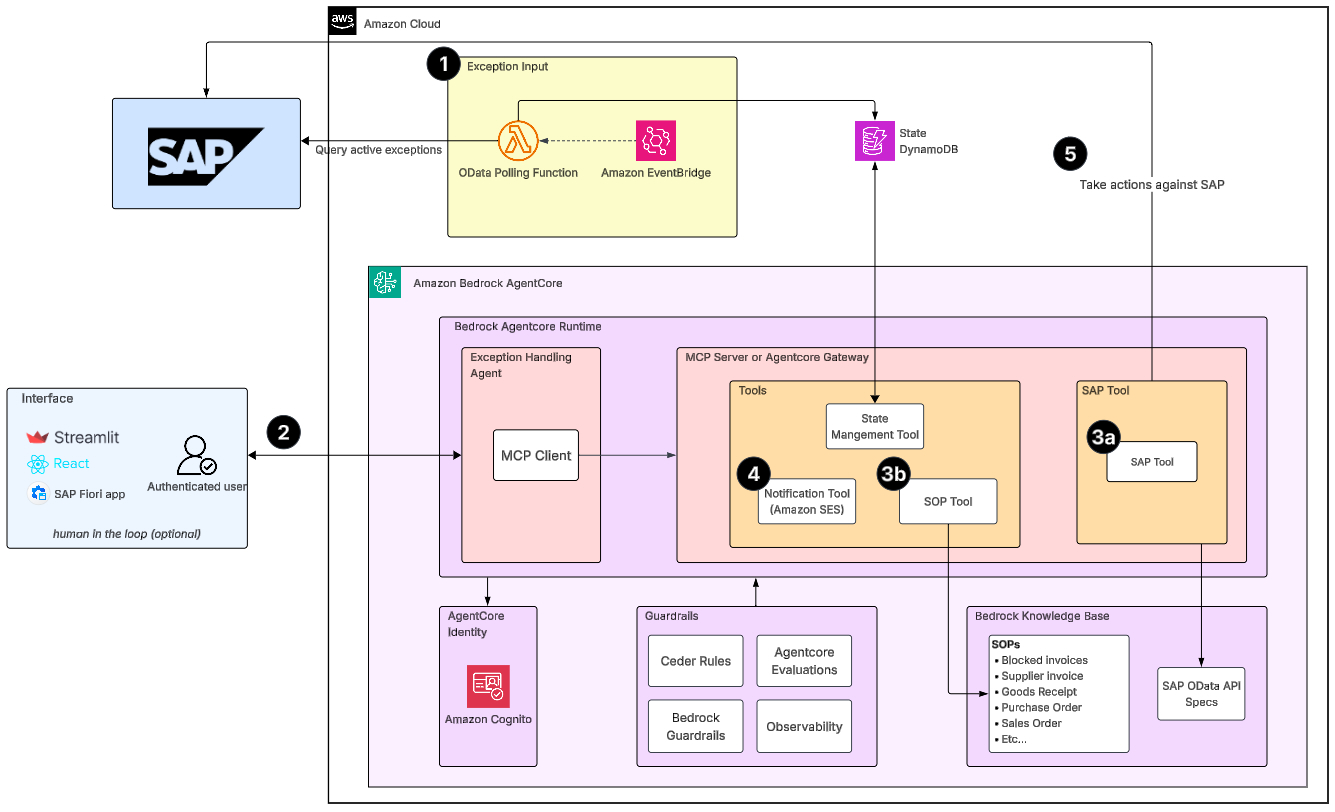
-
- 例外検知(Exception Detection): Amazon EventBridge が、設定可能なスケジュール(デフォルト:5 分ごと)で AWS Lambda 関数をトリガーし、SAP OData サービスをポーリングして新しい例外(ブロックされた請求書、突合できない支払い、欠落した引当金、または SOP が定義する任意の例外タイプ)を検出します。
- 状態の初期化(State Initialization): ポーラーは、新しい例外ごとに Amazon DynamoDB の状態テーブルへ status を detected として書き込み、解決に必要な最小限のコンテキスト(PO 番号、総勘定元帳(GL)アカウント、コストセンター)を記録します。重複排除チェックにより、同じ例外が二重に処理されるのを防ぎます。
- エージェントの呼び出し(Agent Invocation): システムは、DynamoDB Streams トリガー経由で自律的に、またはユーザーインターフェイスを通じて手動で、エージェントを呼び出します。エージェントは、AI エージェントの構築・デプロイ・スケーリングのためのフルマネージドサービスである Amazon Bedrock AgentCore 上で稼働し、エージェントフレームワークには AWS のオープンソースのエージェント型 SDK である Strands を使用します。
- ツール接続(Tool Connectivity): カスタム統合コードなしにエージェントへ SAP やその他のシステムへのアクセスを与えるため、マネージドな 2 つの経路のいずれかで接続します。
- AgentCore Runtime 上でホストされる MCP サーバー(サンプルコードに含まれています)
- 大規模でマネージド・ガバナンスされたツールアクセスのための AgentCore Gateway
- SOP の取得(SOP Retrieval): すべての解決が承認済みのプロセスに従うことを検証するため、エージェントの最初のツール呼び出しは、エンタープライズコンテンツをインデックス化・チャンク化・取得するフルマネージドの RAG 機能である Amazon Bedrock Knowledge Base から該当する SOP を取得し、処理対象の例外タイプに対する意思決定ツリーを確立します。
- SAP の実行(SAP Execution): ハードコードされた API マッピングを排除し、保守負担を軽減するため、エージェントは SAP OData API 仕様を含む 2 つ目の Knowledge Base を使用して、正しいエンドポイントとフィールドを実行時に発見し、SAP に対して読み取り・書き込み操作を実行します。これにより、ハルシネーションによる API 呼び出しを防ぎます。エージェントは、ドキュメント内に見つけられるエンドポイントのみを呼び出します。
- 監査証跡(Audit Trail): 各ステップで、エージェントは DynamoDB 内の不変な processing_history リストに追記し、以下を記録します。
- 推論トレース: ステップごとのロジックと取得した SOP のセクション
- ツールの呼び出し: 入力、出力、タイムスタンプ、認証済み ID
- 解決結果: 実行された最終アクションと SAP のトランザクション参照
- この追記専用ログ(レコードは追加できるが、変更・削除は決してできない)が、SOX と内部監査コンプライアンスのための改ざん検知可能な監査証跡となります。
- 人間へのエスカレーション(Human Escalation): 例外が人間の判断を要する場合(金額が重要性のしきい値を超える、またはエージェントの信頼度が定義済みのレベルを下回る場合)、エージェントは Amazon SES 経由で構造化されたエスカレーションメールを送信し、ケースのステータスを awaiting_human_input に更新して停止します。
- 人間の応答(Human Response): 人間が返信すると、SES はそのメールを Amazon S3 に保存し、これが Lambda 関数をトリガーします。この関数はメールスレッド全体を解析し、その応答とともにエージェントを再呼び出しします。エージェントは、完全なコンテキストの連続性を保ったまま、中断したところから正確に処理を再開します。
- インターフェイスレイヤー(Interface Layer): ユーザーインターフェイスは意図的に薄く、差し替え可能です。サンプルコードには Streamlit ダッシュボードが同梱されていますが、AgentCore ランタイムのエンドポイントを呼び出せるクライアントであれば何でも動作します。
- React またはカスタム Web アプリ
- ネイティブな SAP 統合のための SAP Fiori タイル
- Amazon Quick Apps:ガバナンスされたノーコードの承認体験のため
- インターフェイスをまったく持たない:完全に自律的な運用のため
例:購買発注の引当計上を大規模に自動化する。あるグローバル製造企業は、このフレームワークを適用して、1,000 件を超えるアクティブな PO にまたがる 2 億 5,000 万ドル超のカスタム治工具の購買を管理しました。エージェントは該当する SOP を自律的に取得し、各 PO を適切なワークフローで解決し、財務承認のための仮伝票(parked journal entry)を SAP に作成します。以前は 1 決算サイクルあたり 30 日超の手作業を要していたプロセスが、今では PO あたり数分で完了します。
技術的ベストプラクティス
デモで動作するエージェント型システムを作るのは簡単です。プロダクショングレードの信頼性、監査可能性、コスト効率には、意図的なエンジニアリング上の選択が求められます。以下のプラクティスは、プロダクション環境でのデプロイから得られたもので、最も一般的なギャップに対処します。
決定論(Determinism)
同じ入力は、同じ出力を生成しなければなりません。これは、単一のメカニズムではなく、階層化された制御によって達成します。
- 構造化されたプロンプト: 明示的なテンプレート、システムレベルのルール、振る舞いのフック、出力フォーマットの制約を用いて、推論を定義済みのパターンに固定します。
- 検索拡張生成(RAG): Amazon Bedrock Knowledge Bases を介して、あらゆる応答を取得した SOP コンテンツとライブシステムデータにグラウンディングし、エージェントがパラメトリックな記憶ではなく信頼できる情報源から推論するようにします。
- 実行時ガードレール: コンテキストのグラウンディング検証とポリシーベースのコンテンツフィルタリングのために Amazon Bedrock Guardrails を適用します。
- マルチエージェントによる相互検証: リスクが高い場合は、スーパーバイザーエージェントを用いて専門のサブエージェントをオーケストレーションし、アクション実行前に推奨事項をクロス検証します。
ID の伝播(Identity Propagation)
すべてのエージェントのアクションを適切な ID に帰属させなければなりません。本アーキテクチャは、デュアル ID モデルをサポートします。
- 自律運用: エージェントは OAuth 2.0 の 2 レッグ(2LO)認証により自身のサービスアカウントで認証し、各ダウンストリームシステムとのマシン間の信頼関係を確立します。
- ヒューマン・イン・ザ・ループ運用: AgentCore Identity が OAuth 2.0 の 3 レッグ(3LO)認証へ移行し、人間の検証済み ID をエージェントを通じて対象システムへ伝播します。
この分離により、コンプライアンスチームは監査ログにおいてエージェントが起動したアクションと人間が承認したアクションを明確に区別できます。これは SOX 統制の中核的な要件です。
Cedar ポリシーによるきめ細かな認可
誰が動作しているかを把握することは必要ですが、それだけでは十分ではありません。各 ID が何をできるかも制御する必要があります。AgentCore Policy は、AWS のオープンソースの認可言語である Cedar を使用し、AgentCore Gateway を経由するすべてのエージェント-ツール間のやり取りに対してきめ細かな権限を強制します。Cedar ポリシーは 4 つの属性を評価します。
- プリンシパル ID: ユーザー名、ロール、スコープなどの OAuth クレーム(上記の 2LO/3LO ID モデルから)
- アクション: 呼び出される具体的なツール(例:invoke_sap_odata_service や send_email)
- リソース: リクエストがルーティングされる Gateway
- リクエストコンテキスト: ツールの入力パラメータ。属性ベースのアクセス制御を可能にします(例:書き込み操作を一定の金額しきい値未満の請求書に制限する)
システムはデフォルトですべてのアクションを拒否します。ポリシーは Cedar 構文または自然言語で作成します。AgentCore Policy は平易な英語のルールを解釈して候補となる Cedar ポリシーを生成し、自動推論を用いて、強制する前に過度に許容的または制限的なポリシーを検出します。たとえば、「エージェントは任意の PO を読み取ってよいが、仕訳を計上できるのは 50,000 ドル未満に限る」といったルールを、ツール呼び出しが SAP に到達する前に、Gateway レイヤーで決定論的に強制できます。よくあるパターンについては、AgentCore Policy のドキュメントをご覧ください。
プロンプトの改善(Prompt Improvement)
システムプロンプトは、決定論が始まる場所です。特に重要なのは 3 つのパターンです。
- 明示的なコンプライアンスのフレーミング: 明示的な優先度シグナル(すべて大文字のラベル、必須を示す表現)を用いて、SOP コンプライアンスを交渉の余地のないものとしてフレーミングします。これにより、モデルが手順に違反する形でワークフローを「最適化」してしまう可能性を減らします。
- ハルシネーション防止のガードレール: 人間の入力を待ってブロックされている際に、証拠や承認をでっち上げるのではなく、停止してエスカレーションするようエージェントに指示します。これは、エージェント型システムで最も危険な失敗モードのひとつに直接対処します。
- 実例(Exemplars): 正しい振る舞いの具体例、日付計算のフォーマット、エスカレーションメールのテンプレート、OData クエリのパターンなどを、プロンプト内に直接含めます。エージェントは、ゼロから生成するよりも参照実装がある方が高いパフォーマンスを発揮します。
実際の例外データを用いてプロンプトを反復改善し、バージョン間で出力品質を追跡します。
評価(Evaluations)
エージェント型システムには、複数のレベルでの評価が必要です。
- ユニットレベル: 個々のツール呼び出しの正しさをテストします。OData クエリは期待どおりのフィールドを返すか? メールには適切なコンテキストが含まれているか?
- エンドツーエンド: 期待される結果を伴う既知の例外シナリオに対して、ワークフロー全体をテストします。解決済みのケースからリグレッションスイートを構築し、プロンプトや SOP の変更が既存の振る舞いを劣化させないようにします。
- 運用メトリクス: ビジネスにとって重要な指標を追跡します。解決精度、エスカレーション率、解決までの時間、誤検知率などです。
- リアルタイム監視: AgentCore 向けの Amazon CloudWatch の生成 AI オブザーバビリティ機能を使用して、モデル呼び出しのレイテンシ、トークン消費量、ツール呼び出しの成功率、信頼度スコアの分布を監視します。
コスト最適化(Cost Optimization)
スケールしても例外あたりのコストを予測可能に保つために:
- モデルを適切なサイズにする: 定型的な例外には小さいモデルを使い、大きいモデルは複雑なケースのために温存します。
- 頻繁に取得するコンテンツをキャッシュする: めったに変わらない SOP ドキュメントや API ドキュメントはキャッシュして、Knowledge Base のクエリ量を削減できます。
- インテリジェントなプロンプトルーティング: Amazon Bedrock のプロンプトルーティングを使用して、呼び出しごとに最もコスト効率の高いモデルを自動的に選択します。
- 運用のレジリエンス: ピーク時のボリュームではジッター付きの指数バックオフを実装し、コストの可視化のために例外タイプ別にトークン消費量を追跡します。
オブザーバビリティと状態管理
運用チームと監査担当者の双方を満足させるため、プロダクションのエージェント型システムには 3 つのレイヤーの状態が必要です。
- 短期セッションメモリ: 単一の解決内でのコンテキスト(会話履歴、ツール呼び出しの結果、中間的な推論)を維持します。
- 長期メモリ: AgentCore Memory を介して、セッションをまたいで学習したパターンを永続化します。たとえば、既知の PO フォーマットの問題により一貫して例外を発生させるベンダーを認識するなどです。
- 永続的な監査水準の状態: DynamoDB 内で、例外のライフサイクル全体を不変で追記専用のレコードとして記録します。推論トレース、認証済み ID を伴うツールの呼び出し、エスカレーションイベント、人間の意思決定、解決結果です。
まとめと次のアクション
エージェント型 AI は、ERP の例外管理の経済性を根本的に作り変えます。プロセスごとに個別のエージェントを構築・保守する代わりに、組織は、実行時に手順を解釈し、適切なツールを呼び出し、状況が求めるときに人間の判断へエスカレーションできる、単一の SOP 駆動エージェントをデプロイできます。漸進的な導入フレームワークは、自動化が信頼を確立した分だけ拡大することを検証し、ID を意識したアーキテクチャは、エージェントが起動したものであれ人間が承認したものであれ、あらゆるアクションを完全に帰属・監査できることを保証します。
リファレンス実装は、Strands エージェント、SAP OData 統合を備えた MCP サーバー、DynamoDB による状態管理、ヒューマン・イン・ザ・ループのワークフローを含むオープンソースのサンプルコードとして利用可能です。可視化のための Streamlit ダッシュボードも同梱されています。Knowledge Base 内の SOP を更新するだけで、コードを変更することなく、お客様の例外タイプに合わせて適応できます。
まずは、GitHub リポジトリの ERP 例外管理ソリューションをダウンロードし、SAP OData 統合のための AWS for SAP MCP Server をセットアップしてください。
本稿で参照したサービスをより深く知るには、Amazon Bedrock AgentCore、Amazon Bedrock Knowledge Bases、Strands Agents SDK をご覧ください。
著者について
 |
Sagar は、AWS でエージェント型 AI と生成 AI を活用して業務プロセスを自動化し、レガシーシステムをモダナイズすることで、エンタープライズのデジタルトランスフォーメーションを支援することを専門としています。SAP ワークロードに注力し、お客様が AI を用いて移行・モダナイゼーション・自動化を進めるためのツールとソリューションを構築しています。仕事以外では、テクノロジーへの情熱と、家族と過ごすかけがえのない時間、Formula 1 への深い愛、そして Sachin Tendulkar のクリケットの功績への変わらぬ敬意とのバランスを取っています。 |
 |
Zach Daniels は、AWS のソリューションアーキテクトで、AWS for SAP を専門とし、ERP 向けのエージェント型 AI アプリケーションに注力しています。お客様と協働して、スケーラブルで Well-Architected な SAP 環境を AWS 上で設計しています。シアトルを拠点とし、スタートアップと技術エンジニアリングでの経験をエンタープライズのお客様との仕事に活かしています。 |
 |
Abhijeet は、複数の業界にまたがって戦略とデリバリーを主導してきた、20 年以上の SAP テクノファンクショナル経験を持つデータ・AI リーダーです。AWS の SAP データアナリティクス戦略、エージェント型コードモダナイゼーション、AI 駆動のプロセス自動化イニシアチブを牽引しています。コロラドの山でのハイキングとスキーを楽しんでいます。 |
本ブログの翻訳は Amazon Quick による自動翻訳を行い、パートナー SA 松本がレビューしました。原文はこちらです。