Amazon Web Services ブログ
AWS Physical AI Toolchain を発表
本記事は 2026 年 10 月 7 日に公開された “Introducing AWS Physical AI Toolchain” を翻訳したものです。
フィジカル AI ポリシーのトレーニングとデプロイを AWS 上で大規模に行うための、エンドツーエンドのソリューション
フィジカル AI はロボット、自動運転車、スマートファクトリーなどを通して現実世界で稼働する人工知能です。Capgemini Research Institute の調査によると、79% の組織がすでにフィジカル AI を活用しており、経営幹部の 60% が、フィジカル AI により、これまでロボットの採用が不可能または現実的ではなかった分野での活用が可能になると考えています。テクノロジーはまさに転換期を迎えています。
しかし、ロボットを実用可能な実験用プロトタイプから信頼性の高い生産システムへと発展させるには、単一のモデルだけでは不十分です。これには、データ収集、合成データ生成、モデルトレーニング、シミュレーションに基づく検証、エッジデプロイを統合するパイプラインが必要です。各段階では、それぞれ異なる計算リソース、異なるツールが求められ、運用上の制約も異なります。このような工程間の引き継ぎにおいて、多くのチームが何か月分ものエンジニアリングの時間を浪費しています。
本日、発表する Physical AI Toolchain on AWS は、AWS 上でフィジカル AI の開発ライフサイクル全体を運用するためのリファレンスアーキテクチャ、Infrastructure as Code、デプロイの自動化機能を 1 つにまとめ、NVIDIA Physical AI スタックと統合したものです。このツールチェーンは特定のロボットやタスクの種類に依存しません。自身の URDF、テレオペレーションデータ、タスク定義を用意するだけで、残りの処理はインフラストラクチャが行います。
フィジカル AI 開発ライフサイクル
フィジカル AI は、閉ループで稼働し、現実世界に対し、感知、判断、実行を継続的なサイクルで行います。これは、モデルがデータを処理し、予測値を画面に返す、従来の ML-Ops とは根本的に異なります。オフラインの評価では高い精度を出せるモデルも、雑然とした倉庫で 6 軸アームを 200 Hz で制御しなければならないとなると、うまく機能しないかもしれません。開発プロセスでは、物理的な力学特性、リアルタイムの制約、センサーノイズ、安全上の境界、遅延、そして現実世界でのテストではハードウェアの破損の可能性がありコストがかかるという現実を考慮する必要があります。
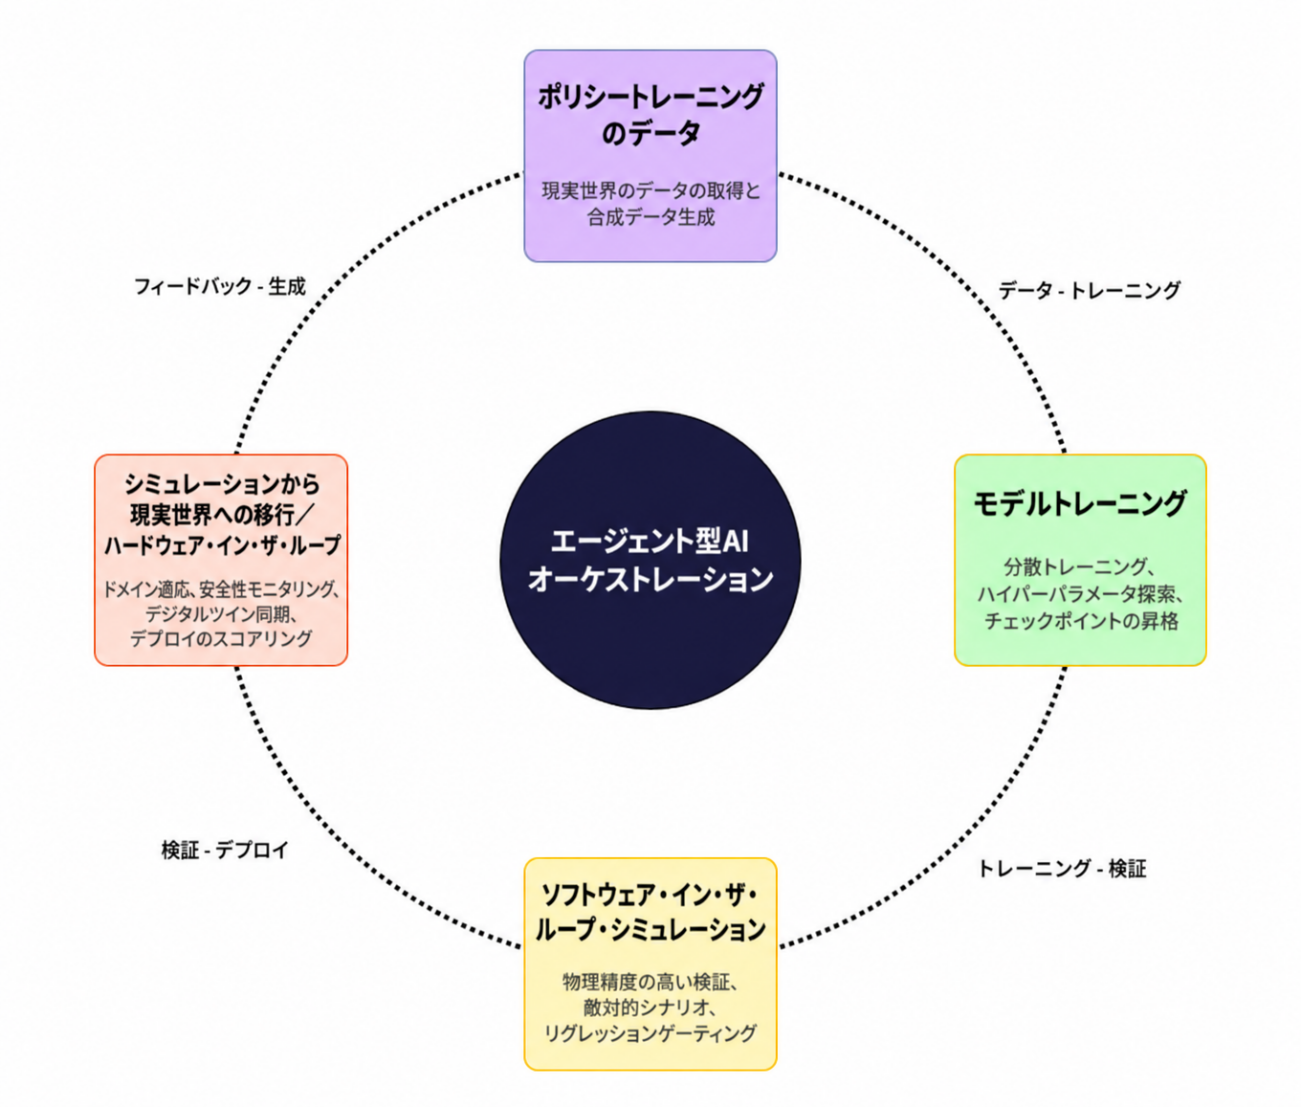
図 1:フィジカル AI 開発ライフサイクル
フィジカル AI のライフサイクルは、直線的なパイプラインではなく、フライホイール(循環構造)です。デプロイされたロボットが新たなデータを生成し、エッジケースを明らかにします。このようなエッジケースは、新たなシミュレーションシナリオの手がかりとなります。シミュレーションにより合成トレーニングデータが生成されます。より向上したモデルは、徐々に難易度を上げたテストによって検証されます。このサイクルを繰り返し、反復のたびにシミュレーションと現実世界のギャップを縮めていきます。
フィジカル AI に専用のツールチェーンが必要な理由
フィジカル AI には汎用的な ML-Ops の前提が通用しません。目的特化型のインフラストラクチャが必要となる 5 つの課題を以下に示します。
- 様々な計算資源の混在:1 つのフィジカル AI のワークフローの中で、基盤モデルトレーニングのための高帯域の GPU クラスター、物理シミュレーションのための柔軟な中位クラスの GPU 容量、ロボット上のリアルタイム推論のためのエッジ GPU が使われます。1 つの計算サービスですべてをカバーすることはできません。
- アーティファクトの乱立:各ロボットリリースには、データセット、シミュレーションシーン、ロボット URDF 記述、キャリブレーションデータ、トレーニングコンテナ、チェックポイント、評価結果、デプロイ可能なエッジパッケージが含まれます。それぞれのステップを横断し、アーティファクトの昇格が制御されていないと、数週間のうちに再現性が失われます。
- 検証の深さ:故障したロボットが再起動した時には、物理世界はすでに変化しています。フィジカル AI は、シミュレーション、監督下での実機テスト、管理された実環境での展開を経て、段階的に昇格させる必要があります。ロボットアームにはシンプルなブルーグリーンデプロイメントに相当するものはありません。
- データの経済性:実機ロボットのデータの収集にはコストがかかります。実環境グレードのポリシーは何百もの異なる環境への対応が求められます。チームには、デモンストレーションデータを、合成データによる拡張や強化学習によって増幅していくループが必要です。
- 制御経路の配置:物理的な動きを決定する推論は、ロボット上の遅延、電力の予算、熱の制約に縛られます。クラウドはトレーニングやロボット群の管理を担いますが、安全に関わる物理タスクの制御ループとなることはできません。
5 つの課題はすべて相関しています。ツールチェーンの価値は、トレーニングスクリプトが 1 つ増えることではありません。データの取り込みからシミュレーション、エッジデプロイに至る整合性のある検証済みのプロセスであり、多くのチームが時間を費やす引き継ぎの部分を担うものです。
Physical AI Toolchain on AWS の発表
Physical AI Toolchain on AWS は、AWS 上でのフィジカル AI 開発ライフサイクル専用に設計された、リファレンスアーキテクチャ、Infrastructure as Code、デプロイ自動化機能を組み合わせた、一般公開されているコレクションです。NVIDIA のロボティクスソフトウェアスタック―視覚・言語・行動(VLA)トレーニング用「GR00T」、物理シミュレーション用「Isaac Sim」、大規模強化学習用「Isaac Lab」、合成データ生成用「Cosmos」、およびワークフローオーケストレーション用「OSMO」―を再現性のある単一のパイプラインに統合し、AWS マネージドサービス上で展開します。このツールチェーンはフィジカル AI の複雑さを捨象するものではありません。これにより、チームは引継ぎのたびに基盤を構築し直すことなく、再現性のある方法で、データ、モデル、シミュレーションジョブ、デプロイメントアーティファクトをステージ間で移行することができます。
オープンスタンダードに基づく構築
ツールチェーンは NVIDIA のコンポーネントに加えて、ロボティクスチームがすでに利用している公開ツールの上に構築されています。Zarr 形式の生データを読み込んでコミュニティ標準の LeRobot 形式に標準化し、PyTorch と Hugging Face で学習を行い、Gymnasium で強化学習タスクを定義し、URDF でロボットを記述し、移植性の高いエッジ推論のために ONNX 形式でエクスポートします。ロボット上の制御は、モデルから ROS 2 に引き継がれます。こうすることで、データやモデルを移植性の高いオープンなフォーマットで保持できます。
設計原則
ツールチェーンは 3 つの設計原則に基づいています。
- モノリシックでなくモジュラー型:各コンポーネント(基盤、Isaac Sim、Isaac Lab、GR00T、OSMO)は独立した Terraform モジュールになっており、1 つずつ段階的に導入することも、パイプライン全体に展開することもできます。モジュールは SSM パラメータを通じてコンフィギュレーションを共有しますが、厳密な依存関係はありません。
- AWS インフラストラクチャ上の NVIDIA ネイティブ:ツールチェーンは AWS のコンピュート、ストレージ、ネットワーキング、セキュリティサービス上で NVIDIA Physical AI スタックを実行します。直接 NVIDIA のドキュメンテーションをフォローしても、クラウドネイティブなデプロイ自動化のメリットを享受できます。
- リニアなパイプラインではなくフライホイール・アウェア:基盤によってフィジカル AI 開発の持つ反復的な特性をサポートします。デプロイからフィードバックされたデータが新たなシミュレーションシナリオに活用されます。生成された合成データが学習に活用されます。学習済みモデルが検証に活用されます。ツールチェーンは決まった順序を強制するのではなく、フライホイール内のあらゆる移行に対応する基盤を提供します。
アーキテクチャ
Physical AI Toolchain on AWS は基盤にある複雑さを抽象化し、開発のフライホイールを AWS ソリューションに当てはめます。このアーキテクチャは意図的に垂直構造にして、各ピラーが独自に AWS のマネージドの基盤上で NVIDIA ドメインレイヤーを備える形になっています。アーキテクチャ全体のボトムレイヤーは Strands エージェントレイヤーで、インテリジェントなコーディネーションを可能にする Strands Agents SDK をもとに構築された AI ドリブンなオーケストレーションレイヤーです。チームは、個別に 1 つのピラーを採用することも、エージェントオーケストレーションで移行を管理し、ピラーを連携させてエンドツーエンドの完全なパイプライン全体を構築することも可能です。
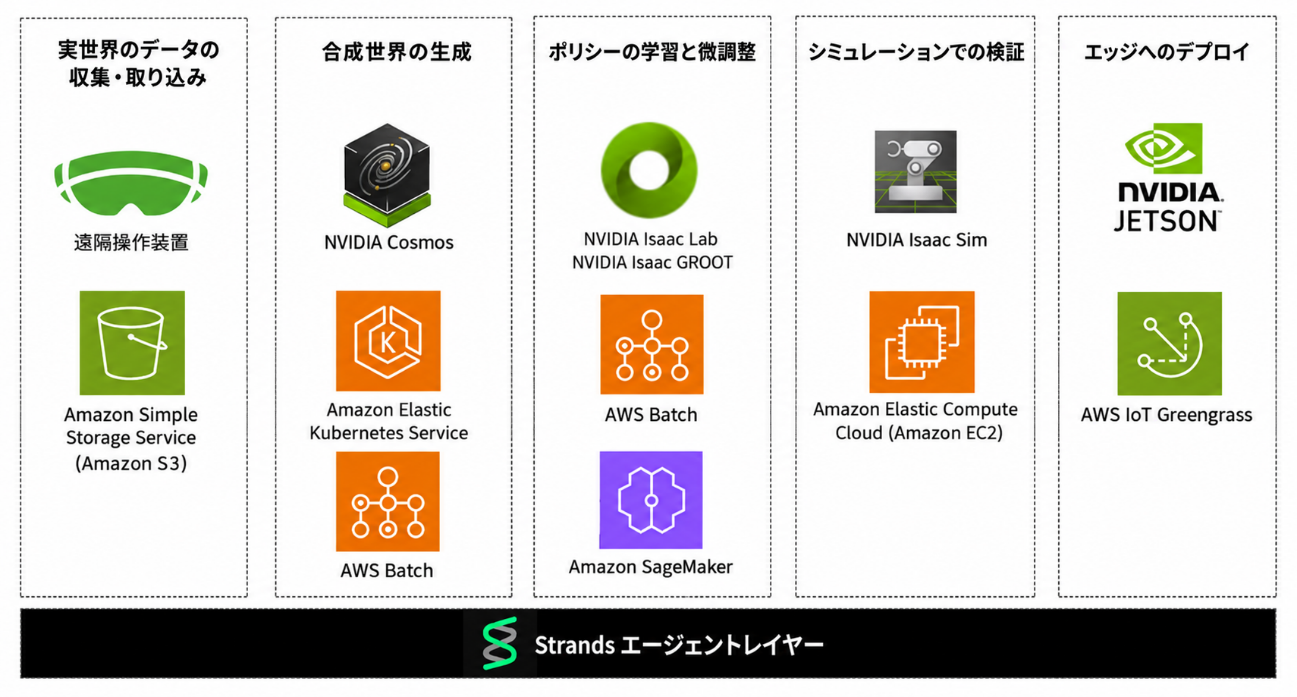
図 2:Physical AI Toolchain on AWS のコンポーネント
データは各ピラーを左から右へと流れます。遠隔操作装置の生データが Amazon Simple Storage Service (Amazon S3) に届き、Amazon Elastic Kubernetes Service (Amazon EKS) や AWS Batch と NVIDIA Cosmos で合成世界の生成が行われ、AWS Batch と Amazon SageMaker で NVIDIA Isaac Lab および Isaac GR00T を使ってポリシー学習、Amazon Elastic Compute Cloud (Amazon EC2) 上の NVIDIA Isaac Sim で検証を実行し、最終デプロイで、AWS IoT Greengrass を使用して、最適化されたモデルを NVIDIA Jetson ハードウェアにプッシュします。Amazon SageMaker や AWS Batch で学習や微調整ジョブを実行することで、実装コストを最適化します。
Strands エージェントレイヤーは一般に公開されている Strands Agents SDK を基に構築され、ツールチェーン全体に AI ネイティブなインターフェースを提供します。チームは各パイプラインのバリエーション向けにカスタムのオーケストレーションスクリプトを書く代わりに、自然言語や構造化されたプロンプトで意図を記述するだけで済みます。あとはエージェントレイヤーが、呼び出すべきコンポーネントを判断し、必要なコンピューティングリソースを割り当て、データの受け渡しを管理し、結果を報告します。
NVIDIA Physical AI スタックの統合
ツールチェーンは NVIDIA Physical AI ソフトウェアスタックと緊密に統合し、AWS の基盤上で展開・運用されます。
NVIDIA はドメイン特化型レイヤーを提供します。
- Isaac Sim:シーン構成、物理的に正確なレンダリング、リアルタイムシミュレーション
- Isaac Lab:数千の並列環境での大規模強化学習
- Isaac GR00T:デモンストレーションに基づく視覚・言語・行動(VLA)モデルの微調整
- Cosmos:世界生成と合成データセットの規模拡大のための視覚データの拡張
- OSMO:異種コンピューティング環境(クラウド、オンプレミス、エッジ)にわたるワークフローのオーケストレーション
- Jetson / RTX:リアルタイム制約下におけるエッジ推論向けのターゲット実行環境ハードウェア
AWS は実行環境を提供します。
- Amazon EC2(NVIDIA GPU インスタンス):シミュレーションおよび合成データ生成
- Amazon SageMaker / AWS Batch:自動プロビジョニング機能を備え、アイドル時コストがゼロのマネージド型トレーニング
- Amazon EKS:GPU スケジューリングを活用した、スケーラブルかつ分散型の OSMO およびクラスターワークロード向け
- Amazon S3、Amazon Elastic Container Registry (Amazon ECR)、Amazon FSx for Lustre:データセット、コンテナ、高スループットなトレーニングデータの配信
- Amazon CloudWatch、AWS Secrets Manager、AWS Key Management Service (AWS KMS)、AWS IoT Greengrass:オブザーバビリティ、セキュリティ、エッジデプロイメント
このツールチェーンはこれら 2 つのスタック間の境界における摩擦を軽減します。AWS はインフラストラクチャのプロビジョニング、デプロイの自動化、セキュリティ・プリミティブ、マネージドサービスの統合に対応します。NVIDIA は、フィジカル AI 担当チームがすでに使用しているシミュレーションエンジン、基盤モデル、オーケストレーションレイヤーを扱います。
対象ユーザー
このツールチェーンは、スケーラブルなトレーニングやロボットポリシーの展開のためにクラウドベースのインフラストラクチャを必要とするロボティクスエンジニア、ML エンジニア、プラットフォームチーム、ソリューションアーキテクトなどを対象に開発されています。直接的にメリットが得られる業界としては、製造・産業オートメーション、倉庫・物流、エネルギー・公益事業、医療・ライフサイエンス、鉱業・建設、農業、航空宇宙・防衛などが挙げられます。ロボットが適応的行動を学習し、導入前にシミュレーションで検証を行い、エッジ環境のリアルタイム制約下で運用しなければならないあらゆるドメインに対応します。ツールチェーンが提供するのは完成したロボットの動作ではなく、インフラストラクチャのパターンやアーキテクチャに関する指針です。
利用について
利用開始を支援するため、AWS は以下のリポジトリでワークショップを提供しています。ご利用には以下が必要になります。
- SageMaker と EC2 の両方で GPU クォータが承認されている AWS アカウント
- コンテナイメージ取得用 NVIDIA NGC API キー
- モデルの重みファイルダウンロードのための Hugging Face トークン
- 費用が発生しないよう、以下のリソース削除手順に従ってください。
ワークショップでは、段階ごとに順を追って、どのようなロボットデータにも対応可能な実例を用いて説明します。設定についての詳細な指示は、リポジトリ内の README ガイドを参照してください。https://github.com/aws-samples/sample-the-physical-ai-toolchain-on-aws
各段階における実践例
ツールチェーンのあらゆる段階に順を追った指示が付いており、具体的なコマンド、設定、予想されるアウトプットが示されています。各モジュールには、そのまま使える独自の実践例が付属しています。例えば GR00T トレーニングの場合、27 の UR3 ピック・アンド・プレイス遠隔操作シナリオが付属しており、モジュールを実行して正常に動作することを確認してから別のユースケースやデータセットに置き換えることができます。モジュールは単独でデプロイすることも、パイプライン全体をエンドツーエンドで構成することも可能です。チームは検証済みの Terraform Infrastructure as Code を基盤として、数時間で評価段階から移行して独自データ上でツールチェーンを実行できるようになり、カスタム統合に数週間もかかることはありません。AWS についてある程度の知識があることを想定していますが、フィジカル AI の専門知識は必須ではありません。指示書には段階が進むごとに関連用語や概念の解説がついており、参考資料としてフィジカル AI 用語集も添付されています。
まとめ
Physical AI Toolchain on AWS は、フィジカル AI を単一のトレーニングジョブとしてではなく、ライフサイクル全体にわたる課題として捉えています。本ツールチェーンは、データの取り込み、模倣学習、強化学習、合成データ生成、シミュレーション、オーケストレーション、そしてエッジへのデプロイに至るまで、AWS におけるリファレンスアーキテクチャのパターンを提供し、NVIDIA のロボティクススタックと初日から統合されています。推奨されるアプローチは、現在のボトルネックを解消する一つのコンポーネントから着手することです。ゼロから始める場合は、まず Foundation と OSMO をデプロイすることで、フライホイール全体を一元管理するコントロールプレーンを構築できます。ぜひツールチェーンをお試しいただき、issue の登録やコメント欄でのフィードバックをお寄せください。本プロジェクトにご貢献いただいたすべてのビルダーの皆さんに感謝いたします。