Amazon Web Services ブログ
AWS Lambda が Lambda Managed Instances 上のイベント関数向けに GPU インスタンスをサポートするようになりました
AWS Lambda Managed Instances (LMI) 上で実行されるイベント関数向けに、EC2 G シリーズ GPU インスタンスの GPU サポートが利用可能になりました。機械学習推論、メディア処理、レンダリング、科学技術計算などの GPU アクセラレーションによるワークロードを、サーバーレスのシンプルさで GPU インスタンス上で実行できるようになりました。GPU アクセラレーションによる関数は、コンテナ (Open Container Initiative、OCI) イメージとしてデプロイされます。OCI イメージをビルドして関数に指定するだけで、Lambda がプロビジョニング、スケーリング、イベント統合を処理します。GPU ドライバー、CUDA バージョン、AMI を突き合わせる必要はなく、クラスターやデバイスプラグインを運用する必要もありません。GPU アクセラレーションによる関数は、すでに Amazon EC2 の料金体系とサーバー管理不要の専門的なコンピューティングを提供している Lambda Managed Instances の同じ基盤上で実行されます。
なぜこの機能が求められるのか
お客様からは、サーバーレスのシンプルさで GPU ワークロードを実行したいという声が絶えません。自前で管理する GPU インフラストラクチャ上に構築する場合、インスタンスの選択、GPU ドライバーと CUDA ライブラリのインストールと整合、キャパシティの計画、スケーリングロジックの作成、GPU ステップをアプリケーションの残りの部分に接続するイベント統合の手作業での構築が必要になります。その作業を隠蔽するサーバーレス GPU サービスは、多くの場合、AWS 環境の外にあり、ネイティブのイベントソース、アイデンティティ、ネットワーキングを備えていません。
コストは二つ目の課題です。GPU は高価であり、単一のワークロードで GPU を飽和させることはまれなため、通常は使用率が低くなります。小規模な推論タスクでは、プロビジョニングした GPU の大部分がアイドル状態のまま、全体の料金を支払うことになります。
この機能は、その両方のギャップを埋めます。関数を用意するだけで、Lambda が数分で GPU 上で実行します。他の Lambda イベント関数と同じ AWS イベントによってトリガーされ、同じ方法で課金およびセキュリティ保護されます。また、関数をインスタンスに集約し、同時リクエストにわたって GPU をビジー状態に保つことで、支払うすべての GPU の使用率を最大化します。
構築できるもの
Lambda Managed Instances 上の GPU アクセラレーションによるコンピューティングを使用して、AI/ML 推論と ML 以外のワークロードの両方を実行できます。この機能は、トレーニングではなく推論に、また Amazon Bedrock などのサービスですでに利用可能な大規模基盤モデルではなくカスタムモデルに最適化されています。一般的なワークロードには次のものがあります:
- カスタムモデル推論: 決定モデル (Strands Decider など)、コンピュータビジョン、音声認識と音声合成、レコメンデーション、ドキュメント分析、アプリケーションの一部としてデプロイされる中小規模の言語モデル。
- エージェント型およびイベント駆動型 AI: AWS イベントによって直接トリガーされ、Lambda プログラミングモデルの残りの部分と組み合わせられるカスタム推論。
- メディア処理とトランスコーディング: アップロード時にトリガーされる動画および画像パイプライン。
- 3D レンダリングと生成メディア: フレームおよびアセットのレンダリング、拡散、テキストから動画への生成。
- 科学技術計算と財務モデリング: シミュレーション、行列計算、リスク分析。
Lambda プログラミングモデルの一部
GPU アクセラレーションによる関数は、より大きなアプリケーションの一つのステップであり、Lambda の残りの部分と組み合わせることができます。Lambda durable functions は、チェックポイントと自動復旧を備え、GPU ステップを中心とした多段階の長時間実行ワークフローをオーケストレーションします。Lambda MicroVMs は、信頼できないコードやモデル生成コードを分離されたステートフルなサンドボックスで実行します。エージェント型ワークロードでは、MicroVM が CPU 上でツール使用ロジックを実行し、その後、推論のために Lambda Managed Instances 上で実行される GPU アクセラレーション関数を呼び出します。
GPU アクセラレーションによる関数は、Lambda Managed Instances の拡張された関数タイムアウトもサポートしており、非同期呼び出しと イベントソースマッピング呼び出しでは最大 90 分間実行できるため、メディアトランスコーディングや多段階推論などのバッチおよびその他の長時間実行 GPU ジョブを再設計せずに実行できます。GPU アクセラレーションによる関数は、最大 32 GB のコンテナイメージ (ファイルあたり 10 GB)、最大 32 GB のエフェメラルストレージ、2,048~32,768 MB のメモリ、3~48 GB のアクセラレータメモリ、実行環境あたり最大 48 件の同時リクエスト、キャパシティプロバイダーあたり最大 15,000 vCPU をサポートします。
試してみましょう
実際にどのようなものかを示すため、Hugging Face のオープンソース大規模言語モデル (LLM) を Lambda 関数としてデプロイし、プロンプトを送信しました。Lambda の vLLM ベースイメージを使用すると、推論コードを記述することなく、MODEL_ID 環境変数に Hugging Face モデル ID を設定するだけで済みました。Qwen/Qwen2.5-1.5B-Instruct を使用しました。これは、要約、分類、抽出などのアプリケーション内タスクに適した、小規模な指示チューニング済みモデルです。フローは四つのステップで構成されます: キャパシティプロバイダーを作成し、コンテナイメージをビルドしてプッシュし、そのイメージから関数を作成して、公開して呼び出します。開始する前に、G シリーズインスタンスのクォータ (実行中のオンデマンド G および VT インスタンスとして表示されます) の引き上げをリクエストしてください。新しいアカウントではクォータが 0 から始まる場合があるためです。詳細については、オンデマンドインスタンスのクォータを参照してください。
まず、Lambda が使用できる GPU インスタンスタイプを指定し、自動スケールするように任せるキャパシティプロバイダーを作成しました。複数のインスタンスタイプを指定すると、Lambda は利用可能な中で最もコスト効率の高いものを選択し、容量が逼迫しているときは世代をまたいでフォールバックできます。
{
    "CapacityProviderName": "lmi-gpu-cp",
    "VpcConfig": {
        "SubnetIds": ["subnet-aaaa", "subnet-bbbb", "subnet-cccc"],
        "SecurityGroupIds": ["sg-aaaa"]
    },
    "PermissionsConfig": {
        "CapacityProviderOperatorRoleArn": "arn:aws:iam::111122223333:role/lmi-operator-role"
    },
    "InstanceRequirements": {
        "AllowedInstanceTypes": [
            "g5.2xlarge", "g6.2xlarge", "g6e.2xlarge"
        ]
    },
    "CapacityProviderScalingConfig": {
        "ScalingMode": "Auto",
        "MaxVCpuCount": 96
    }
}
aws --region us-east-2 \
  lambda create-capacity-provider \
  --cli-input-json file://cli-skeletons/create-capacity-provider_gpu.json
Lambda コンソールには、新しいキャパシティプロバイダー lmi-gpu-cp が Active 状態で表示されます。VPC 設定とそのサブネット、セキュリティグループを確認してください。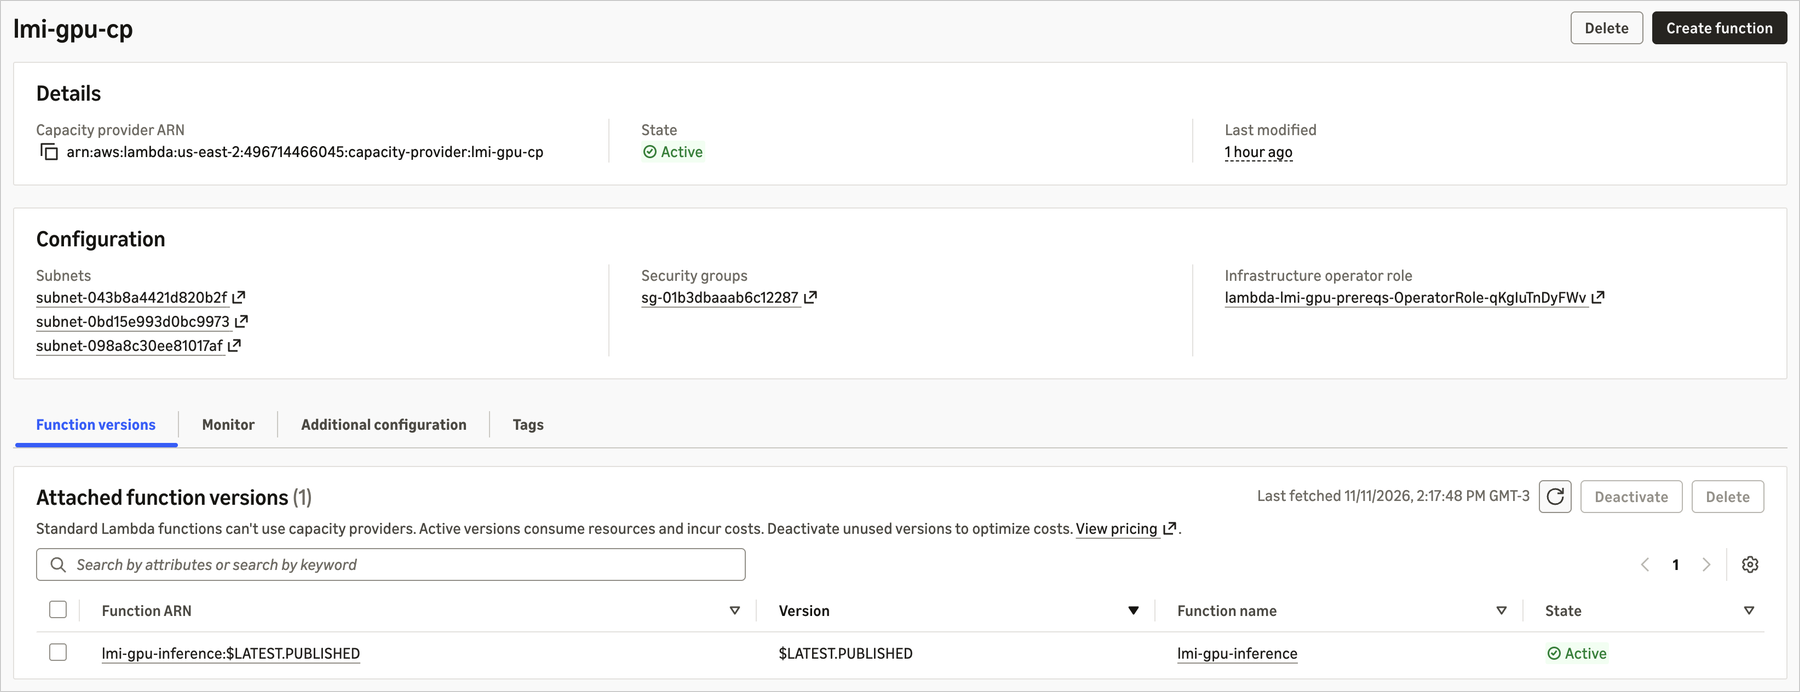
図 1: キャパシティプロバイダーは VPC 設定とともに Active です。
次に、コンテナイメージをビルドしました。Lambda は、vLLM 推論サーバー、PyTorch、Transformers、CUDA ツールキットに加えて、同時呼び出しをサポートするランタイムインターフェイスクライアントを含む、厳選された vLLM ベースイメージ を提供します。このイメージがモデルの提供を担当するため、ハンドラーや推論サーバーのコードを書く必要はありません。Dockerfile 全体は一行です:
FROM public.ecr.aws/lambda/deep-learning-containers/vllm:cuda-v1
Amazon ECR にイメージをプッシュした後、関数を作成しました。MODEL_ID 環境変数でモデルを選択しました。この変数には、Hugging Face または ModelScope のリポジトリ、Amazon S3 のロケーション、またはローカルパスを指定できます。Lambda はモデルをダウンロードし、GPU メモリを管理して、リクエストを処理します。Qwen2.5-1.5B-Instruct は公開モデルであるため、Hugging Face トークンは不要でした。プライベートモデルやゲート付きモデルの場合、またはダウンロードのレート制限を高めるには、HF_TOKEN を設定することもできます。
GPU アクセラレーション関数は、アクセラレータメモリを要求するために AcceleratorConfig を使用します。AcceleratorMemorySize は関数に必要な最小 GPU メモリであり、Lambda はそれを満たす利用可能な最小の GPU に実行環境を配置するため、取得される GPU は要求した以上のメモリを持つ場合があります。PerExecutionEnvironmentMaxConcurrency をデフォルトの 4 に設定しました。vLLM サーバーは GPU 上で同時リクエストをバッチ処理するため、呼び出しはモデルの一つのコピーを共有し、GPU はビジー状態のままです。また、ExecutionEnvironmentMemoryGiBPerVCpu を 4 に設定しました。これにより、関数に必要な 16,384 MB のメモリと 4 vCPU が割り当てられ、2xlarge インスタンス上には Lambda の管理コンポーネント用の容量が残ります。
{
    "FunctionName": "lmi-gpu-inference",
    "PackageType": "Image",
    "Code": { "ImageUri": "111122223333.dkr.ecr.us-east-2.amazonaws.com/lmi-gpu-inference:latest" },
    "Role": "arn:aws:iam::111122223333:role/lmi-gpu-inference-execution-role",
    "Timeout": 900,
    "MemorySize": 16384,
    "EphemeralStorage": { "Size": 32768 },
    "Environment": { "Variables": { "MODEL_ID": "Qwen/Qwen2.5-1.5B-Instruct" } },
    "CapacityProviderConfig": {
        "LambdaManagedInstancesCapacityProviderConfig": {
            "CapacityProviderArn": "arn:aws:lambda:us-east-2:111122223333:capacity-provider:lmi-gpu-cp",
            "ExecutionEnvironmentMemoryGiBPerVCpu": 4,
            "PerExecutionEnvironmentMaxConcurrency": 4
        }
    },
    "AcceleratorConfig": { "AcceleratorMemorySize": 16 }
}
aws --region us-east-2 \
  lambda create-function \
  --cli-input-json file://cli-skeletons/create-gpu-llm-function.json
関数の概要を見ると、これが GPU アクセラレーション関数である理由がわかります。GPU インスタンスを供給するアタッチ済みのキャパシティプロバイダーと、Amazon ECR からデプロイされた vLLM コンテナイメージが、すでに使用している同じ関数モデルに組み込まれています。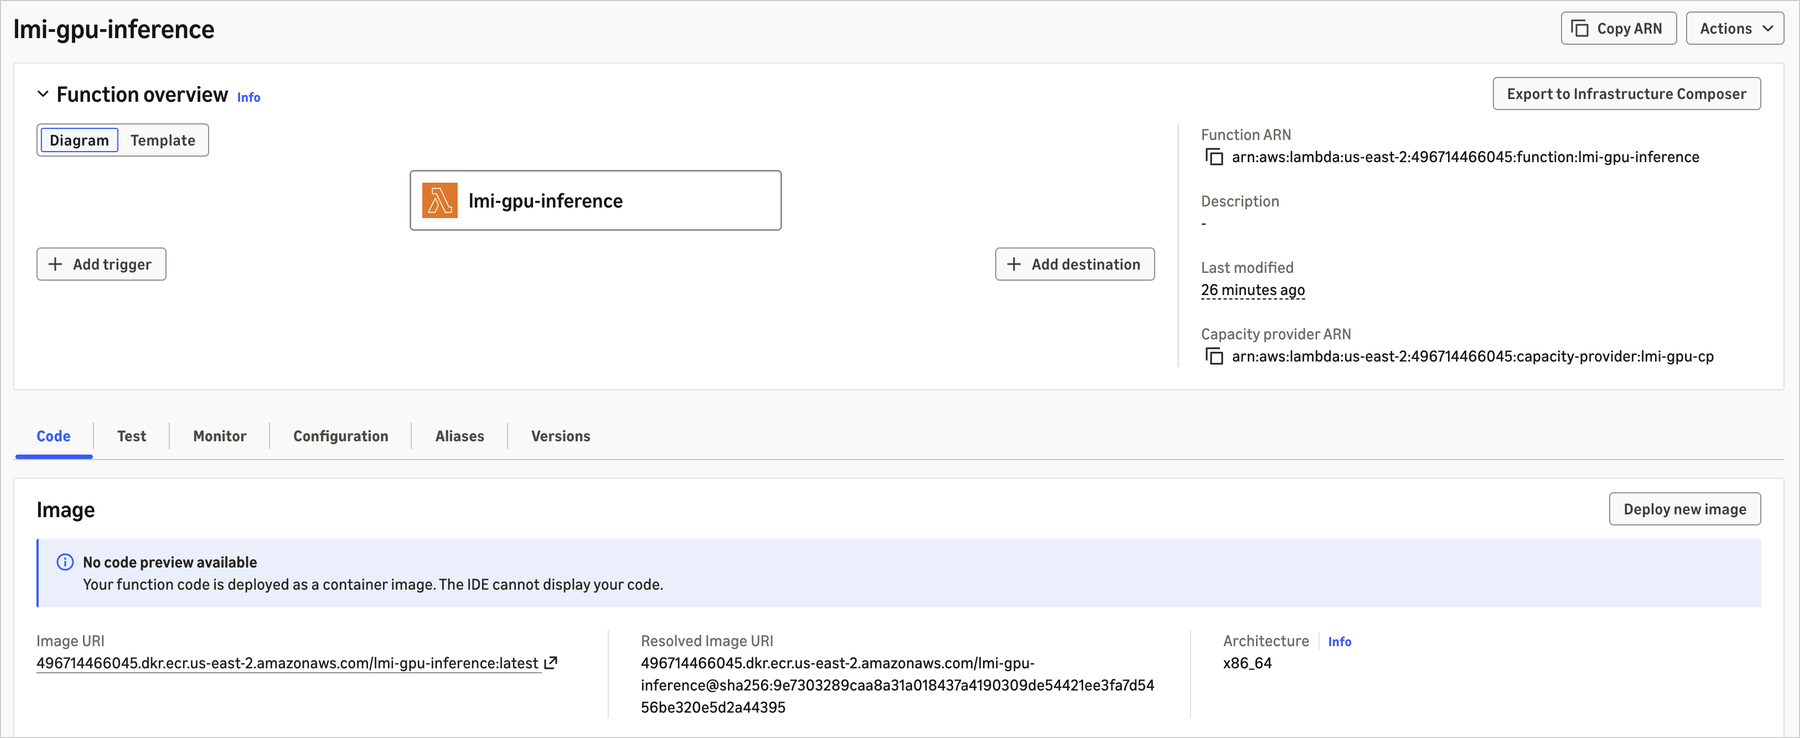
図 2: lmi-gpu-inference 関数の概要。アタッチされたキャパシティプロバイダーと、Amazon ECR からデプロイされた vLLM コンテナイメージを示しています。
Lambda Managed Instances 上の関数は公開済みバージョンから実行されるため、バージョンを 1 つ公開しました。公開すると実行環境がプロビジョニングされ、各実行環境はバージョンが有効になる前にモデルの重みをダウンロードしてエンジンをウォームアップします。コールドスタートは公開ステップ中に発生するため、最初の呼び出し元は待たされません。
aws --region us-east-2 \
  lambda publish-version \
  --function-name lmi-gpu-inference \
  --publish-to LATEST_PUBLISHED
次に、モデルにプロンプトを送信しました。ペイロードは標準の OpenAI リクエストボディです。messages 配列はチャット補完にルーティングされ、prompt フィールドはテキスト補完にルーティングされます。
aws --region us-east-2 \
  lambda invoke \
  --function-name 'lmi-gpu-inference:$LATEST.PUBLISHED' \
  --cli-binary-format raw-in-base64-out \
  --payload '{"messages": [{"role": "user", "content": "サーバーレス GPU 推論を一文で説明してください。"}], "max_tokens": 128}' \
  /dev/stdout
モデルは Lambda 実行環境内の GPU から応答し、レスポンスは標準の OpenAI 補完オブジェクトであるため、OpenAI 互換のクライアントであればどれでも動作します。
{
  "model": "Qwen/Qwen2.5-1.5B-Instruct",
  "choices": [
    {
      "message": {
        "role": "assistant",
        "content": "サーバーレス GPU 推論は、インフラストラクチャの管理やメンテナンスを必要とせずに、NVIDIA GPU で機械学習モデルを効率的に実行できるクラウドベースのサービスです。"
      },
      "finish_reason": "stop"
    }
  ],
  "usage": { "prompt_tokens": 39, "completion_tokens": 31, "total_tokens": 70 }
}
四つの同時呼び出しは、GPU メモリ内でモデルの一つのコピーを共有する一つの実行環境上で、一回の呼び出しとほぼ同じ時間で完了しました。Hugging Face のモデル ID から、稼働する OpenAI 互換の GPU エンドポイントまで約 10 分でした。その大半は、Lambda がキャパシティをプロビジョニングしてモデルをウォームアップしている間の無人実行でした。
これは、推論サーバーのコードも GPU ドライバーもクラスターの管理も不要な、動作する LLM エンドポイントです。別のモデルを試すには、MODEL_ID を更新して新しいバージョンを公開するだけで、イメージの再ビルドは不要です。各バージョンは不変のスナップショットであるため、異なるモデルを別々のバージョンとして並行して実行できます。また Lambda イベント関数でもあるため、Amazon SQS キューからトリガーしてドキュメントをバッチ処理したり、Amazon API Gateway を前に置いたり、Lambda durable functions ワークフローの推論ステップとして呼び出したりできます。
本番環境では、モデルの重みを同じリージョンの S3 バケットにコピーし、MODEL_ID をそのバケットに向け、VLLM_LOAD_FORMAT=runai_streamer を設定して、重みがメモリに直接ストリーミングされるようにします。これにより起動が速くなり、Hugging Face Hub への依存がなくなります。詳細なガイダンスについては、推論ワークロードを実行するためのベストプラクティスを参照してください。LLM 推論以外にも、カスタム ML 推論、メディア処理、その他の GPU ワークロードを実行できます。ベストプラクティスについては、Lambda ドキュメントを参照してください。
設定タブには、GPU アクセラレーション関数にとって重要な設定が表示されます。16,384 MB のメモリ、15 分のタイムアウト、ダウンロードした重み用の 32 GB のエフェメラルストレージに加えて、関数レベルのキャパシティプロバイダー設定として、環境ごとの並列実行数 4、メモリ対 vCPU 比 4:1、16 GB のアクセラレータメモリが表示されます。
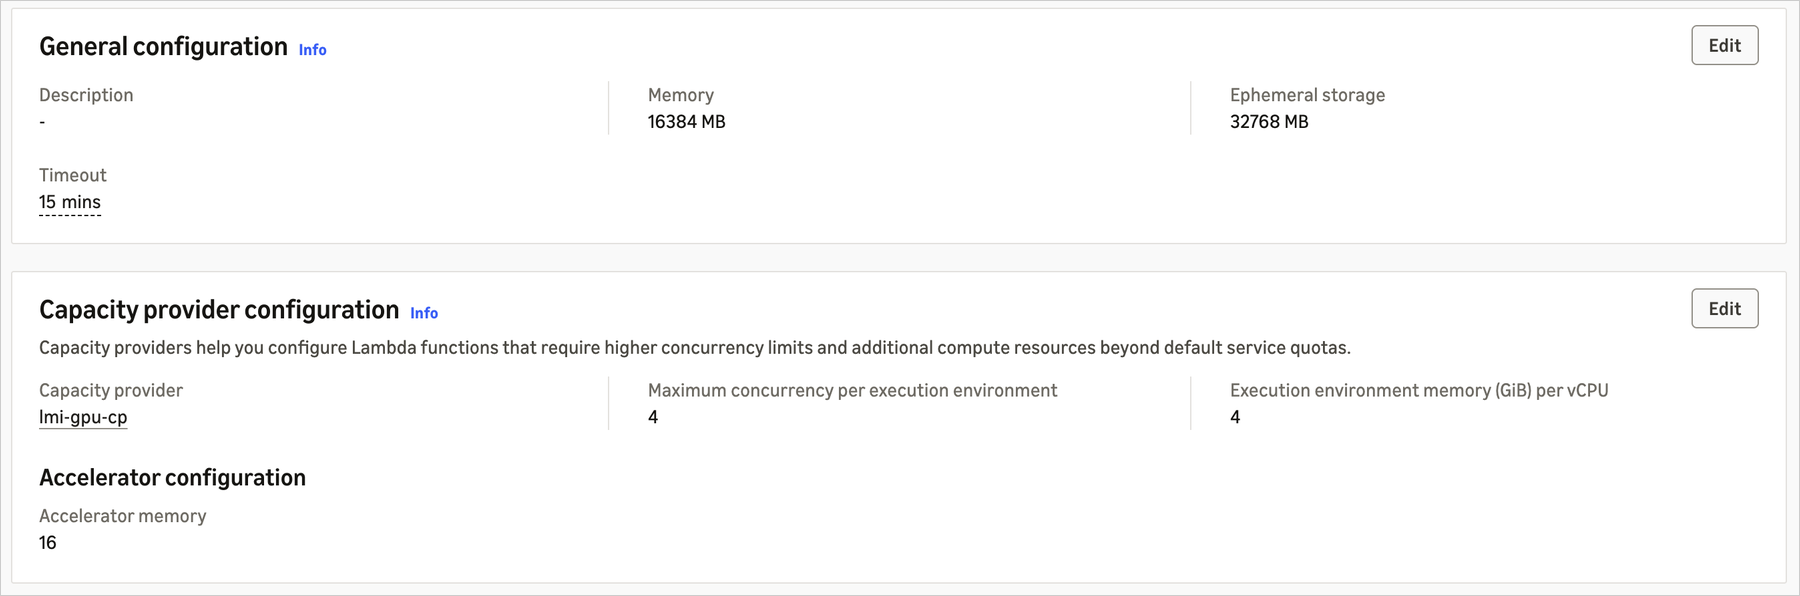
図 3: メモリ、タイムアウト、32 GB のエフェメラルストレージを含む関数の設定、および関数レベルのキャパシティプロバイダー設定 (環境ごとの並列実行数、メモリ対 vCPU 比、アクセラレータメモリ)。
テストが完了したら、関数を削除してからキャパシティプロバイダーを削除してください。そうすることで Lambda が GPU インスタンスを停止し、その料金の支払いが止まります。
仕組み
以下の機能は標準で利用でき、いずれも本来お客様が行う必要のある GPU 作業を不要にします。
GPU ソフトウェアのセットアップをスキップ。 キュレーションされたベースイメージではフレームワークとツールが用意済みのため、インストールや整合性の調整は不要です: base:cuda (CUDA ツールキットとランタイム)、cupy:cuda (CuPy、NumPy、SciPy、Pandas、Numba)、pytorch:cuda (PyTorch、torchvision、torchaudio、transformers、FFmpeg)、およびサービングイメージ vllm:cuda と sglang:cuda。そのまま使用することも、拡張することも、完全にカスタムなイメージを持ち込むこともできます。
GPU インフラの運用は不要。 Lambda がドライバーの互換性、プロビジョニング、ルーティング、ロードバランシングを処理するため、GPU フリートを運用する代わりに関数をデプロイできます。任意の Lambda イベント関数と同じコンソール、CLI、AWS CloudFormation、AWS CDK、AWS SAM、Terraform のワークフローでデプロイできます。
任意の AWS イベントから GPU 処理をトリガー。 イベント関数をトリガーする 200 以上もの同じイベントソース (Amazon S3、Amazon SQS、Amazon API Gateway、Amazon EventBridge など) が、同じスケーリング、エラーハンドリング、リトライで GPU アクセラレーション関数を直接トリガーします。カスタム統合コードは不要です。
各 GPU で同時リクエストを処理。 各実行環境は同じ GPU 上で複数の同時呼び出しを処理でき、これは環境ごとの並列実行数設定で制御します。この値を上げると各 GPU インスタンスにより多くのリクエストを詰め込んで使用率を高めるため、すでに支払っている容量からより多くのスループットを得られます。
複数のインスタンスタイプ。 複数のインスタンスタイプまたは世代を指定すると、Lambda が利用可能な中で最もコスト効率の高いオプションを選択し、リスト内でフォールバックして容量不足エラーを減らします。
キャパシティオプション。 GPU インスタンスは Amazon EC2 オンデマンドインスタンスとして実行され、既存の Savings Plans と Reserved Instances を適用できます。GPU の可用性を予測可能にするには、キャパシティプロバイダー設定に一致する EC2 オンデマンドキャパシティ予約 (ODCR) を作成します。Lambda はそのリザーブドキャパシティを自動的に使用します。
大規模なコンテナイメージとストレージ。 /tmp にある最大 32 GB の NVMe エフェメラルストレージとともに、最大 32 GB のコンテナイメージをサポートします。Seekable OCI (SOCI) レイジーローディングにより、イメージ全体がダウンロードされる前に関数の実行を開始できるため、実行環境の起動時間を最大 70% 短縮できます。
追加設定なしで GPU 使用状況を確認。 GPU 使用率、GPU メモリ使用率、GPU メモリ使用量、GPU 電力使用率は、Amazon CloudWatch および AWS Lambda コンソールで標準の関数メトリクスと並んで表示されます。
関数を呼び出した後、コンソールでは標準メトリクスの横に GPU 固有のメトリクスが表示されます。GPU 使用率、GPU メモリ使用率、GPU メモリ使用量、GPU 電力使用率を追跡すると、各呼び出しが実際にアクセラレータをどれだけ使用しているかを確認できます。これは自動スケーリングとコストの両方を左右するシグナルです。
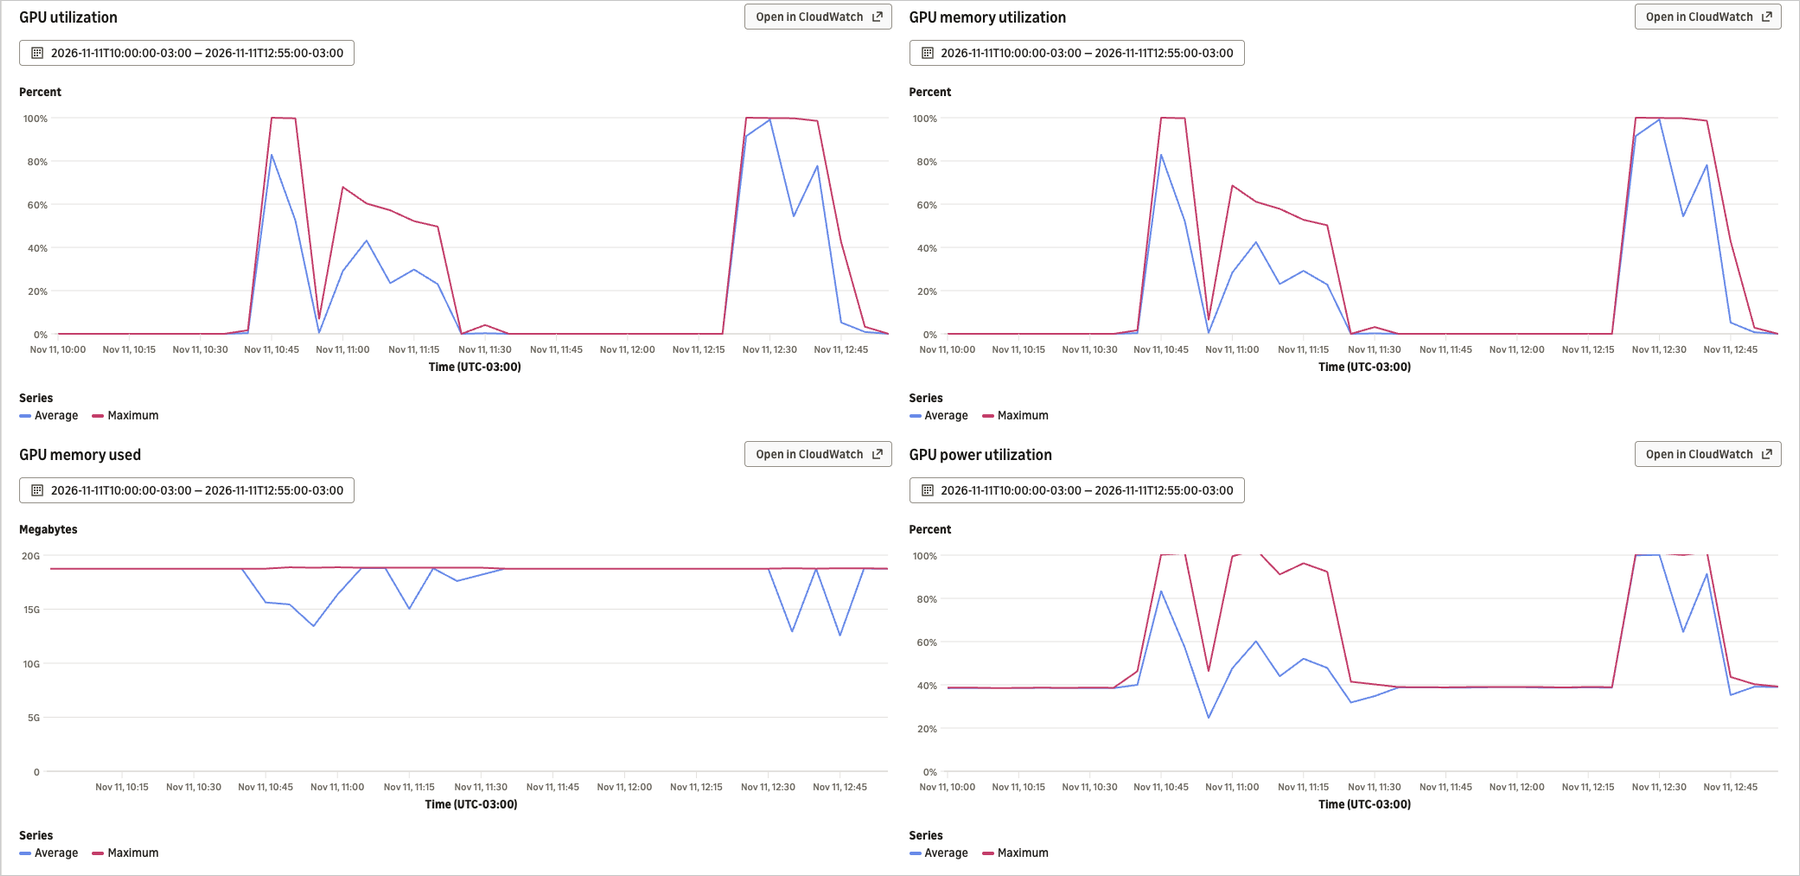
図 4: 同時負荷がかかった vLLM 関数の GPU 使用率、GPU メモリ使用率、GPU メモリ使用量、GPU 電力使用率。
料金と利用可能なリージョン
この機能は本日より一般提供されており、リリース時点では Amazon EC2 G シリーズ (G4dn、G5、G6、G6f、Gr6、Gr6f、G6e) をサポートし、今後さらに多くのインスタンスファミリーに対応予定です。基礎となる EC2 インスタンス料金 (Savings Plans および Reserved Instances の対象) に加えて、GPU インスタンスの管理費 9.75%、および標準の Lambda リクエスト料金 (百万リクエストあたり $0.20) をお支払いいただきます。料金とリージョン別の可用性については、AWS Lambda の料金をご覧ください。
AI コーディングアシスタントやエージェントを使って構築することもできます。Builder Center を参照し、Agent Toolkit for AWS でツールを接続してください。これには AWS MCP Server と厳選されたエージェントスキルがバンドルされています。
開始するには、AWS Lambda コンソールにアクセスし、GPU アクセラレーション関数のドキュメントをご覧ください。
原文はこちらです。