Amazon Web Services ブログ
臨床開発の AI 活用はどこまで進んだのか? 2026年 4つの業務で見る現在地
このブログのポイント
- 2026 年、臨床開発の 4 つの業務領域すべてで、PoC から実装に移る事例が出そろった
- 成果を分けているのは AI モデルの選択ではなく、データとコンテキストの整備、プロセスの組み替え、人が判断する線の設計
- 日本の製薬企業は、ICH M11 への対応を、AI 活用の土台づくりの起点にできる
はじめに
臨床開発は、製薬企業のバリューチェーンの中で最もコストと時間がかかる領域です。そして、2025 年から 2026 年にかけて、生成 AI と AI エージェントの活用が大きく動いた領域であると感じています。2025 年の時点では、多くの取り組みが PoC の段階や、大きな構想を掲げる段階にありました。しかし 2026 年には、多くのグローバル製薬企業が実装を進め、具体的な成果を報告するようになりました。このブログでは、臨床開発を 4 つの業務領域に分け、各領域での AI の使われ方と成果、成果を出している企業の共通点、そして日本の製薬企業への示唆について整理したいと思います。事例には、講演録画や発表資料、ブログへのリンクを付けました。個別イベントの報告ではなく、臨床開発に携わる方が自社の 2026 年の現在地を確かめるための地図として使っていただければと思います。
なぜ今、臨床開発なのか?
新しい医薬品を患者さんに届けるまでには 10〜12 年、約 26 億ドルがかかり(DiMasi ほか, 2016)、その時間とコストのおよそ 3 分の 2 を臨床開発が占めます。臨床試験の施設のおよそ半数は患者さんを 1 例も登録できず、試験の約 40% は登録目標に届きません(AWS ブログ)。試験プロトコルの 57% に 1 回以上の大幅な改訂があり、その約半数は回避可能だったという調査もあります(Getz ほか, 2016)。創薬研究側で AI による候補分子の探索が加速するなか、臨床開発がボトルネックにならないための変化が求められています。
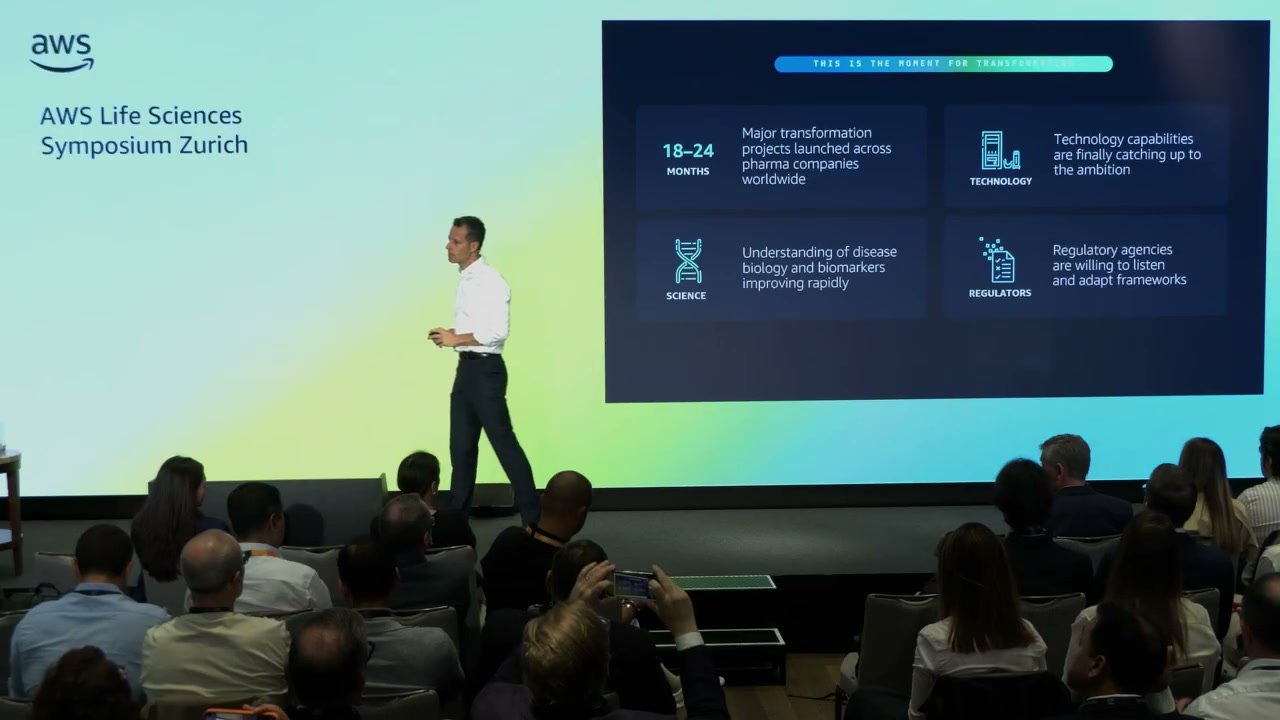
図 1:「今が変革のとき」とする 4 つの理由(出典:EMEA 基調講演)
2026 年 6 月の AWS Life Sciences Symposium EMEA の基調講演で、AWS の Boris Bogdan は「今が変革のとき」だとして 4 つの理由を挙げました。
- 変革プロジェクトの本格化。この 18〜24 か月で、経営が主導し部門をまたぐ大型の変革プロジェクトが、本番運用を前提に相次いで立ち上がっています。運用を続けるほどデータと判断の記録が蓄積されるため、先行した企業との差は後から縮まりにくい構造です。
- 技術の成熟。AI エージェントが複数のシステムをまたいで作業を進め、人の確認まで含めて業務に組み込めるようになりました。問われるのはモデルの性能ではなく、AI に渡すデータとコンテキストを用意できているかどうかに移っています。
- サイエンスの進展。バイオマーカーで対象を絞り込めるようになった一方で、適格な患者さんは少なくなり、プロトコルは複雑になります。この最適な塩梅を AI とデータ基盤で支えられるかどうかが、試験の精度と速さを左右します。
- 規制の整備。ICH E6(R3)(2025 年 1 月)、FDA のドラフトガイダンス(2025 年 1 月)、EMA のリフレクションペーパー(2024 年 9 月)、EMA と FDA の 10 の原則(2026 年 1 月)と、AI 活用の枠組みが米欧でそろい始めました。規制上の不確実性は、投資を先送りする理由になりにくくなっています。
こうした背景から、2025 年時点で、ライフサイエンス業界の生成 AI 投資の約 70% は臨床試験に向かっていました(AWS ブログ)。
4 つの業務領域と AI 活用の現在地
臨床試験は、数え切れないほどの意思決定の積み重ねです。どの施設を選ぶか、どの適格基準にするか、どのデータをどう変換するか。AI が成果を上げているのは、これらの意思決定と、その間をつなぐ文書・データ作業です。
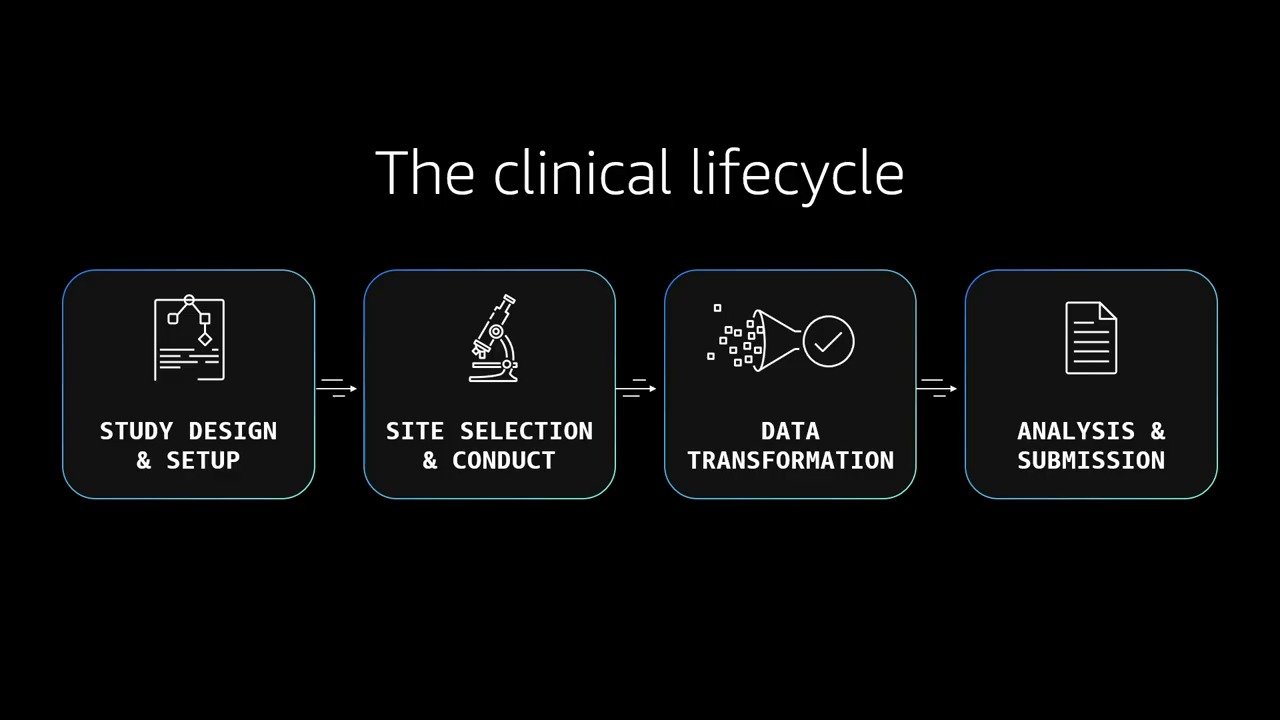
図 2:AI 活用が期待できる臨床開発ライフサイクル(出典:基調講演)
2026 年のニューヨークの基調講演で、AWS は臨床開発のライフサイクルを、試験設計・立ち上げ、施設選定・試験実施、データ変換、解析・申請の 4 つの業務領域で示しました(図 2)。本記事もこの区分に沿って見ていきます。どの領域から取り組むかは、各社の課題によって変わります。最初に全体を 1 枚の表にまとめます。
| 業務領域 | 主な課題 | AI 活用 | 事例と成果 |
|---|---|---|---|
| 試験設計・立ち上げ | 部門間で順番に引き継ぐため計画に時間がかかり、改訂も多い | 試験計画のシミュレーション、RWD によるプロトコルの事前検証 | Novartis:70 ページの計画書と 20 超の役割を、1 日のプランニングと 5 未満の役割へ(目標)/QuantHealth:600 超の試験をシミュレーションし、エンドポイント予測の精度は 90% 超/Novo Nordisk:データに含まれる患者さんと分析に使える患者さんの 10 倍の差を事前に把握 |
| 施設選定・試験実施 | 施設の約半数が 1 例も登録できない | 施設パフォーマンスの予測と、根拠付きのランキング | Merck & Co.(MSD):BCG と施設パフォーマンス予測の STRIDE を構築し、根拠付きで施設をランク付け |
| データ変換 | データが試験ごと・モダリティごとに分かれている。ADaM と TLF は手作業でプログラミングし、二重プログラミングで検証している | 取り込みから DWH 格納までを自動化する ETL エージェント、ADaM・TLF を生成するエージェントと形式検証 | Bayer:臨床バイオマーカーのデータフロー 数か月→2 週間/AbbVie:プロトコルを起点に SAP、ADaM、TLF までをエージェントで生成し、二重プログラミングを形式検証で置き換え |
| 解析・申請 | 数百ページの文書を人手で起草・整合確認する | データと過去文書を根拠にした初稿生成 | 塩野義製薬:CSR 1〜13 章の初稿を約 10 分で生成、作成時間 約 50% 削減(PoC)/Novo Nordisk:臨床文書作成時間 90% 削減 |
1. 試験設計・立ち上げ(Novartis、QuantHealth、Novo Nordisk)
試験計画は長く、部門から部門へ順番に引き継ぐ形で進められてきました。文書が部門を渡るたびに待ち時間が積み上がり、修正が入れば最初からやり直しになります。
Novartis はこの領域で最も長く取り組んできた企業の 1 つです。2025 年には、Fast-to-IND、オペレーション改善、AI 活用の 3 つの取り組みを合わせて開発期間を最大 19 か月短縮する計画と、その中核としてデジタルツインで臨床試験のワークフローを事前にシミュレーションする Intelligent Decision System を紹介しました(講演録画/発表資料)。2026 年には、この仕組みを試験計画の「コンピュテーショナル・ツイン」として形にしています。社内の試験データ、リアルワールドエビデンス、予測モデルを組み合わせて、承認、施設の立ち上げ、患者登録のタイムラインを確率的に示し、リソースを投じる前に判断を試せます。あわせて、従来は 70 ページの計画書と 20 を超える責任者の役割を必要としたプロセスを、1 日のプランニングと 5 未満の役割で回すことを目指しています(AWS ブログ)。
もう一歩先の動きとして、試験デザインそのものを大規模にシミュレーションするアプローチも出てきました。2026 年 6 月の AWS Life Sciences Symposium EMEA の基調講演では、イスラエルのスタートアップ QuantHealth が紹介されました。3 億 5,000 万人を超える患者データと独自のナレッジグラフで 600 件超の臨床試験をシミュレーションし、個々のエンドポイントを 90% 超の精度で予測しているといいます(講演録画)。「速く回す」ことよりも「正しい設計を選ぶ」ことに AI を使う流れです。
設計の前提になる RWD が本当に使えるかを、事前に確かめる動きもあります。Novo Nordisk は、RWD を手元に集めずに、データがある場所で直接問い合わせる仕組み(クエリ・イン・プレイス)に切り替えました。試験参加者 1,175 人を、個人を特定できない形で 4 種類の RWD の中から探したところ、「データに登場する患者さん」と「分析に必要な項目がそろっている患者さん」の数には 10 倍の差がありました。ある種類の RWD では、患者さんの 11% が見つかったものの、必要な項目がそろっていたのは 1% だけでした(AWS ブログ)。RWD を試験設計に使うなら、「データがある」ことと「使える」ことを分けて確かめる必要があるということです。
2. 施設選定・試験実施(Merck & Co.)
冒頭で触れた「施設の約半数が 1 例も登録できない」という問題は、試験遅延の直接の原因になっています。
Merck & Co.(日本では MSD)は BCG とともに、施設のパフォーマンスを予測する STRIDE を構築しました。過去の登録実績、立ち上げにかかった期間、登録ゼロになるリスクから施設を評価し、根拠を説明できる形でランク付けします。多様性への貢献が見込めるか、同社にとって初めての施設かといった戦略上の属性も示します(AWS ブログ)。STRIDE は、同社が数年かけて構築してきた統合的な臨床データ基盤の上で動いています。この基盤については、2025 年のシンポジウムで講演しています(臨床トラック録画/基調講演録画/発表資料)。予測モデルが使えるのは、その下に整ったデータがあるからです。
3. データ変換(Bayer、AbbVie)
臨床データは、試験ごと、システムごとに分かれて管理されがちです。2025 年の時点で、Merck & Co. は SDTM への標準化や外部データの自動取り込みを備えた臨床データ基盤を紹介していました。2026 年には Bayer が Data Science Ecosystem を紹介しました。試験ごと、モダリティごとにばらばらだったデータを、「CRO から届いたままの生データ」「チェックして整えたデータ」「すぐ分析に使えるデータ」の 3 層に分けて管理する構成です。銅・銀・金のメダルになぞらえてメダリオン構成と呼ばれ、層を上がるほどデータの品質が高まります。層から層へデータを移す取り込み、クレンジング(QC/ETL)、DWH への格納は、Claude Code をベースにした ETL エージェントで自動化しました(基調講演)。誰がどのデータを見られるかは、開発プログラムごとの役割で決めています。エージェントが領域の専門家と協働することで、臨床バイオマーカーのデータフローは数か月から 2 週間に短縮されています。マルチモーダルの Data Navigator では、臨床、薬物動態、バイオマーカー、デジタルバイオマーカー、画像のデータをまとめて分析でき、医薬品とコンパニオン診断薬の並行開発を支えています(AWS ブログ)。
変換の先にある統計プログラミングでは、AbbVie が先行しています。ADaM データセットと TLF(Tables, Listings, Figures)は申請の土台ですが、統計プログラマーが統計解析計画書(SAP)を読み解いてコードを書く逐次型の作業で、1 セクションに数週間かかります。品質確保のために、別の担当者が同じプログラムを独立に書いて結果を突き合わせる二重プログラミングも求められてきました。AbbVie はこの工程をエージェントのパイプラインで自動化し、プロトコルを起点に SAP、ADaM、TLF までをエージェントが生成します。二重プログラミングは Formal Verification(形式検証)に置き換えました。形式検証は、コードが仕様どおりに動くことを、テストではなく数学的・論理的に証明する手法です(基調講演)。
データを整える側では Bayer が、そこから解析結果を生成する側では AbbVie が先行しています。2 社の取り組みを組み合わせると、データの取り込みから申請までを自動でつなぐ「Automated Submission Backbone」の姿が見えてきます。
4. 解析・申請(塩野義製薬、Novo Nordisk)
TLF ができあがると、次は CSR をはじめとする申請文書の作成です。文書作成は、生成 AI の効果が最も見えやすい領域です。国内では塩野義製薬が先行しています。同社は治験総括報告書(CSR)と治験実施計画書の作成支援システムを Amazon Bedrock で構築し、社内とは AWS Direct Connect で接続しています。ICH E3 の章構成に沿って、CSR の 1〜13 章、約 200 ページの初稿を約 10 分で生成します。GCP 監査に対応する文書管理システムとは切り離して運用しています。ClinicalTrials.gov の試験検索や ICH ガイドラインの検索機能も、すでに本番で使われています(講演録画)。PoC では作成時間を CSR で約 50%、治験実施計画書で約 20% 削減し、このソリューションは日立製作所にライセンス提供されています(プレスリリース)。初稿が約 10 分で出ても、メディカルライターの修正を含めた全体でどれだけ効率化できるかは、各社がいま検証している論点です。
海外では、Novo Nordisk が AWS 上で Anthropic の Claude を使い、臨床文書の作成時間を 90% 削減しました(AWS)。同社は 2026 年 8 月に AWS との戦略的パートナーシップを発表し、臨床文書作成時間の短縮をすでに出ている成果の 1 つに挙げています(同社発表)。
成果を出している企業の共通点
4 つの業務領域を並べると、成果の大きさを分けているのは AI モデルの選択ではないことがわかります。共通点は 3 つあります。
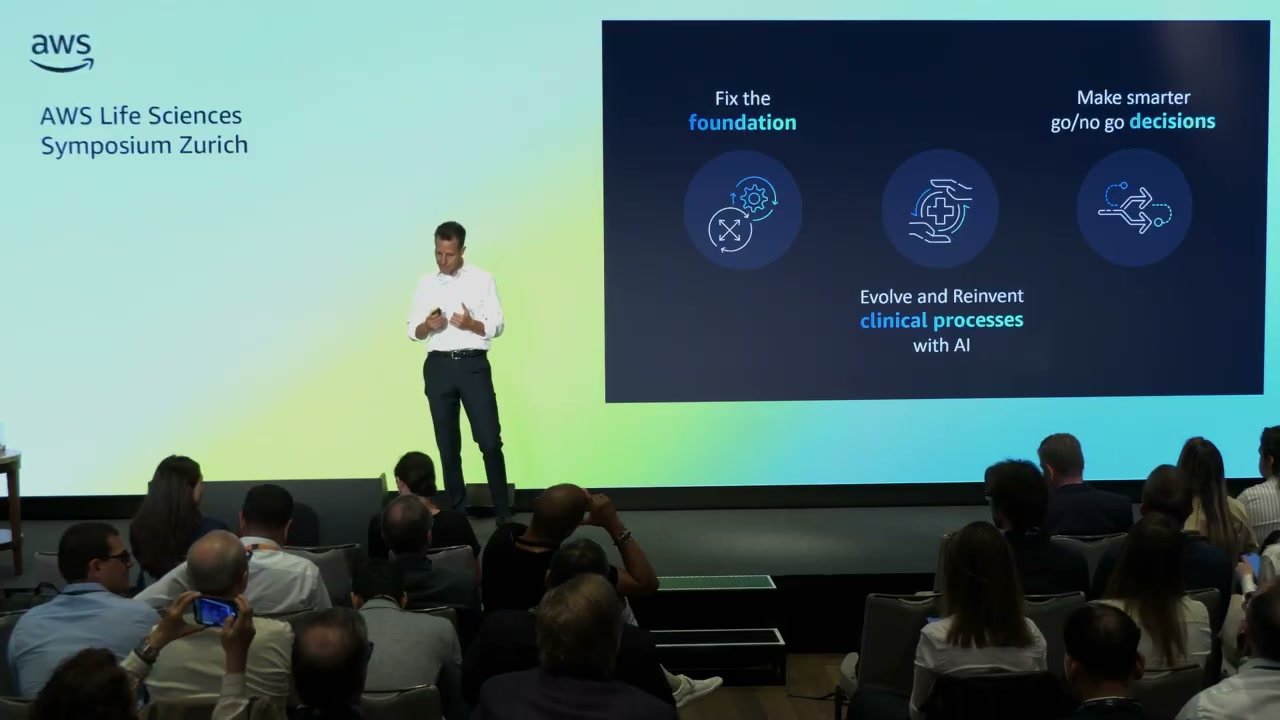
図 3:臨床開発の 3 つの重点。基盤を整える、AI で臨床プロセスを組み替える、Go/No-Go の判断を賢くする(出典:EMEA 基調講演) |
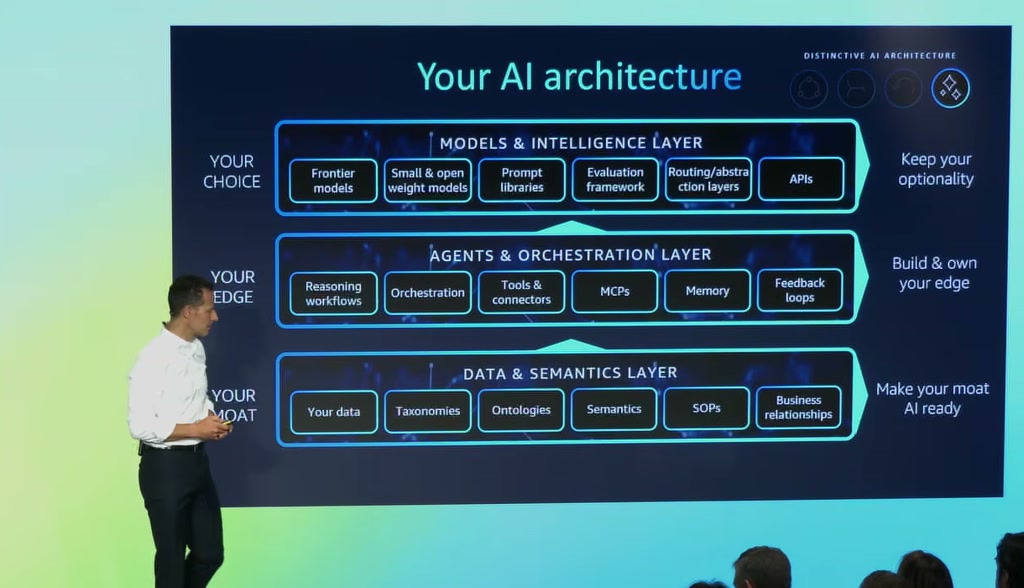
図 4:AI アーキテクチャの 3 層。最下層のデータとセマンティクスを、AI 活用における自社の参入障壁と位置づけている(出典:EMEA 基調講演) |
データとコンテキストを先に整える
Merck & Co. の STRIDE は数年がかりの臨床データ基盤の上に乗っており、Bayer はプログラム単位でデータを整理し直しています。AI エージェントが正しく動くには、社内の用語、データ同士の関係、業務上のルールを理解できるようにするセマンティックレイヤーが欠かせません。EMEA の基調講演では Roche が、AI エージェントが正確に動くためのエンタープライズのセマンティックデータレイヤーの構築を紹介しました。同じ講演では、オントロジーに基づくナレッジグラフを使うと、臨床 Q&A でのハルシネーション率が 63%(ChatGPT-4 単体)から 1.7% に下がったという研究(臨床の質問 60 問での評価)も紹介されています(Ali ほか, J Biomed Inform, 2026)。
AI を入れる前にプロセスを組み替える
人が担う前提で作られた業務プロセスに AI エージェントを足しても、エンドツーエンドではほとんど速くなりません。1 つの工程だけが劇的に速くなっても、下流が同じペースで動いていれば、患者さんに薬が届く日は変わりません。成果を出している企業は、既存の業務プロセスや役割そのものを見直しています。AbbVie は、二重プログラミングを AI に代行させるのではなく、形式検証に置き換えることで、工程そのものをなくしました。
人が判断する線を決める
Novartis では、AI の分析を受け取って判断する人の役割を 1 つに絞ろうとしています。その役割を担う人は、決められた範囲の中であれば自分の判断で意思決定し、前に進めることができます。判断にはタイムスタンプが付き、どのデータと予測をもとに何を決めたかをシステム上で後から追跡できます。記録された判断は次の試験の学習にも使われます(AWS ブログ)。Bayer では、ETL エージェントが動かすデータフローを領域の専門家が承認しています。
日本の製薬企業への示唆と始め方
日本の製薬企業には、グローバル本社との連携、日本語と英語が混在する文書、MedDRA などの国際標準と日本語の医学用語との対応といった固有の事情があります。これに加えて、治験実施計画書を電子的に構造化する ICH M11 への対応も控えています(製薬協)。プロトコルが機械で読める形になれば、本記事で見てきたエージェントのパイプラインの起点になります。M11 対応を様式の変更で終わらせず、AI 活用の土台づくりとして進められるかどうかが、次の差になると思います。そのうえで、始め方について 3 つ提案します。
- 価値の高いプロセスを 1 本に絞る。数十のユースケースを並行して走らせるより、TLF、CSR、施設選定など、グローバルで効果が確かめられ始めた業務プロセスを 1 つ選び、エンドツーエンドで組み替えるほうが、短縮の効果が目に見えます。
- M11 を起点に、データとコンテキストの整備を同時に始める。最初のユースケースは PoC で終わらせず、実装まで見据えて設計します。構造化されたプロトコルを入口に、将来の試験にも使えるデータ基盤とセマンティックレイヤーを作るきっかけにします。
- 人が判断する線を最初に決める。どこからを人が確認するかを、実際の業務データで検証しながら決めます。GxP と申請に耐えられる透明性と品質を確保するため、誰が何をもとに判断したかを後から説明できる記録の仕組みも、このとき一緒に設計しておきます。
AWS では、業務プロセスを AI エージェント前提で組み替えるワークショップ(AI-BPR)、AI 駆動開発ライフサイクル(AI-DLC)による開発の加速、生成 AI を実際に触るハンズオン、経営層との議論の場としての Executive Briefing Center をご用意しています。まず手を動かして感触を確かめたい方には、日本のヘルスケア・ライフサイエンス向けの生成 AI デモ集 HealthData x Agent があります。関心のあるテーマがあれば、AWS のアカウントチームにお声がけください。
おわりに
本記事では、臨床開発を 4 つの業務領域に分け、2026 年時点の AI 活用の現在地と、成果を出している企業の共通点を整理しました。2025 年から 2026 年にかけて、臨床開発の AI 活用は「何ができるか(What)」から「どうやって成果を出すか(How)」へと問いが変わりました。成果が出始めた今、差を生んでいるのは技術そのものよりも、データの整え方とプロセスの組み替え方です。臨床開発に携わる皆さんは、1 か月でも、1 日でも早く患者さんに薬を届けるという使命を背負って、日々の試験に向き合っています。私たちはその取り組みを、テクノロジーの面から少しでも後押しできればと考えています。日本の臨床開発の現場の皆さんと、その 1 か月、1 日をどう生み出すかを一緒に考えていければ幸いです。

ヘルスケア・ライフサイエンス事業開発部のシニア事業開発マネージャーで、製薬業界で 20 年以上の経験を持ち、特にメディカルアフェアーズ、コマーシャルと製薬デジタル戦略(DTx 含む)を得意としています。慶應義塾大学で医療政策・管理学の博士号を取得し、ポスドク研究員として医療データ分析とアウトカムリサーチに従事しました。趣味はドライブと BBQ です。
関連リンク
ブログ
- Highlights from Clinical Trials at the 2026 AWS Life Sciences Symposium(英語)
- Executive Insights from the 2026 AWS Life Sciences Symposium(英語)
- 第 1 回 AWS ライフサイエンス・シンポジウム欧州:エグゼクティブ・インサイト
- 臨床開発セッションのハイライト – 第 7 回 AWS ライフサイエンス シンポジウム(2025 年)
講演録画
- 2026 AWS Life Sciences Symposium 基調講演(ニューヨーク)/EMEA 基調講演(チューリッヒ)/2025 年 基調講演
- 2025 年 臨床トラック:Novartis/Merck & Co.(基調講演)
- 塩野義製薬:AWS Summit Japan 2025 講演
発表資料(2025 年 臨床トラック)
関連する AWS サービス
- 本文で紹介したサービス:Amazon Bedrock/AWS Direct Connect
- 支援・規制対応:GxP コンプライアンス/AWS のライフサイエンス向けソリューション/HealthData x Agent