Amazon Web Services 한국 블로그
AWSLambda Managed Instances, 이벤트 함수를 위한 GPU 인스턴스 지원
AWS Lambda Managed Instances(LMI)에서 실행되는 이벤트 함수를 위한 EC2 G 시리즈 GPU 인스턴스에 GPU 지원이 제공됩니다. 이제 GPU 인스턴스에서 기계 학습 추론, 미디어 처리, 렌더링, 과학 컴퓨팅을 비롯한 GPU 가속 워크로드를 서버리스 방식으로 간단하게 실행할 수 있습니다. GPU 가속 함수는 컨테이너(오픈 컨테이너 이니셔티브, OCI) 이미지로 배포됩니다. OCI 이미지를 빌드하고 함수가 해당 이미지를 지정하면 Lambda가 프로비저닝, 규모 조정, 이벤트 통합을 처리합니다. GPU 드라이버, CUDA 버전, AMI를 조정할 필요가 없으며, 클러스터 또는 디바이스 플러그인을 운영할 필요도 없습니다. GPU 가속 함수는 서버를 관리하지 않고도 이미 Amazon EC2 요금 및 특수 컴퓨팅을 제공하는 동일한 Lambda Managed Instances 기반에서 실행됩니다.
고객에게 이 기능이 필요한 이유
고객은 서버리스 방식으로 단순하게 GPU 워크로드를 실행하기를 원합니다. 자체 관리형 GPU 인프라를 기반으로 구축하면 인스턴스 선택, GPU 드라이버 및 CUDA 라이브러리 설치와 조정, 용량 계획, 확장 로직 작성, GPU 단계를 애플리케이션의 나머지 부분에 연결하는 이벤트 통합을 직접 구축할 수 있습니다. 이러한 작업을 보이지 않게 처리하는 서버리스 GPU 서비스는 AWS 환경 외부에 위치하며, 네이티브 이벤트 소스, ID, 네트워킹 기능을 제공하지 않는 경우가 많습니다.
두 번째 문제는 비용입니다. GPU는 비용이 많이 들고 단일 워크로드로는 GPU를 제대로 활용하는 경우가 거의 없기 때문에 일반적으로 사용률이 낮습니다. 작은 추론 작업으로도 프로비저닝된 GPU의 대부분이 유휴 상태가 될 수 있지만 전체 비용을 지불해야 합니다.
이 기능은 두 가지 문제점을 모두 해결합니다. 함수를 가져오기만 하면 Lambda는 다른 Lambda 이벤트 함수와 동일한 AWS 이벤트에 의해 트리거되어 몇 분 만에 GPU에서 이 함수를 실행하며, 동일한 방식으로 청구되고 보호됩니다. 또한 함수를 인스턴스에 통합하고 동시 요청 전반에 걸쳐 GPU를 지속적으로 가동함으로써 비용을 지불하는 모든 GPU의 활용도를 극대화합니다.
구축할 수 있는 작업
Lambda Managed Instances에서 GPU 가속 컴퓨팅을 사용하여 AI/ML 추론 및 비 ML 워크로드를 모두 실행할 수 있습니다. 이 기능은 학습보다는 추론에 최적화되어 있으며, Amazon Bedrock과 같은 서비스에서 이미 사용 가능한 대규모 파운데이션 모델보다는 사용자 지정 모델에 최적화되어 있습니다. 일반적인 워크로드에는 다음이 포함됩니다.
- 사용자 지정 모델 추론: 의사 결정 모델(예: Stands Decider), 컴퓨터 비전, 음성-텍스트 및 텍스트-음성 변환, 권장 사항, 문서 분석, 애플리케이션의 일부로 배포되는 중소 규모 언어 모델.
- 에이전트 및 이벤트 기반 AI: 나머지 Lambda 프로그래밍 모델과 함께 구성된 AWS 이벤트에 의해 직접 트리거되는 사용자 지정 추론.
- 미디어 처리 및 트랜스코딩: 업로드 시 트리거되는 비디오 및 이미지 파이프라인.
- 3D 렌더링 및 생성형 미디어: 프레임 및 자산 렌더링, 확산, 텍스트-비디오 생성.
- 과학 컴퓨팅 및 금융 모델링: 시뮬레이션, 행렬 연산, 위험 분석.
Lambda 프로그래밍 모델의 일부
GPU 가속 함수는 대규모 애플리케이션의 한 단계이며 나머지 Lambda와 함께 구성됩니다. Lambda의 지속형 함수는 체크포인팅 및 자동 복구를 통해 GPU 단계에서 다단계의 장기 실행 워크플로를 오케스트레이션합니다. Lambda MicroVMs는 신뢰할 수 없거나 모델이 생성한 코드를 격리된 상태 저장 샌드박스에서 실행합니다. 에이전틱 워크로드에서 MicroVM은 CPU에서 도구 사용 로직을 실행한 후 추론을 위해 Lambda Managed Instances에서 실행되는 GPU 가속 함수를 호출합니다.
또한 GPU 가속 함수는 Lambda Managed Instances에서 비동기 및 이벤트 소스 매핑 호출의 경우 최대 90분까지 확장된 함수 제한 시간을 지원하므로 아키텍처를 다시 설계하지 않고도 일괄 처리 및 기타 장기 실행 GPU 작업(예: 미디어 트랜스코딩 또는 다단계 추론)을 실행할 수 있습니다. GPU 가속 함수는 최대 32GB(파일당 10GB)의 컨테이너 이미지, 최대 32GB의 임시 스토리지, 2,048~32,768MB의 메모리, 3~48GB의 액셀러레이터 메모리, 실행 환경당 최대 48개의 동시 요청, 용량 제공업체당 최대 15,000개의 vCPU를 지원합니다.
직접 사용해 보기
실제로 어떻게 동작하는지 보여드리기 위해 Hugging Face의 오픈 소스 대규모 언어 모델(LLM)을 Lambda 함수로 배포하고 프롬프트를 보냈습니다. 추론 코드를 작성할 필요 없이 Lambda의 vLLM 기본 이미지를 사용하여 MODEL_ID 환경 변수에 Hugging Face 모델 ID를 설정하기만 하면 됩니다. 요약, 분류, 추출과 같은 애플리케이션 내 작업에 적합한 소규모 명령 튜닝 모델인 Qwen/Qwen2.5-1.5B-Instruct를 사용했습니다. 흐름은 용량 제공업체 생성, 컨테이너 이미지 구축 및 푸시, 해당 이미지에서 함수 생성, 게시 및 호출의 4단계로 구성됩니다. 새 계정은 할당량이 0으로 시작될 수 있으므로 시작하기 전에 G 시리즈 인스턴스 할당량(온디맨드 G 및 VT 인스턴스 실행 중으로 표시됨)을 늘려 달라고 요청하세요. 자세한 내용은 온디맨드 인스턴스 할당량을 참조하세요.
먼저 용량 제공업체를 생성하여 Lambda가 사용할 수 있는 GPU 인스턴스 유형을 지정하고 자동으로 확장하도록 설정했습니다. 여러 인스턴스 유형을 지정하면 Lambda가 사용 가능한 가장 비용 효율적인 유형을 선택하고 용량이 부족한 경우 다른 세대의 인스턴스로 대체할 수 있습니다.
{
    "CapacityProviderName": "lmi-gpu-cp",
    "VpcConfig": {
        "SubnetIds": ["subnet-aaaa", "subnet-bbbb", "subnet-cccc"],
        "SecurityGroupIds": ["sg-aaaa"]
    },
    "PermissionsConfig": {
        "CapacityProviderOperatorRoleArn": "arn:aws:iam::111122223333:role/lmi-operator-role"
    },
    "InstanceRequirements": {
        "AllowedInstanceTypes": [
            "g5.2xlarge", "g6.2xlarge", "g6e.2xlarge"
        ]
    },
    "CapacityProviderScalingConfig": {
        "ScalingMode": "Auto",
        "MaxVCpuCount": 96
    }
}
aws --region us-east-2 \
  lambda create-capacity-provider \
  --cli-input-json file://cli-skeletons/create-capacity-provider_gpu.json
Lambda 콘솔에는 새 용량 제공업체인 lmi-gpu-cp가 활성 상태로 표시됩니다. 서브넷 및 보안 그룹이 포함된 VPC 구성을 기록해 둡니다.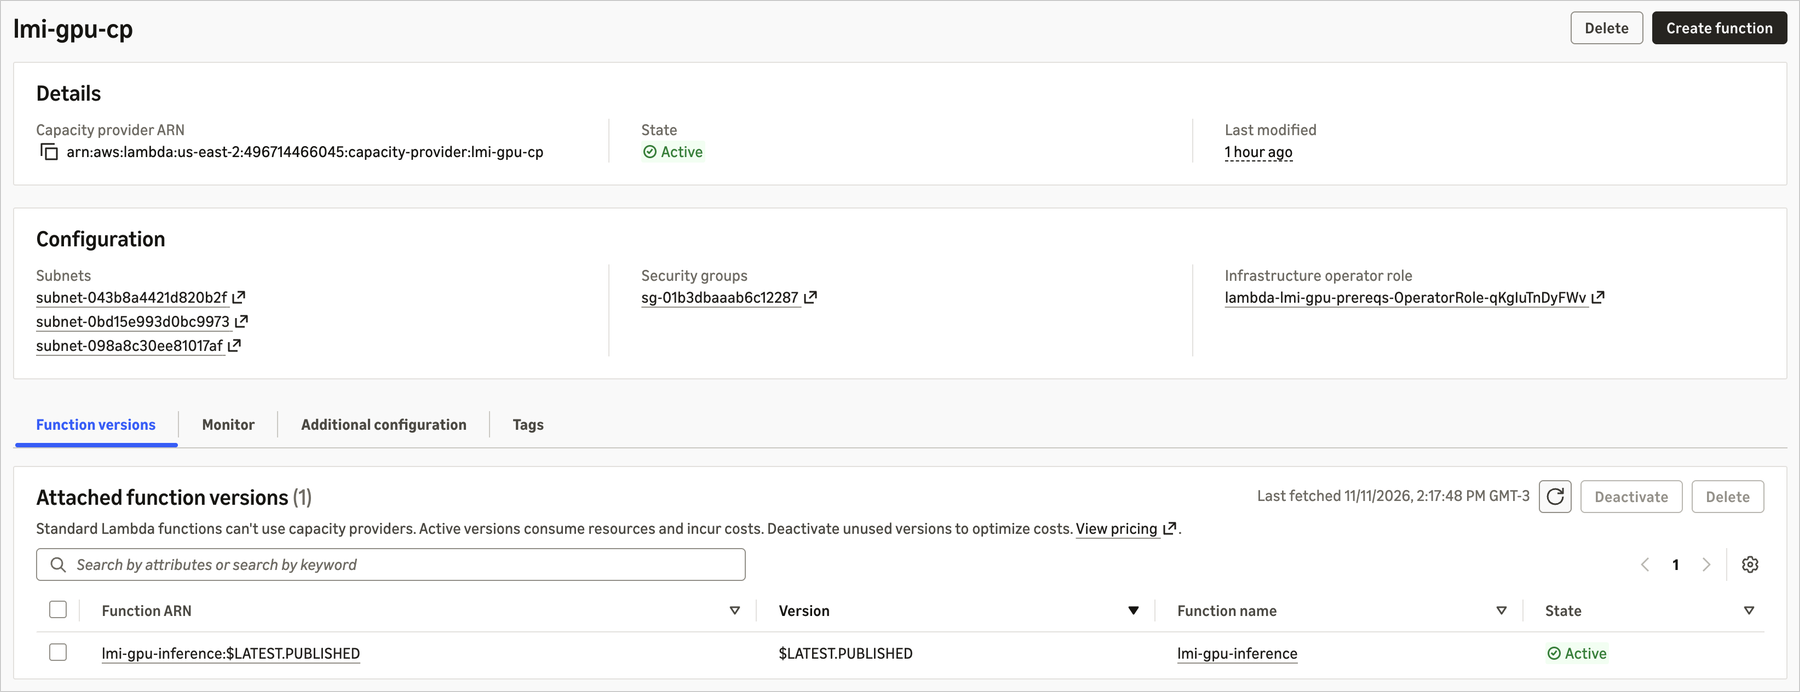
그림 1: VPC 구성이 설정되어 있고 활성 상태인 용량 제공업체.
다음으로 컨테이너 이미지를 구축했습니다. Lambda는 동시 호출을 지원하는 런타임 인터페이스 클라이언트와 함께 vLLM 추론 서버, PyTorch, 트랜스포머 및 CUDA 도구 키트를 포함하는 큐레이션된 vLLM 기본 이미지를 제공합니다. 이미지가 모델을 제공하므로 핸들러나 추론 서버 코드를 작성하지 않아도 됩니다. 전체 Dockerfile은 한 줄로 이루어져 있습니다.
FROM public.ecr.aws/lambda/deep-learning-containers/vllm:cuda-v1
이미지를 Amazon ECR로 푸시한 후 함수를 생성했습니다. MODEL_ID 환경 변수를 사용하여 모델을 선택했는데, 이를 통해 Hugging Face 또는 ModelScope 리포지토리, Amazon S3 위치, 로컬 경로를 지정할 수 있습니다. Lambda는 모델을 다운로드하고, GPU 메모리를 관리하며, 요청을 처리합니다. Qwen2.5-1.5B-Instruct는 퍼블릭 모델이기 때문에 Hugging Face 토큰이 필요하지 않았습니다. 프라이빗 모델이나 게이티드 모델의 경우 또는 다운로드 속도 제한을 높이려면 HF_TOKEN을 설정할 수도 있습니다.
GPU 가속 함수는 AcceleratorConfig를 사용하여 액셀러레이터 메모리를 요청합니다. AcceleratorMemorySize는 함수에 필요한 최소 GPU 메모리 용량이며, Lambda는 이를 충족하는 사용 가능한 가장 작은 GPU에 실행 환경을 배치하므로 사용자가 요청한 용량보다 실제로 할당받는 GPU의 메모리 용량이 클 수 있습니다. PerExecutionEnvironmentMaxConcurrency를 기본값인 4로 설정했습니다. vLLM 서버는 GPU에서 동시 요청을 일괄 처리하므로 간접 호출 간에 모델의 복사본 하나를 공유하게 되고 GPU는 계속 활발하게 작동합니다. 또한 ExecutionEnvironmentMemoryGiBPerVCpu를 4로 설정했는데, 이를 통해 함수에 필요한 16,384MB의 메모리와 4개의 vCPU를 확보하면서 Lambda의 관리 구성 요소를 위한 2xlarge 인스턴스의 용량은 그대로 유지할 수 있습니다.
{
    "FunctionName": "lmi-gpu-inference",
    "PackageType": "Image",
    "Code": { "ImageUri": "111122223333.dkr.ecr.us-east-2.amazonaws.com/lmi-gpu-inference:latest" },
    "Role": "arn:aws:iam::111122223333:role/lmi-gpu-inference-execution-role",
    "Timeout": 900,
    "MemorySize": 16384,
    "EphemeralStorage": { "Size": 32768 },
    "Environment": { "Variables": { "MODEL_ID": "Qwen/Qwen2.5-1.5B-Instruct" } },
    "CapacityProviderConfig": {
        "LambdaManagedInstancesCapacityProviderConfig": {
            "CapacityProviderArn": "arn:aws:lambda:us-east-2:111122223333:capacity-provider:lmi-gpu-cp",
            "ExecutionEnvironmentMemoryGiBPerVCpu": 4,
            "PerExecutionEnvironmentMaxConcurrency": 4
        }
    },
    "AcceleratorConfig": { "AcceleratorMemorySize": 16 }
}
aws --region us-east-2 \
  lambda create-function \
  --cli-input-json file://cli-skeletons/create-gpu-llm-function.json
함수 개요에서는 이 함수가 GPU 가속 함수인 이유를 보여줍니다. 바로 GPU 인스턴스를 제공하는 연결된 용량 제공업체와 Amazon ECR에서 배포한 vLLM 컨테이너 이미지가 이미 사용 중인 동일한 함수 모델에 모두 연결되어 있기 때문입니다.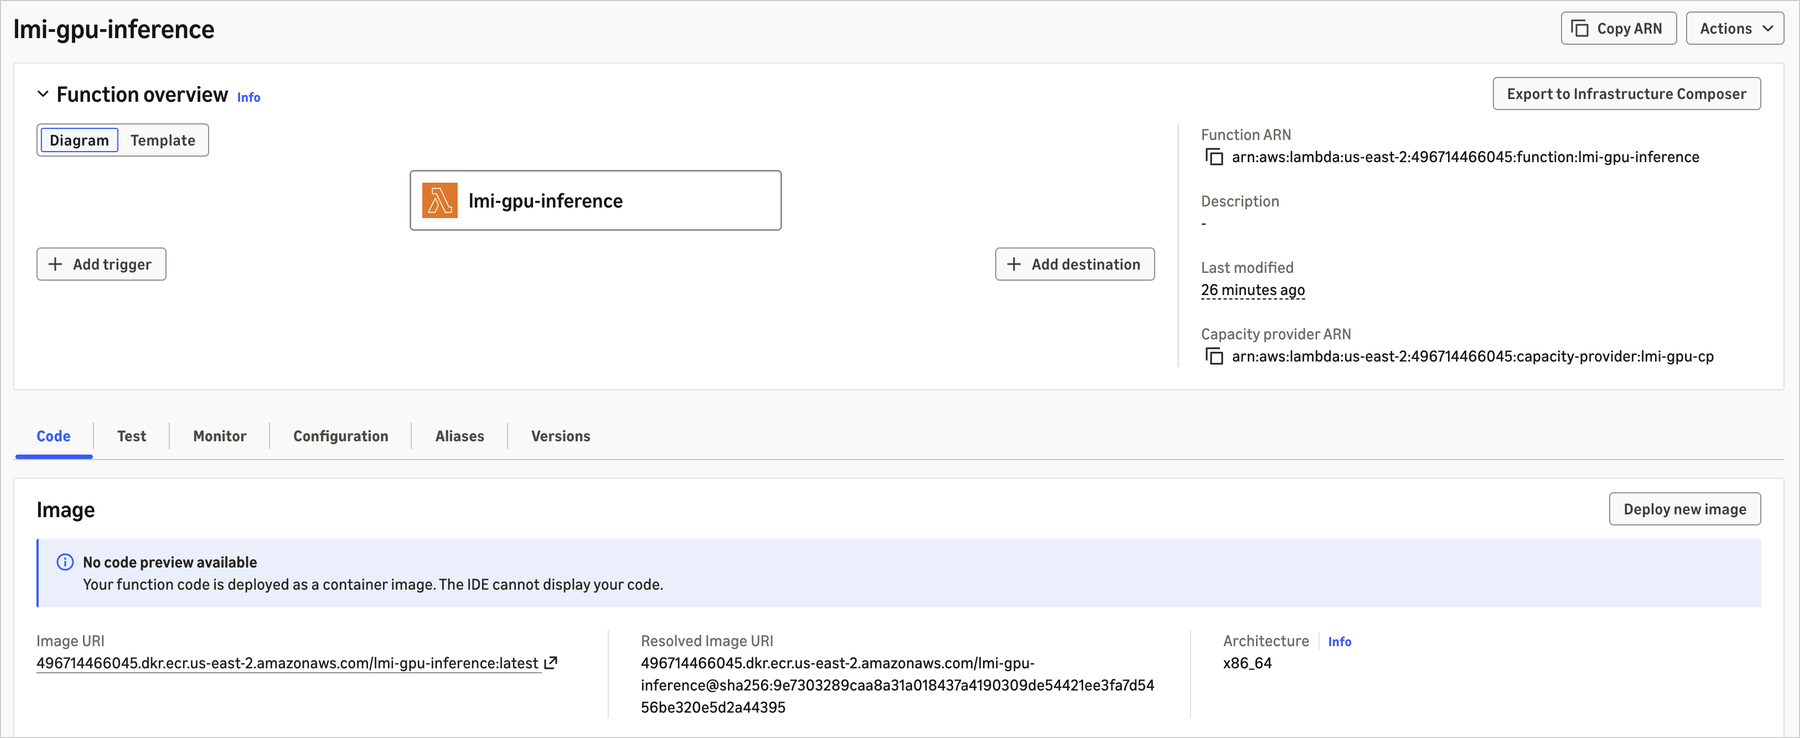
그림 2: 연결된 용량 제공업체와 Amazon ECR에서 배포한 vLLM 컨테이너 이미지를 보여주는 lmi-gpu-inference 함수 개요.
Lambda Managed Instances의 함수는 게시된 버전에서 실행되므로 버전을 하나 게시했습니다. 게시하면 실행 환경이 프로비저닝되며, 각 환경은 버전이 활성화되기 전에 모델 가중치를 다운로드하고 엔진 워밍업을 수행합니다. 콜드 스타트는 게시 단계에서 발생하므로 첫 번째 호출자는 이를 기다리지 않습니다.
aws --region us-east-2 \
  lambda publish-version \
  --function-name lmi-gpu-inference \
  --publish-to LATEST_PUBLISHED
그런 다음 모델에 프롬프트를 보냈습니다. 페이로드는 표준 OpenAI 요청 본문 형식입니다. messages 배열은 채팅 완성으로 라우팅되고 prompt 필드는 텍스트 완성으로 라우팅됩니다.
aws --region us-east-2 \
  lambda invoke \
  --function-name 'lmi-gpu-inference:$LATEST.PUBLISHED' \
  --cli-binary-format raw-in-base64-out \
  --payload '{"messages": [{"role": "user", "content": "Explain serverless GPU inference in one sentence."}], "max_tokens": 128}' \
  /dev/stdout
모델은 Lambda 실행 환경 내부의 GPU에서 응답하며 응답은 표준 OpenAI 완성 객체이므로 모든 OpenAI 호환 클라이언트가 이를 사용할 수 있습니다.
{
  "model": "Qwen/Qwen2.5-1.5B-Instruct",
  "choices": [
    {
      "message": {
        "role": "assistant",
        "content": "Serverless GPU inference is a cloud-based service that allows for efficient execution of machine learning models on NVIDIA GPUs without the need for infrastructure management or maintenance."
      },
      "finish_reason": "stop"
    }
  ],
  "usage": { "prompt_tokens": 39, "completion_tokens": 31, "total_tokens": 70 }
}
GPU 메모리에 있는 모델의 복사본 하나를 공유하는 하나의 실행 환경에서 4개의 동시 호출이 단일 호출과 거의 같은 시간에 완료되었습니다. Hugging Face 모델 ID에서 실시간 OpenAI 호환 라이브 GPU 엔드포인트에 이르기까지 약 10분이 걸렸으며, Lambda가 용량을 프로비저닝하고 모델 워밍업을 수행하는 동안 대부분의 작업이 자동으로 진행되었습니다.
이는 추론 서버 코드도, GPU 드라이버도, 관리할 클러스터도 없는 제대로 작동하는 LLM 엔드포인트입니다. 다른 모델을 사용해 보기 위해 MODEL_ID를 업데이트하고 이미지 재구축 없이 새 버전을 게시합니다. 각 버전은 변경 불가능한 스냅샷이므로 서로 다른 모델을 별도의 버전으로 나란히 실행할 수 있습니다. 또한 이는 Lambda 이벤트 함수이기도 하므로 Amazon SQS 대기열에서 트리거하여 문서를 일괄적으로 처리하거나, Amazon API Gateway를 앞에 배치하거나, Lambda 지속형 함수 워크플로 내에서 추론 단계로 호출할 수 있습니다.
프로덕션의 경우 모델 가중치를 동일한 리전의 S3 버킷에 복사하고, MODEL_ID를 해당 버킷으로 지정하고, VLLM_LOAD_FORMAT=runai_streamer를 설정하여 가중치가 메모리로 바로 스트리밍되도록 합니다. 그러면 시작 속도가 빨라지고 Hugging Face Hub에 대한 의존성도 사라집니다. 자세한 지침은 추론 워크로드 실행 모범 사례를 참조하세요. LLM 추론 외에도 사용자 지정 ML 추론, 미디어 처리 및 기타 GPU 워크로드를 실행할 수 있습니다. 모범 사례는 Lambda 설명서를 참조하세요.
구성 탭에는 GPU 가속 함수에 필요한 설정(16,384MB의 메모리, 15분의 제한 시간, 다운로드한 가중치에 대한 32GB의 임시 스토리지) 및 함수 수준 용량 제공업체 설정(환경별 동시성 4, 메모리-vCPU 비율 4:1, 액셀러레이터 메모리 16GB)이 표시됩니다.
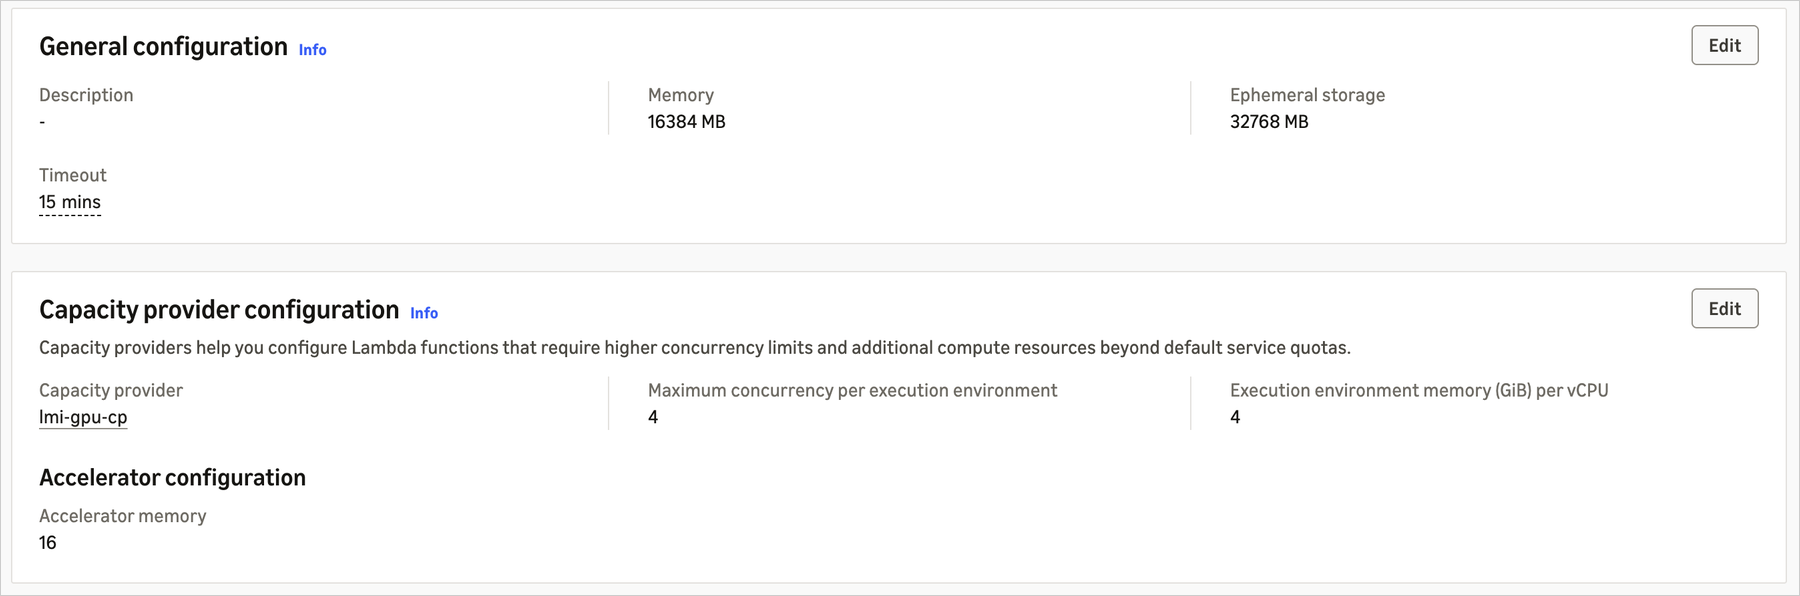
그림 3: 메모리, 시간 제한, 32GB의 임시 스토리지를 포함한 함수 구성 및 함수 수준 용량 제공업체 설정(환경별 동시성, 메모리-vCPU 비율, 액셀러레이터 메모리).
테스트가 완료되면 함수를 삭제한 후 용량 제공업체를 삭제합니다. 그러면 Lambda에서 GPU 인스턴스를 중지하므로 해당 인스턴스에 대한 요금이 부과되지 않습니다.
작동 방식
아래 기능은 기본적으로 제공되는 기능이며, 각 기능을 통해 사용자가 직접 처리해야 하는 GPU 작업을 대신 수행할 수 있습니다.
GPU 소프트웨어 설정 건너뛰기. 큐레이션된 기본 이미지는 프레임워크 및 도구가 구성되어 제공되므로 사용자가 직접 설치하거나 조정하지 않아도 됩니다. 여기에는 base:cuda(CUDA toolkit and runtime), cupy:cuda(CuPy, NumPy, SciPy, Pandas, Numba), pytorch:cuda(PyTorch, torchvision, torchaudio, transformers, FFmpeg) 및 제공 이미지 vllm:cuda, sglang:cuda가 포함됩니다. 직접 사용하거나, 확장하거나, 완전히 사용자 지정 이미지를 가져올 수 있습니다.
운영할 GPU 인프라가 없음. Lambda는 드라이버 호환성, 프로비저닝, 라우팅, 로드 밸런싱을 처리하므로 GPU 플릿을 실행할 필요 없이 함수를 배포하기만 하면 됩니다. 다른 Lambda 이벤트 함수와 동일한 콘솔, CLI, AWS CloudFormation, AWS CDK, AWS SAM 및 Terraform 워크플로를 사용하여 배포할 수 있습니다.
다른 AWS 이벤트에서 GPU 작업 트리거. Amazon S3, Amazon SQS, Amazon API Gateway, Amazon EventBridge를 포함하여 이벤트 함수를 트리거하는 동일한 200개 이상의 이벤트 소스가 동일한 규모 조정, 오류 처리, 재시도로 GPU 가속 함수를 직접 트리거합니다. 사용자 지정 통합 코드가 없습니다.
각 GPU에서 동시 요청 처리. 각 실행 환경은 동일한 GPU에서 여러 개의 동시 호출을 처리할 수 있으며, 이는 환경별 동시성 설정으로 제어할 수 있습니다. 이 설정을 높이면 각 GPU 인스턴스에 더 많은 요청을 할당하여 사용률을 높일 수 있으므로 이미 지불한 용량 내에서 더 많은 처리량을 확보할 수 있습니다.
다양한 인스턴스 유형. 여러 인스턴스 유형 또는 세대를 지정하면 Lambda가 사용 가능한 가장 비용 효율적인 옵션을 선택하고 목록 전반에 걸쳐 대체함으로써 용량 부족 오류를 줄입니다.
용량 옵션. GPU 인스턴스는 Amazon EC2 온디맨드 인스턴스로 실행되며, 기존의 절감형 플랜과 예약 인스턴스가 적용됩니다. GPU 가용성을 예측하기 위해 용량 제공업체 구성과 일치하는 EC2 온디맨드 용량 예약(ODCR) 을 생성하면 Lambda가 예약 용량을 자동으로 사용합니다.
대규모 컨테이너 이미지 및 스토리지. 최대 32GB의 컨테이너 이미지와 /tmp의 최대 32GB NVMe 임시 스토리지가 지원됩니다. Seekable OCI(SOCI) 지연 로딩을 통해 전체 이미지가 다운로드되기 전에 함수 실행을 시작할 수 있으므로 실행 환경 시작 시간이 최대 70% 단축됩니다.
추가 설정 없이 GPU 사용량 확인. GPU 사용률, GPU 메모리 사용률, 사용된 GPU 메모리, GPU 전력 사용률이 Amazon CloudWatch 및 AWS Lambda 콘솔의 표준 함수 지표와 함께 표시됩니다.
함수를 호출한 후 콘솔은 표준 지표 옆에 GPU 관련 지표를 표시합니다. GPU 사용률, GPU 메모리 사용률, 사용된 GPU 메모리, GPU 전력 사용률을 추적하여 각 호출에서 실제로 사용하는 액셀러레이터의 양을 확인할 수 있습니다. 이는 자동 크기 조정과 비용 모두를 결정짓는 지표입니다.
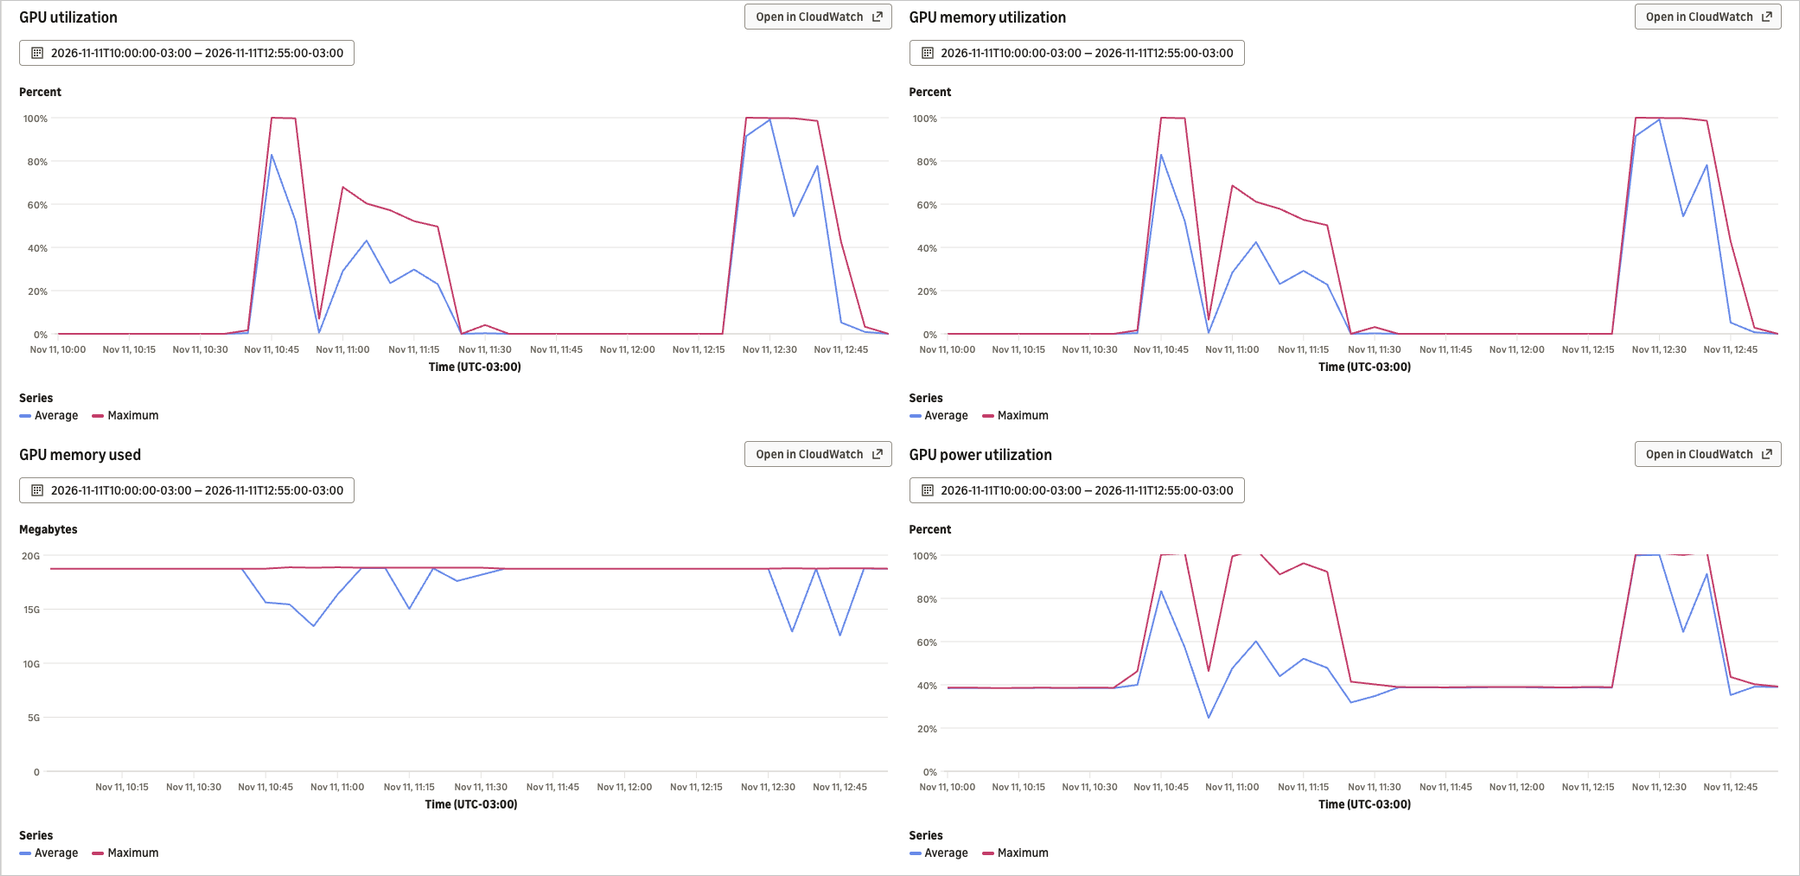
그림 4: 동시 부하가 걸린 vLLM 함수의 GPU 사용률, GPU 메모리 사용률, 사용된 GPU 메모리, GPU 전력 사용률.
요금 및 가용성
이 기능은 현재 일반 공급으로 제공되며, 출시 시점에는 Amazon EC2 G 시리즈(G4dn, G5, G6, G6f, Gr6, Gr6f, G6e)를 지원합니다. 향후 더 많은 인스턴스 패밀리가 추가될 예정입니다. 기본 EC2 인스턴스 요금(절감형 플랜 및 예약 인스턴스에 해당)에 GPU 인스턴스에 대한 9.75%의 관리 요금, 요청 1백만 건당 0.20 USD의 표준 Lambda 요청 요금이 추가됩니다. 요금 및 리전별 가용성은 AWS Lambda 요금을 참조하세요.
AI 코딩 어시스턴트 및 에이전트와 함께 구축할 수도 있습니다. 빌더 센터를 살펴보고 AWS MCP Server와 큐레이션된 에이전트 스킬을 번들로 제공하는 AWS용 에이전트 툴킷에 도구를 연결하세요.
시작하려면 AWS Lambda 콘솔로 이동하여 GPU 가속 함수 설명서를 참조하세요.