O blog da AWS
Faça o deploy do seu primeiro System One Model na AWS com Laya
Por Guilherme Ricci, Arquiteto de Soluções Sênior para startups na Amazon Web Services.
Boa parte das aplicações com que trabalho usa um LLM para tarefas que, no fim, são apenas uma classificação: decidir o roteamento de uma solicitação, identificar a categoria de um evento ou sinalizar se uma condição está presente. Pagar o custo e a latência de gerar texto para depois interpretá-lo sempre me pareceu desproporcional ao resultado, e foi isso que me levou a testar um System One Model como o Laya. Neste guia, eu mostro o que muda nessa abordagem e como colocá-la em execução na sua própria conta AWS.
Large Language Models (LLMs) passaram a ser utilizados em aplicações que precisam trabalhar com informações não estruturadas. Geração de conteúdo, sumarização, extração de informações e interfaces conversacionais normalmente são atendidas por modelos capazes de produzir uma sequência aberta de tokens. Entretanto, nem todo workload exige que uma resposta seja gerada: em muitos casos, o texto produzido pelo modelo existe apenas para ser interpretado pela aplicação logo em seguida.
Em diversas aplicações, o conjunto de respostas possíveis já é conhecido. Pode ser necessário determinar para qual processo uma solicitação deve ser encaminhada, qual categoria melhor representa um evento ou se determinada condição está presente. Nesses cenários, a aplicação espera uma decisão estruturada, e não uma resposta aberta, e toda a etapa de gerar, validar e interpretar um texto passa a ser um custo sem valor para o resultado final.
Em 15 de setembro de 2026, a TypeSafe apresentou o Jev como seu primeiro System One Model, termo que descreve uma classe de modelos que recebe um estado não estruturado e produz decisões tipadas e probabilísticas, prontas para consumo por software. O Laya é uma implementação open source desse padrão, disponibilizada sob licença Apache 2.0, e permite explorar esse tipo de workload em uma infraestrutura controlada pela própria aplicação, sem depender de uma API externa.
Este guia foca no Laya: o que ele é, o que muda ao executá-lo em comparação a um LLM generativo e o que você precisa para colocá-lo em execução na sua própria conta AWS. O Laya é distribuído como um container com os pesos do modelo embutidos, então você pode executá-lo em qualquer lugar capaz de rodar esse container, como o Amazon Elastic Compute Cloud (Amazon EC2), o Amazon Elastic Kubernetes Service (Amazon EKS), o Amazon Elastic Container Service (Amazon ECS) ou o Amazon SageMaker AI. Neste guia, a escolha é o Amazon ECS com Managed Instances, pela simplicidade de operar a capacidade com GPU e por o ambiente ser privado por padrão, com rede isolada e sem portas de entrada, como se espera de uma prova de conceito. As peças específicas do Laya são as mesmas em qualquer uma dessas opções.
Para tornar visível a diferença entre as abordagens, você adiciona um playground ao ambiente, com duas páginas: na primeira, você observa respostas, latência e uso de tokens do Laya; na segunda, você envia a mesma tarefa ao Laya e, apenas como ponto de comparação, a um modelo generativo no Amazon Bedrock. O Laya não faz parte do Amazon Bedrock nem depende dele.
Todo o código utilizado está disponível no repositório sample-laya-system-one-ecs-gpu. Este guia explica os conceitos e o que é específico do Laya, com referência aos arquivos do repositório para a infraestrutura. Você cria o ambiente com um único comando, ./scripts/deploy.sh, e os demais scripts e instruções estão no README.md do repositório, escrito em inglês.
O que é um System One Model?
Em uma aplicação baseada em um LLM generativo, você envia contexto e instruções ao modelo e ele produz uma resposta textual. Mesmo quando apenas uma classificação é necessária, o fluxo costuma incluir a geração de um texto, a validação do formato e a interpretação da resposta, com tratamento para os casos em que o modelo responde algo fora do esperado. Cada uma dessas etapas adiciona latência, custo e código que existem apenas para transformar texto de volta em uma decisão.
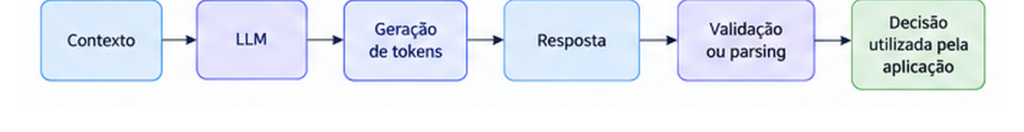
Figura 1: Fluxo típico com um LLM generativo
Com um System One Model, você usa outro contrato de inferência. A aplicação fornece o estado a ser avaliado e as decisões possíveis, e o modelo avalia essas alternativas diretamente, em vez de produzir uma resposta aberta em linguagem natural. O resultado já chega no formato que a aplicação precisa: a alternativa escolhida, a probabilidade de cada opção e uma medida de confiança. Nesse ponto, um System One Model pode parecer apenas mais um classificador do aprendizado de máquina clássico, mas há uma diferença importante: como ele opera a partir das alternativas descritas na própria requisição, generaliza para novos espaços de decisão em regime zero-shot ou com pouca calibração, sem exigir um modelo treinado especificamente para cada tarefa.
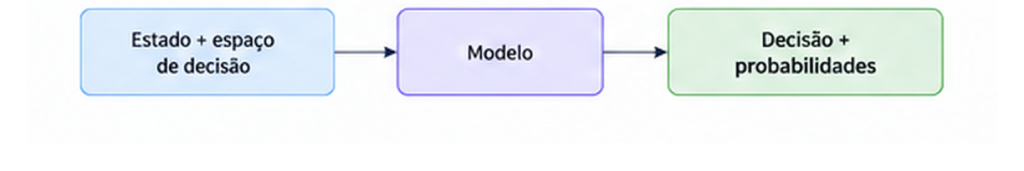
Figura 2: Fluxo de um System One Model
System One Models e LLMs
Essas arquiteturas são direcionadas a tipos diferentes de workload. LLMs generativos são a escolha natural quando você precisa produzir saídas abertas, como na redação de respostas, na sumarização de documentos, em explicações e em interfaces conversacionais. Você pode considerar System One Models quando a aplicação já delimitou as saídas possíveis e o que se espera do modelo é uma escolha entre elas.
A diferença também aparece no contrato estabelecido entre o modelo e o software. Em uma abordagem generativa, o modelo produz uma representação textual da decisão, que é interpretada depois, e a aplicação precisa lidar com respostas que não correspondem a nenhuma alternativa válida. Com um modelo de decisão, a decisão é incorporada diretamente à requisição de inferência, e a resposta é sempre uma das alternativas definidas.
Você encontra esse padrão em diferentes indústrias:
- Financial Services: informações não estruturadas são processadas em atividades como classificação de solicitações, tratamento de exceções e roteamento operacional. Quando o resultado esperado é a seleção de um fluxo previamente definido, uma resposta em linguagem natural pode não ser necessária.
- Healthcare: documentos e solicitações podem ser classificados ou encaminhados entre processos administrativos. Quando é preciso produzir uma síntese ou resposta, um modelo generativo pode ser utilizado; quando apenas o próximo workflow precisa ser identificado, a decisão pode ser representada diretamente.
- Retail: eventos relacionados a pedidos, entregas, devoluções e atendimento frequentemente precisam ser classificados antes de seguirem para sistemas downstream. Quando as saídas possíveis já são conhecidas, essa classificação pode ser tratada como uma decisão estruturada.
Em todos esses exemplos, a aplicação conhece antecipadamente as possibilidades de saída. Até este ponto, a diferença apresentada é arquitetural: não se assume que uma abordagem terá menor latência, maior throughput ou menor custo, porque essas características dependem do modelo, da infraestrutura e do workload. O playground apresentado ao final permite observá-las em um caso concreto.
Por que o Laya é relevante
O primeiro ganho de um System One Model é de forma, e não apenas de desempenho. Como nenhum texto é gerado, não existe resposta para interpretar nem formato para validar, e a aplicação sempre recebe uma alternativa válida. Isso simplifica o código ao redor do modelo e elimina uma classe inteira de falhas, como respostas fora do vocabulário esperado ou texto adicional em torno da decisão.
O segundo ganho vem da forma de inferência. Diferentemente de um LLM generativo, que é autoregressivo e constrói a resposta token a token, o Laya é um modelo do tipo encoder e avalia todas as perguntas de uma requisição em um único forward pass. A documentação do projeto reporta cerca de 33 ms para uma pergunta e cerca de 7 ms por pergunta em lote, em uma GPU NVIDIA T4. Como o modelo roda na infraestrutura da aplicação, esse custo é o da capacidade provisionada, e não um custo por token, o que muda a conta para workloads de alto volume, como classificação de eventos ou triagem de solicitações.
O terceiro ganho é a confiança. As probabilidades do Laya são treinadas com strictly proper scoring rules, e a documentação mostra como usá-las para confidence gating: acima de um limiar, a decisão é aplicada automaticamente; abaixo dele, o caso é encaminhado para revisão humana ou para um modelo maior. O pacote também permite marcar respostas abaixo de uma confiança mínima como abstenção (min_confidence), o que dá à aplicação uma forma explícita de reconhecer quando o modelo não tem certeza.
Esses recursos tornam o Laya útil em pontos em que um LLM seria caro ou lento demais. O projeto já inclui conjuntos de perguntas prontos para roteamento de requisições entre modelos pequenos e modelos de fronteira, guardrails de prompt (jailbreak, prompt injection e vazamento de instruções), moderação de conteúdo e triagem de tickets de suporte, além de integrações com LangChain, LangGraph e um servidor MCP. Nesses casos, o Laya não substitui o LLM: ele decide rapidamente o que fazer antes de o LLM ser chamado, ou se ele precisa ser chamado.
A própria documentação também é clara sobre os limites. Os checkpoints publicados são uma base rápida para especialização, e não um motor de decisão pronto para qualquer domínio: no benchmark de decisões tipadas do projeto, os checkpoints base ficam próximos do acaso sem ajuste, enquanto o checkpoint com fine-tuning chega a 0,766 de acurácia. As probabilidades também saem superconfiantes e precisam de um ajuste de temperatura com dados do domínio antes de serem usadas como limiar. O projeto disponibiliza um notebook de fine-tuning para esse fim, e esses limites devem fazer parte de qualquer avaliação.
Conhecendo o Laya
O Laya é implementado como um modelo não autoregressivo voltado a decisões tipadas. Ele suporta três tipos de pergunta: choice, para seleção entre alternativas; score, para avaliação em uma escala ordenada, como nível de urgência ou de frustração; e noul, que retorna a probabilidade de uma condição binária, como phishing ou risco de churn. O tipo noul é a nomenclatura usada pelo projeto para essas perguntas de probabilidade binária, e vale confirmá-la na documentação do Laya ao adotá-lo. Várias perguntas, de tipos diferentes, podem ser avaliadas sobre o mesmo estado em uma única requisição.
O projeto disponibiliza três checkpoints. O english usa o ModernBERT-large, com cerca de 395 milhões de parâmetros, e é o adotado nesta implementação. O ModernBERT é um modelo da família BERT (Bidirectional Encoder Representations from Transformers), uma arquitetura encoder que lê o texto inteiro de uma vez para compreendê-lo, em vez de gerar novas palavras, o que a torna adequada a tarefas de classificação e decisão. O multilingual usa o mmBERT-base e cobre mais de 100 idiomas, e o typed-decisions é um checkpoint especializado nos workflows do benchmark de decisões tipadas. Um router escolhe o checkpoint de cada requisição pelo idioma do estado, a menos que você indique um explicitamente na requisição.
Você pode definir uma requisição com uma pergunta choice da seguinte forma (arquivo laya-inference/request.json no repositório):
{
  "model": "english",
  "state": {
    "body": "My package arrived but one item is missing."
  },
  "questions": {
    "route": {
      "type": "choice",
      "instructions": "Which workflow should handle this request?",
      "criteria": {
        "fulfillment": "missing or incomplete items",
        "delivery": "shipment delays or tracking",
        "returns": "returns and refunds",
        "account": "account changes"
      }
    }
  }
}
Em uma pergunta choice, criteria é um objeto em que cada chave é uma alternativa e o valor descreve quando ela se aplica. Como resultado, o Laya retorna a decisão, a distribuição de probabilidades e uma medida de confiança, sem nenhuma explicação textual a ser interpretada:
{
  "answers": {
    "route": {
      "type": "choice",
      "choice": "delivery",
      "probabilities": { "fulfillment": 0.3385, "delivery": 0.5683, "returns": 0.0795, "account": 0.0137 },
      "confidence": 0.3163,
      "answer_confidence": 0.5683
    }
  },
  "usage": { "input_tokens": 54, "output_tokens": 0, "state_tokens": 14, "truncated": false }
}
A resposta traz dois campos de confiança com significados distintos. O answer_confidence (0,5683) é a probabilidade da alternativa escolhida, ou seja, o quanto o modelo favorece delivery sobre as demais. O confidence (0,3163) é uma medida calibrada da certeza da decisão como um todo, considerando a distribuição inteira, e é o valor indicado para confidence gating (comparar com um limiar para decidir entre aplicar a decisão ou encaminhá-la para revisão). Essa resposta foi obtida na execução desta implementação, e a decisão foi delivery, e não fulfillment, com uma distribuição pouco concentrada. Esse resultado é coerente com os limites descritos na seção anterior, e a seção “O que pode ser observado no playground” mostra como a definição das alternativas o altera.
O pacote inclui um servidor HTTP, o laya-serve, que expõe o endpoint POST /v1/systemone em um protocolo inspirado no da API do Jev e retorna também o uso de tokens de cada requisição. Como nenhuma sequência de texto é gerada, não há tokens de saída. O servidor aplica limites de entrada por padrão (até 64 perguntas, 50 mil caracteres de estado e 2 MB por requisição) e retorna mensagens de erro sem detalhes internos. Por padrão, o laya-serve escuta em 0.0.0.0; nesta implementação, ele é configurado para escutar apenas em 127.0.0.1, de forma que só os containers da mesma task consigam chamá-lo. Os comandos para executá-lo localmente, inclusive em CPU para uma primeira experiência, estão no README.md do repositório. Por ser um modelo encoder, e não um LLM autoregressivo de geração de texto, o Laya não é servido por motores como o vLLM, voltados a esse tipo de modelo generativo; o próprio laya-serve cumpre esse papel de servidor de inferência.
CPU ou GPU: o que muda nos arquivos
O Laya funciona tanto em CPU quanto em GPU, e essa é a principal decisão específica do modelo antes de pensar em infraestrutura. A diferença é de desempenho. Nas execuções desta implementação, foram observados cerca de 30 a 35 ms por requisição em uma GPU NVIDIA T4 (instância Amazon EC2 g4dn.xlarge) e cerca de 360 ms em CPU, com 4 threads. O BENCHMARKS.md do projeto, que é a referência canônica de comparação, reporta cerca de 39 ms em uma NVIDIA T4 e cerca de 580 ms em CPU para o checkpoint english. A diferença entre os cerca de 360 ms medidos aqui e os cerca de 580 ms do BENCHMARKS.md vem das condições de medição: o BENCHMARKS.md usa uma instância Amazon EC2 m7a.xlarge (AMD EPYC 9R14, 4 núcleos físicos, sem simultaneous multithreading (SMT)), em ponto flutuante de 32 bits (fp32). Para evitar comparar números medidos em condições diferentes, use os valores desta implementação como ordem de grandeza e consulte o BENCHMARKS.md para o comparativo controlado.
Para uma primeira experiência, desenvolvimento local ou volumes baixos, a CPU é suficiente e dispensa qualquer capacidade especial. Para esta demonstração, que mede latência e compara abordagens, o serviço roda em GPU. O que muda entre os dois casos são três pontos, todos pequenos.
No build da imagem, o índice do PyTorch: cpu instala a versão para CPU; cu126 instala a versão com suporte à NVIDIA T4 e exige um driver NVIDIA compatível com Compute Unified Device Architecture (CUDA) 12.6. No repositório, isso é um --build-arg:
# CPU
docker build --build-arg TORCH_INDEX=cpu --build-arg LAYA_DEVICE=cpu ...

# GPU (padrão)
docker build --build-arg TORCH_INDEX=cu126 --build-arg LAYA_DEVICE=cuda ...
A imagem para GPU fica maior (cerca de 8 GB, a maior parte bibliotecas CUDA), enquanto a de CPU é bem menor.
Na execução, a variável LAYA_DEVICE (cpu ou cuda) indica em qual dispositivo o checkpoint é carregado. O endpoint /health confirma o dispositivo em uso ("device": "cuda", por exemplo).
Na infraestrutura, apenas o caso GPU precisa declarar uma GPU para o container e rodar em uma instância que a tenha. Na container definition da task definition, isso aparece como:
"resourceRequirements": [ { "type": "GPU", "value": "1" } ]
No AWS CDK, o equivalente é gpuCount: 1 na definição do container. Para GPU, a capacidade é baseada em instâncias (como as famílias g4dn, g5 e g6). O AWS Fargate não oferece GPUs, por isso o ambiente desta demonstração usa capacidade baseada em instâncias. Para CPU, qualquer capacidade de container serve, inclusive AWS Fargate.
O restante é idêntico nos dois casos: o mesmo serve.py, os mesmos checkpoints, o mesmo contrato de API e o mesmo código do playground. Trocar entre CPU e GPU não muda a aplicação, apenas onde e como ela roda.
Empacotando o Laya em uma imagem
A imagem do Laya é definida em laya-inference/Dockerfile e segue o padrão do Dockerfile oficial do projeto. Alguns pontos são próprios de empacotar um System One Model e valem destaque:
- Pesos incluídos na imagem e fixados em uma revisão. O checkpoint é baixado durante o build, no commit revisado pelo projeto (
laya.revisions.PINNED_REVISIONS), e não na versão mais recente do repositório no Hugging Face. O carregamento executado ainda no build garante que o checkpoint funciona. Em runtime, o download é bloqueado (HF_HUB_OFFLINE=1), então a task não depende do Hugging Face para iniciar e sempre executa os mesmos pesos, distribuídos no formato safetensors. - PyTorch do índice correspondente ao dispositivo. Como descrito na seção anterior, o índice (
cpuoucu126) define o suporte a GPU. O próprio pacote instala as bibliotecas CUDA, então uma imagem base nvidia/cuda não é necessária. - Container sem privilégios (UID 10001) e servidor escutando apenas em
127.0.0.1. - Imagem base fixada por digest e versões fixas do PyTorch e do Laya. As dependências transitivas do Python não têm versão fixada, então dois builds podem instalar versões diferentes delas. Quando você precisar de builds reproduzíveis, instale as dependências a partir de um arquivo de requisitos com versões e hashes fixados (
pip install --require-hashes).
O arquivo laya-inference/serve.py inicia o mesmo servidor do laya-serve, mas carrega o checkpoint a partir do diretório local incluído na imagem. Esse ajuste é necessário porque o laya-serve identifica os checkpoints pelo nome do repositório no Hugging Face, e a biblioteca huggingface_hub tenta consultar o Hub mesmo em modo offline. Com um diretório local, nenhuma chamada ao Hub é feita, e os limites de entrada e o endpoint /health continuam sendo os do laya-serve. O laya-serve não tem autenticação, a menos que você defina a variável LAYA_API_KEY; nesta implementação ela não é definida, porque o servidor escuta apenas em 127.0.0.1 e só pode ser chamado de dentro da própria task. O serve.py também fixa todas as requisições no checkpoint english, o único incluído na imagem.
Neste exemplo, somente o checkpoint em inglês é carregado. Outros checkpoints, como o multilingual para português (veja a seção “Usando o Laya em português”), podem ser adicionados da mesma forma, de acordo com os requisitos do workload.
Nota sobre calibração: ao carregar o checkpoint
english, o Laya emite um aviso indicando que a confiança de perguntaschoicecom 11 ou mais alternativas não é calibrada nesse checkpoint. Com as 4 alternativas deste tutorial, o aviso não se aplica.
Pré-requisitos
Antes do deploy, garanta que você tem o seguinte:
- Uma conta AWS e uma Region com acesso aos modelos do Amazon Bedrock usados na comparação (Amazon Nova Micro e Amazon Nova Lite).
- Quota de GPU suficiente para a família g4dn na Region escolhida.
- Docker instalado localmente, para o build das imagens.
- AWS Cloud Development Kit (AWS CDK) instalado e com bootstrap feito na conta e na Region.
- Credenciais da AWS configuradas, com permissão para criar a rede, o cluster, a capacidade com GPU e o serviço.
O script scripts/prereqs.sh verifica ferramentas, credenciais, quotas de GPU e de Amazon VPC e o acesso aos modelos do Amazon Bedrock antes de qualquer recurso ser criado.
Rodando o Laya na AWS com o Amazon ECS
Com a imagem pronta, o Laya precisa de um lugar para rodar. Como os pesos estão embutidos na imagem, qualquer serviço de container serve, e as peças específicas do Laya (a GPU, as variáveis de ambiente, o health check em /health) seriam as mesmas em Amazon EC2, Amazon EKS ou Amazon SageMaker AI. Aqui, o ambiente usa o Amazon ECS Managed Instances, que provisiona a capacidade com GPU já com os drivers NVIDIA instalados e abstrai parte da administração das instâncias, sem exigir o AWS Fargate (que não oferece GPU).
O ambiente tem duas partes. A primeira é o Laya, implantado como um serviço de inferência privado: uma GPU é atribuída à task, o container roda com sistema de arquivos somente leitura e um health check consulta o endpoint /health. A segunda é um container com o playground, adicionado à mesma task; os dois containers conversam por localhost, e o Amazon Bedrock é chamado apenas pelo playground, para obter a resposta do modelo generativo usada na comparação. O Laya continua acessível apenas de dentro da task, e nenhuma porta é aberta na interface de rede.
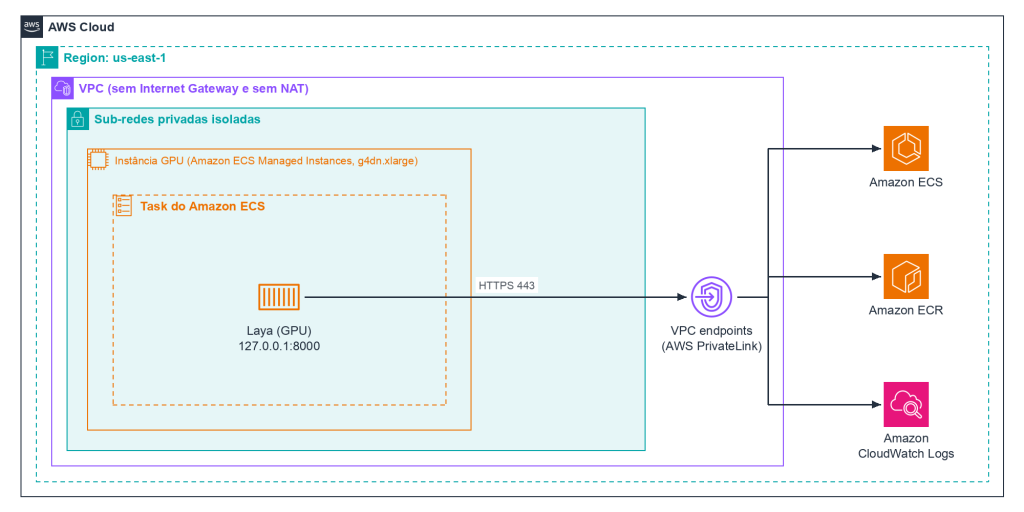
Figura 3: Primeira parte, com o Laya em execução no Amazon ECS
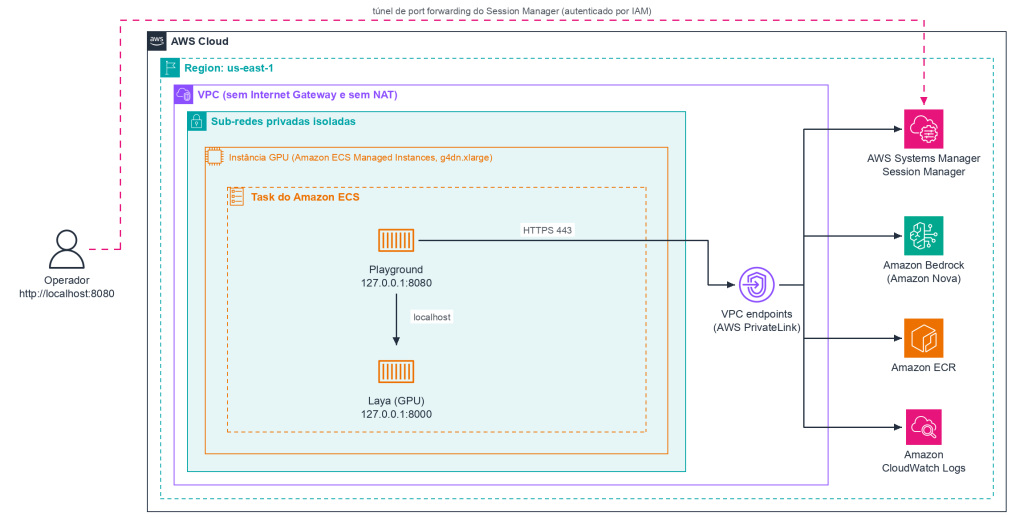
Figura 4: Ambiente completo, com o playground e a chamada ao Amazon Bedrock usada na comparação
Mesmo sendo uma demonstração, o ambiente foi desenhado sem exposição à internet e sem acesso a ela, com rede privada e sem portas de entrada, como se espera de uma prova de conceito. A Amazon Virtual Private Cloud (Amazon VPC) tem apenas sub-redes isoladas, sem Internet Gateway e sem NAT Gateway; as APIs da AWS necessárias são alcançadas por VPC endpoints do AWS PrivateLink; e os security groups das instâncias e das tasks não têm regras de entrada. A única regra de entrada do ambiente fica no security group dos VPC endpoints, que aceita HTTPS (porta 443) apenas a partir desses dois security groups. Em sub-redes isoladas, o pull de imagens do Amazon Elastic Container Registry (Amazon ECR) exige um gateway endpoint do Amazon S3 (que não tem security group), além dos endpoints de interface. O conjunto usado nesta implementação é: ecs, ecr.api, ecr.dkr, gateway do Amazon S3, logs, ssm, ssmmessages e bedrock-runtime. Para usar o playground, o operador abre um túnel por meio do AWS Systems Manager Session Manager, autenticado pelo AWS Identity and Access Management (IAM) e registrado no AWS CloudTrail. Esse é o padrão recomendado para operadores acessarem serviços privados: nenhuma porta de entrada precisa ser aberta, o AWS IAM faz a autorização e as sessões ficam registradas.
Todo o ambiente é descrito em AWS Cloud Development Kit (AWS CDK), no diretório infra/ do repositório, em um único stack que cria a rede, os VPC endpoints, o cluster, a capacidade com GPU e o serviço. As imagens do Laya e do playground são construídas e publicadas pelo próprio cdk deploy no repositório de assets do AWS CDK no Amazon ECR, com o hash do conteúdo como tag, de forma que uma versão publicada nunca é sobrescrita. Os detalhes de rede, capacity provider, task definition e roles do AWS IAM estão no stack e no README.md do repositório.
Com os pré-requisitos atendidos, você levanta o ambiente com os scripts do repositório:
# Verifica ferramentas, credenciais, quotas de GPU e de Amazon VPC e acesso ao Amazon Bedrock
./scripts/prereqs.sh

# Cria o ambiente completo
./scripts/deploy.sh

# Opcional: cria apenas a primeira parte, sem o playground
./scripts/deploy.sh -c withPlayground=false
Na primeira execução, o deploy.sh leva de 20 a 30 minutos: cerca de 10 minutos para a infraestrutura e o serviço, e o restante para o build e o push das imagens. A etapa mais demorada costuma ser o build e o push da imagem do Laya, de cerca de 8 GB por causa das bibliotecas CUDA: em computadores ARM, como Macs com Apple Silicon, o build linux/amd64 roda sob emulação e pode levar de 15 a 20 minutos. Em produção, o build e a publicação das imagens normalmente ficam em um pipeline de integração e entrega contínuas (CI/CD), que constrói a imagem uma vez e promove a mesma versão entre ambientes.
Antes de incluir o playground, você pode criar essa primeira parte isoladamente com ./scripts/deploy.sh -c withPlayground=false, o que ajuda a validar o provisionamento da GPU, o carregamento do checkpoint e a inicialização do servidor. Quando a task fica HEALTHY, o Laya está rodando como um serviço de inferência containerizado, e o /health informa em qual dispositivo o checkpoint foi carregado.
Adicionando o playground
Embora uma API seja suficiente para integração entre sistemas, uma interface ajuda a inspecionar o comportamento do modelo durante o tutorial. Você inclui um segundo container, com uma pequena aplicação Streamlit em playground/app.py, na mesma task do Amazon ECS, com duas páginas. Assim como o Laya, o Streamlit escuta apenas em 127.0.0.1, e o container só é iniciado depois que o Laya fica saudável (dependsOn com a condição HEALTHY).
Na primeira página, você informa um payload System One diretamente e o envia ao Laya, e a página apresenta a decisão, a latência e o uso de tokens. Ela serve para testar diferentes estados e espaços de decisão contra o modelo:
result, elapsed_ms = call_laya(payload)
usage = result.get("usage", {})
st.metric("Latency", f"{elapsed_ms:.1f} ms")
st.metric("Input tokens", usage.get("input_tokens", 0))
st.metric("Output tokens", usage.get("output_tokens", 0))
st.json(result)
Na segunda página, uma única entrada executa a mesma tarefa com o Laya e com um modelo generativo do Amazon Bedrock, escolhido na própria página entre o Amazon Nova Micro e o Amazon Nova Lite. As alternativas informadas pelo usuário viram os criteria da pergunta choice para o Laya e as opções listadas no prompt para o modelo generativo. O Laya é chamado via POST /v1/systemone e o modelo generativo via Converse API do Amazon Bedrock, de modo que os dois recebem a mesma tarefa, cada um por sua interface:
import boto3
from botocore.exceptions import ClientError

bedrock = boto3.client("bedrock-runtime")

def call_bedrock(text, options):
    prompt = (
        "Select exactly one option that best matches the input.\n"
        f"Options: {', '.join(options)}\n"
        f"Input: {text}\n"
        "Return only the option name."
    )
    try:
        response = bedrock.converse(
            modelId=MODEL_ID,
            messages=[{"role": "user", "content": [{"text": prompt}]}],
            inferenceConfig={"maxTokens": 20, "temperature": 0},
        )
        return response
    except ClientError:
        # Exibe uma mensagem genérica na interface, sem detalhes internos
        raise
No Laya, a decisão é lida em answers.route.choice, junto com probabilities e confidence; no Amazon Bedrock, a decisão é o texto retornado pelo modelo, que a aplicação ainda precisaria validar. As chamadas são envolvidas em tratamento de erro e a interface exibe mensagens genéricas, sem detalhes internos.
Em muitas Regiões, os modelos Amazon Nova são invocados por um inference profile (por exemplo, us.amazon.nova-micro-v1:0), e não pelo ID direto do modelo. Nesse caso, confirme se o MODEL_ID é um inference profile e ajuste a policy para incluir o Amazon Resource Name (ARN) do profile e os ARNs dos modelos nas Regiões de destino.
Ao task role é concedida a permissão bedrock:InvokeModel restrita aos ARNs dos modelos configurados, usando as credenciais associadas ao role, sem credenciais estáticas no container. Essa lista de modelos é definida no stack e é a mesma usada para gerar as permissões. Quando o Amazon ECS Exec é habilitado (veja a próxima seção), o AWS CDK adiciona ao mesmo role as permissões que ele exige: as ações de canal do Session Manager e a escrita dos logs das sessões no Amazon CloudWatch Logs. Como os dois containers compartilham o task role, essas permissões também ficam ao alcance do container do Laya; para um isolamento maior, cada container pode rodar em uma task própria, com o seu próprio role. O detalhamento completo dessas ações está no stack do AWS CDK no repositório.
Acessando o playground
O playground não é exposto à internet: nenhum load balancer, IP público ou regra de entrada é usado para acessá-lo. O acesso é feito com o Amazon ECS Exec, que usa o Session Manager para abrir um túnel de port forwarding do computador local até a porta 8080 da task. Como o Amazon ECS Exec vem desligado por padrão no repositório, você o habilita no deploy com ./scripts/deploy.sh -c enableExecuteCommand=true. O script scripts/tunnel.sh localiza a task em execução e abre a sessão; com ela ativa, o playground fica disponível em http://localhost:8080, somente para quem abriu a sessão, com o tráfego criptografado e o acesso dependente de permissões do AWS IAM (ssm:StartSession no alvo).
Como os comandos do Amazon ECS Exec rodam como root dentro do container, conceda a permissão apenas a quem realmente precisa, e deixe o Amazon ECS Exec desabilitado quando não estiver em uso, o que você faz com um novo ./scripts/deploy.sh sem essa opção. Esse mecanismo é pensado para acesso de operadores, e não para distribuir uma aplicação a usuários finais; o caminho para isso é descrito em “Considerações para produção”.
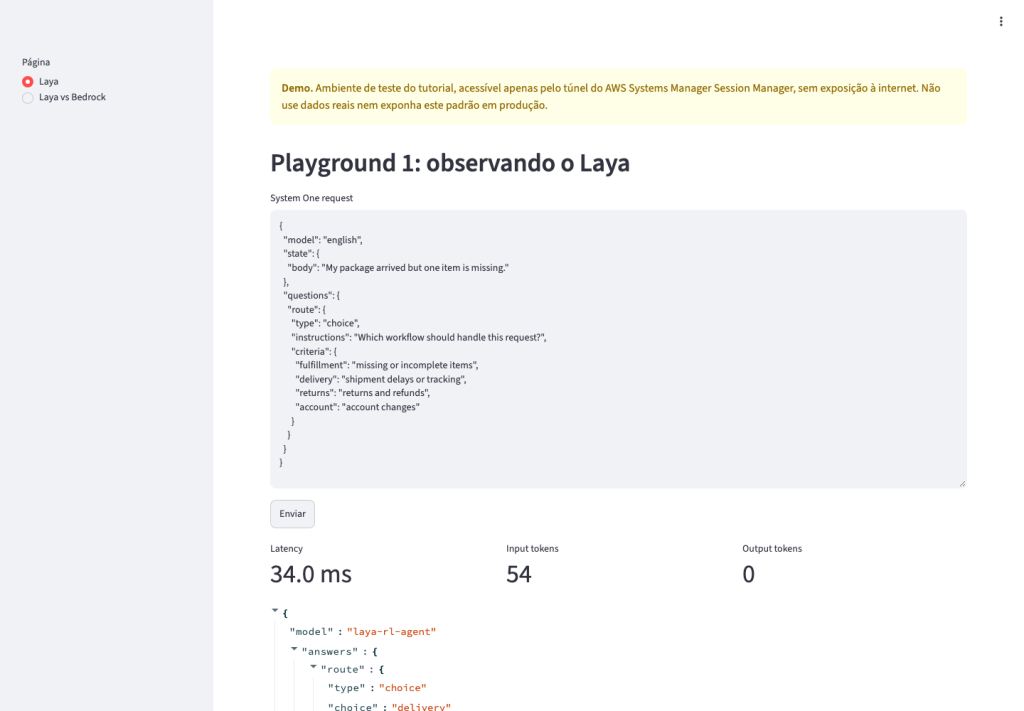
Figura 5: Playground 1, com a resposta do Laya
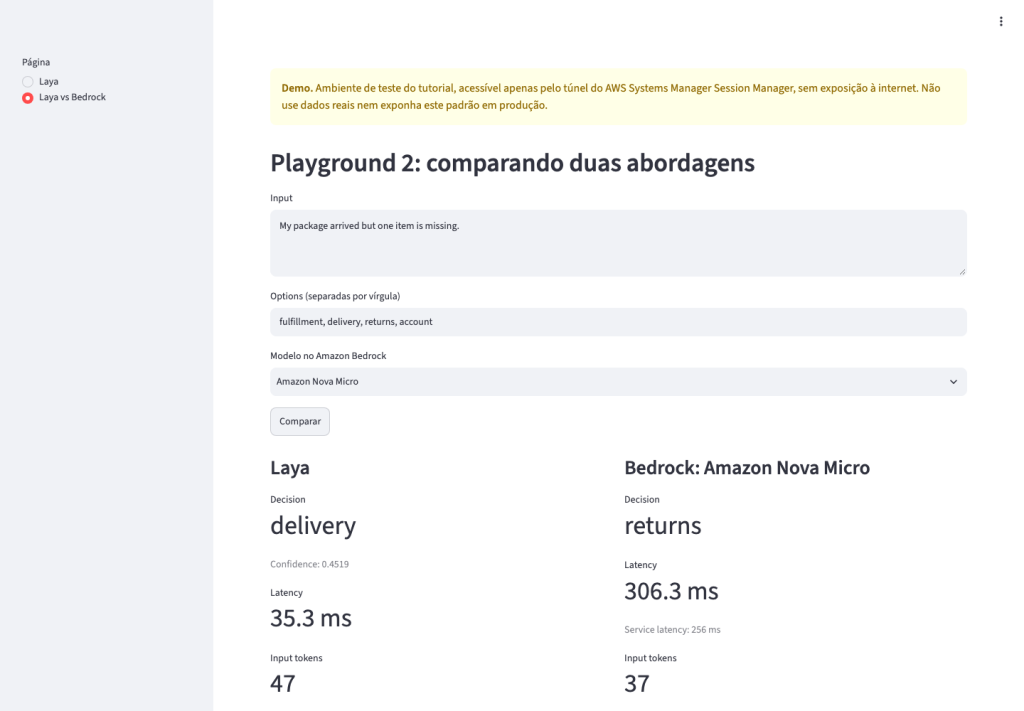
Figura 6: Playground 2, com a mesma tarefa no Laya e no Amazon Nova Micro
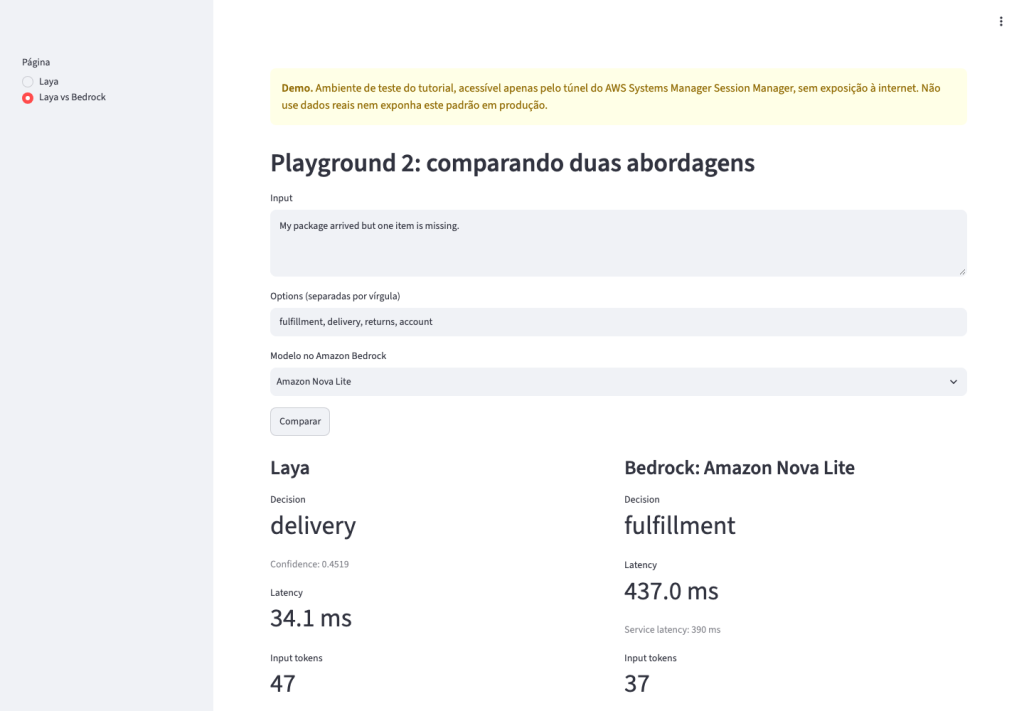
Figura 7: Playground 2, com o Amazon Nova Lite selecionado
O que pode ser observado no playground
O objetivo da comparação não é determinar qual modelo é superior, e sim observar duas formas de tratar a mesma decisão. No Laya, a decisão faz parte da interface do modelo e vem acompanhada de uma distribuição sobre as alternativas. No modelo generativo, a tarefa é descrita em uma instrução e a resposta é um texto que a aplicação precisaria validar antes de usar.
Na execução em uma instância Amazon EC2 g4dn.xlarge, o Laya retornou delivery em cerca de 30 a 35 ms, com 54 tokens de entrada e nenhum de saída. O Amazon Nova Micro retornou returns em todas as execuções, com cerca de 250 a 300 ms de latência de serviço. O Amazon Nova Lite alternou entre returns e fulfillment em execuções diferentes, com o mesmo prompt e temperature: 0, e cerca de 260 a 400 ms de latência de serviço. fulfillment, a alternativa esperada, não foi escolhida de forma consistente por nenhum modelo, o que reforça que uma única chamada não é um benchmark e que uma avaliação precisa de exemplos representativos. Os números de tokens também não são diretamente comparáveis, porque os tokenizadores e as arquiteturas são diferentes.
No Laya, a forma como você descreve as alternativas faz parte do prompt. Com os mesmos pesos e o mesmo estado, o exemplo com rótulos curtos resultou em delivery, com probabilidade de 0,57; com descrições mais específicas, em fulfillment, com 0,44; e com rótulos descritivos, como missing_items e late_delivery, em missing_items, com 0,94. Rótulos que expressam a situação, e não apenas o nome do workflow, tendem a produzir decisões mais corretas e mais confiantes, e esse é um dos primeiros ajustes a avaliar antes de considerar um fine-tuning.
Usando o Laya em português
Os exemplos apresentados estão em inglês e usam o checkpoint english, que não é indicado para textos em português. Para português, o projeto oferece o checkpoint multilingual, baseado no mmBERT-base, que cobre mais de 100 idiomas e é cerca de duas vezes mais rápido. Assim como o english, ele deve ter suas temperaturas ajustadas com dados do domínio antes de as probabilidades serem usadas como limiar.
A adaptação do ambiente envolve três pontos. Na imagem, o checkpoint convaiinnovations/laya-multilingual precisa ser baixado no build e registrado em laya-inference/serve.py, que hoje fixa todas as requisições no english; no servidor, ele precisa estar em LAYA_MODELS, por exemplo english,multilingual; e, nas requisições, você indica o checkpoint com "model": "multilingual". Sem esse campo, o Laya escolhe o checkpoint pelo idioma do texto, e a documentação do projeto descreve essa detecção como “best-effort” para idiomas de alfabeto latino, então fixar o checkpoint evita que textos curtos em português sejam encaminhados ao english. O restante do ambiente, incluindo rede, capacidade e playground, não muda.
Considerações para produção
O ambiente foi mantido reduzido para que você possa observar os componentes principais, mas já adota controles que devem ser mantidos em produção: rede sem acesso à internet, regras de entrada apenas no security group dos VPC endpoints, restritas a HTTPS a partir das instâncias e das tasks, containers sem root, pesos fixados em uma revisão e permissões restritas. O que muda em produção é principalmente como o serviço é consumido e como a qualidade das decisões é garantida.
Se o Laya precisar ser consumido por outras aplicações, o endpoint deve continuar privado e autenticado, por exemplo com um Application Load Balancer interno com HTTPS e o bearer token do laya-serve (LAYA_API_KEY) armazenado no AWS Secrets Manager. Se uma interface precisar ser acessada por usuários, o caminho é HTTPS com certificado do AWS Certificate Manager e autenticação com o Amazon Cognito, o que também permite desligar o Amazon ECS Exec no container da aplicação. Como nomes públicos continuam sendo resolvidos dentro da Amazon VPC, o Route 53 Resolver DNS Firewall pode restringir as consultas aos domínios necessários.
Do lado do modelo, registre a tag da imagem e a revisão do checkpoint junto com as inferências quando precisar de rastreabilidade, e o Laya aceita uma lista de digests SHA-256 dos pesos (LAYA_SHA256_DIGESTS), verificada antes do carregamento. Ajuste as temperaturas de calibração com dados do domínio antes de usar qualquer limiar de confiança para automação, e considere o fine-tuning quando o espaço de decisão for específico do negócio. Por fim, defina capacidade e scaling a partir de medições do workload, com conjuntos representativos e diferentes níveis de concorrência, e não de uma requisição individual.
Limpando os recursos
A instância com GPU e os VPC endpoints são cobrados por hora enquanto existirem, então remova o ambiente assim que concluir os testes. O script scripts/destroy.sh faz a remoção completa em cerca de 10 minutos e deve ser usado no lugar de um cdk destroy direto, porque o service é zerado e o Amazon ECS é solicitado a remover a instância com GPU antes de o stack ser apagado. O procedimento está documentado no README.md do repositório.
Conclusão
Com modelos generativos, foi estabelecida uma interface geral para processar informações não estruturadas e produzir novas sequências de conteúdo. Com System One Models, você pode usar outro contrato: a aplicação define um espaço de decisão e o modelo produz uma resposta estruturada, com probabilidades e confiança, dentro desse espaço. Essa diferença de contrato é o que permite tratar decisões como qualquer outro componente de software, com entradas e saídas previsíveis.
Aqui, coloquei esse padrão em execução na AWS com o Laya. Empacotei o modelo como um container com pesos fixados e o executei em GPU no Amazon ECS Managed Instances, em uma Amazon VPC sem acesso à internet, e o comparei, em um playground acessado pelo Session Manager, a modelos generativos do Amazon Bedrock. Como o Laya é apenas um container, as mesmas peças rodariam em Amazon EC2, Amazon EKS ou Amazon SageMaker AI; a escolha do Amazon ECS foi de conveniência e de isolamento. A comparação mostrou a diferença de forma e de latência entre as abordagens e também a importância de avaliar a qualidade das decisões com exemplos do próprio domínio.
Nenhuma das abordagens precisa ser tratada como substituta da outra. Quando é preciso produzir uma saída aberta, a geração faz parte do próprio requisito; quando a saída esperada pertence a um conjunto conhecido de decisões, um System One Model é mais uma opção arquitetural, que pode inclusive atuar antes do LLM, e deve ser avaliado pelos mesmos critérios aplicados aos demais componentes de produção: qualidade, latência, throughput, custo e requisitos operacionais.
Autor
 |
Guilherme Ricci é Arquiteto de Soluções Sênior, para startups na Amazon Web Services, especializado no Setor Financeiro, ajudando startups a modernizar e criar arquiteturas escaláveis resilientes e de baixo custo, além de modernizar suas aplicações. Com mais de 15 anos de experiência em empresas do setor financeiro, atualmente trabalha com a equipe de especialistas em AI. |