Amazon Web Services ブログ
AWS での多段階攻撃の検出: サービス横断のシグナル相関分析ガイド
本ブログは 2026 年 8 月 26 日に公開された AWS Blog “Detecting multi-stage attacks on AWS: A guide to cross-service signal correlation” を翻訳したものです。
1 つのセキュリティサービスから届くアラート単体でわかるのは、何かが起きたという事実だけです。そのシグナルを他のサービスのアクティビティやお客様のビジネスコンテキストと合わせて読み解くことで、それが多段階攻撃の一部かどうかを判断できます。
次のような短い一連の流れを考えてみましょう。あるアイデンティティが、これまで使用したことのない送信元アドレスから GetCallerIdentity を呼び出します。数分以内に、同じアイデンティティが複数のサービスにわたって List 呼び出しと Describe 呼び出しを集中的に実行し、その一部が AccessDenied で失敗します。その直後、先週登録されたばかりのドメインに向けて、大量のデータが環境外へ送出されます。Amazon GuardDuty は、なじみのない送信元からの偵察など、この流れの一部を Recon:IAMUser/* や Discovery:S3/* などの検出結果タイプで既に検出している可能性があります。各要素を相関付けることで、お客様のビジネスコンテキストと結び付いた一連の流れの全体像を把握できます。これにより、検出結果を 1 件ずつトリアージするのではなく、全体として対処できるようになります。
この記事は、Amazon Web Services (AWS) の検出サービスを運用しており、自身の環境に固有のパターンをとらえたいセキュリティエンジニアとセキュリティオペレーションチームを対象としています。AWS の検出機能とビジネスコンテキストがどのように組み合わさるのか、そしてそのコンテキストを活用した相関分析をどのように構築するのかを説明します。例はいずれも Amazon CloudWatch Logs Insights で実行できるので、すぐに試せます。最後のセクションでは、これらを自動化されたパイプラインへ発展させる方法も説明します。これらのクエリの前提条件は、この記事の後半のウォークスルーに記載しています。
AWS の検出サービスから始める
まずは AWS の検出サービスを活用しましょう。これらのサービスは多くのお客様に共通する脅威をカバーしており、この記事の内容もすべてこれらを基盤としています。
- Amazon GuardDuty は、AWS CloudTrail、Amazon Virtual Private Cloud (Amazon VPC) フローログ、DNS クエリログ、Amazon Simple Storage Service (Amazon S3) データイベントなどのアクティビティを分析し、追加設定なしで信頼度の高い検出結果を生成します。
- Amazon Detective (リソースと検出結果の関係を可視化するセキュリティ調査サービス) を使用すると、サービスやアカウントをまたいだグラフベースのコンテキストで検出結果を調査できます。
- AWS Security Hub は、セキュリティの検出結果を集約し、優先順位付けされた単一のダッシュボードに表示します。
- Amazon Security Lake は、セキュリティデータを専用のデータレイクに一元化し、長期的な分析に向けて Open Cybersecurity Schema Framework (OCSF) 形式で保存します。
- Amazon Inspector (ワークロードのソフトウェアの脆弱性をスキャンする脆弱性管理サービス) は、脆弱性データをワークロードのコンテキストと相関付けます。
独自の仕組みを構築する前に、これらのサービスを有効にしてチューニングしてください。ここでいうチューニングとは、環境に合わせて感度を調整して誤検知を減らすこと、各サービスが監視するデータソースを選択すること、既知の正常なパターンに対する検出結果を抑制することを指します。
GuardDuty が多段階攻撃を自動的に相関付ける
手作業で何かを構築する前に、GuardDuty が既に何をしてくれるのかを確認しましょう。Amazon GuardDuty 拡張脅威検出は、AWS CloudTrail、Amazon S3 データイベント、Runtime Monitoring、Amazon Elastic Kubernetes Service (Amazon EKS) の監査ログなど、複数のデータソースにわたるシグナルを相関付けます。そして多段階のパターンを検出すると、重大度が「重大」の攻撃シーケンス検出結果を 1 つ発行します。認証情報の侵害に続くデータ持ち出し (エクスフィルトレーション) などのシーケンスを認識し、それらを MITRE ATT&CK の戦術にマッピングしたうえで、タイムラインと修復ガイダンスを添付します。現在 GuardDuty を有効にしている場合、GuardDuty 拡張脅威検出はデフォルトで既に有効になっており、クエリを作成する必要はありません。GuardDuty の料金の適用方法の詳細については、「Amazon GuardDuty の料金」を参照してください。
冒頭の例で示した認証情報の侵害シーケンスは、まさに GuardDuty 拡張脅威検出が検出対象とする普遍的なパターンです。このようなパターンの検出は GuardDuty 拡張脅威検出に任せてください。攻撃シーケンス検出結果は GuardDuty コンソールで他の検出結果と並んで表示され、他の検出結果と同じように Security Hub や対応ワークフローにルーティングされます。
GuardDuty が対処するのは、どのアカウントでも同じように見える脅威です。一方で GuardDuty には、ある操作がお客様のアカウントでは不審だと判断するためのコンテキストがありません。そのコンテキストを提供するのがお客様の役割です。
ビジネスコンテキストを追加する
ビジネスコンテキストとは、お客様の環境についてお客様だけが知っている情報です。例えば、どのバケットに機密データが保存されているか、どのプリンシパルがどのリソースにアクセスする正当な理由を持っているか、ポリシーでどのロールチェーンが許可されているか、本番環境の変更ウィンドウがいつかといった情報です。GuardDuty 拡張脅威検出は多くのお客様に共通するパターンから学習しますが、こうした環境固有の問いには答えられません。これらを相関分析として表現することで、お客様の環境に合わせてチューニングされた検出レイヤーを追加できます。以下の 4 つのパターンでは、こうした事実をそれぞれ 1 つずつクエリに落とし込みます。
これらのクエリは、AWS マネジメントコンソールで CloudWatch を開き、[ログ]、[ログのインサイト] の順に選択して、CloudWatch Logs Insights のクエリ言語で実行します。ほとんどのクエリは、証跡の配信先である CloudWatch Logs ロググループから CloudTrail イベントを読み取ります。証跡の出力先が Amazon S3 のみの場合は、証跡に CloudWatch Logs への配信を追加するか、Amazon Athena (SQL を使用して Amazon S3 のデータを分析するサーバーレスのクエリサービス) で同等のクエリを実行してください。
注: この記事のクエリとコードでは、プレースホルダー値を使用しています。実行前に、
your-sensitive-bucket(S3 バケット名)、your-key-id(AWS KMS キー ID)、region(us-east-1 などの AWS リージョン)、account-id(12 桁の AWS アカウント ID)、aws-cloudtrail-logs-my-trail(CloudTrail ロググループ名) を実際の値に置き換えてください。
マルチアカウント環境についても補足しておきます。AWS Organizations では、組織の証跡がすべてのアカウントのイベントを 1 つのロググループに配信します。そのため、これらのクエリはそのまま機能しますが、複数アカウントにまたがる結果が返されます。アカウント単位で確認するには、recipientAccountId でフィルタリングしてください。組織の証跡を使用していない場合は、アカウントごとにクエリを実行するか、Amazon Security Lake を一元的なクエリの基盤として使用してください。
AWS サービスにマッピングした攻撃チェーン
多段階攻撃は 5 つのフェーズを経て進行し、フェーズごとに異なるサービスにシグナルが残ります。これらのシグナルは、次の 3 つのログソースに現れます。アカウント内の API アクティビティを記録する CloudTrail、ネットワーク接続のメタデータをキャプチャする Amazon VPC フローログ、そして VPC からの DNS クエリを記録する Amazon Route 53 Resolver クエリログです。
- 初期アクセス – 盗まれた認証情報が環境内で使用されます。CloudTrail には、なじみのない送信元からの
GetCallerIdentity、GetSessionToken、またはAssumeRoleが記録されます。 - 探索 – 脅威アクターは
List、Describe、Getの呼び出しでリソースを列挙します。その際、多くの場合AccessDeniedレスポンスが発生します。 - 権限昇格 – 脅威アクターはロールを連鎖させたり、ポリシーを編集したりします。CloudTrail には、
AssumeRoleのシーケンス、PutRolePolicy、またはCreateAccessKeyが記録されます。 - ラテラルムーブメント (横展開) – 脅威アクターはアカウントや AWS リージョンをまたいで移動し、普段使われていない場所でロールを引き受けたり、リソースを作成したりします。
- データ持ち出し – 大規模な
GetObject呼び出し、VPC フローログに記録される大量のアウトバウンド転送、Route 53 Resolver クエリログに記録される最近登録されたドメインへの DNS クエリを通じて、データが持ち出されます。
図 1 は、5 つの攻撃フェーズと、各フェーズを記録する AWS のログソースとの対応を示しています。
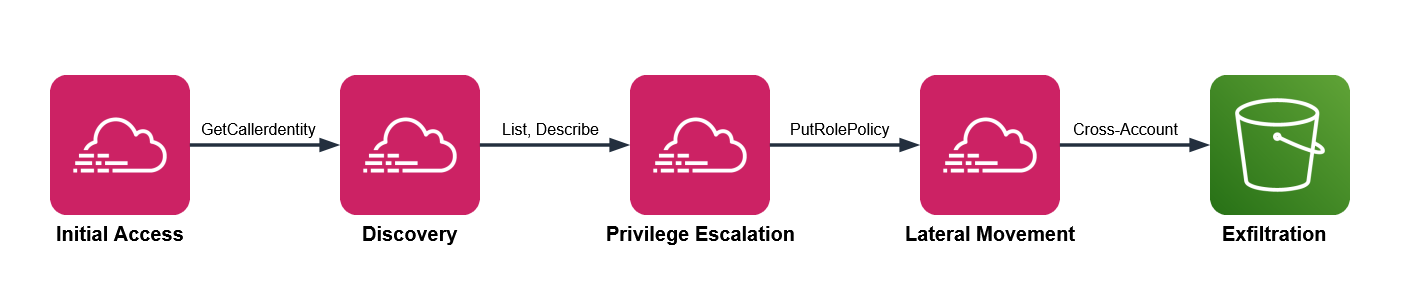
図 1: AWS サービスにマッピングした攻撃チェーン
GuardDuty 拡張脅威検出は、このチェーン全体を対象に普遍的なパターンを監視します。以下の 4 つのパターンでは、そこにお客様ならではの観点、つまりビジネスコンテキストを追加します。
パターン 1: 想定外のプリンシパルによる機密データへのアクセス
この検出を支えるのは、データ分類と通常のアクセスパターンです。例えば、あるバケットには顧客記録が、別のバケットには公開ウェブアセットが保存されているとします。お客様は、機密性の高い顧客記録を読み取る正当な理由があるプリンシパルがどれかを把握しています。その知識をルールとして組み込むと、一見ありふれた読み取りが、追跡すべき事象に変わります。
ここでは 3 つのシグナルが重なり合います。CloudTrail には、機密として分類したバケットに対する大量の GetObject が記録されます。そのプリンシパルは、このバケットの読み取りが想定されるプリンシパルのリストに含まれていません。さらに、VPC フローログには同じ時間枠内に同じ送信元からの大量のアウトバウンド転送が記録され、DNS クエリログには最近登録された宛先ドメインが記録されます。これらが組み合わさることで、潜在的な脅威が存在するという確信度が高まります。
CloudTrail の管理イベントには GetObject は記録されません。GetObject をキャプチャするには、対象のバケットで CloudTrail データイベントを有効にする必要があります。該当するバケットでデータイベントが有効になっていなかったために、GetObject を見逃しているチームは少なくありません。
次のクエリは、機密バケットに対する大量の読み取りをプリンシパル別にグループ化して表示します。CloudTrail ロググループを選択した状態で、CloudWatch Logs Insights で実行してください。
しきい値の 100 はプレースホルダーです。通常時の 1 週間分のアクティビティに対してクエリを実行し、そのバケットの読み取り回数の 95 パーセンタイルを求めて、それを上回る値をしきい値に設定してください。次に、クエリが返した各プリンシパルを、読み取りが想定されるプリンシパルのリストと照合します。リストに含まれていないプリンシパルが大量に読み取っている場合、それが調査すべき結果です。
裏付けを取るには、対応するアウトバウンド転送を探します。ロググループの選択を VPC フローログのロググループに切り替えて、次のクエリを実行してください。
Amazon S3 のクエリはプリンシパルを返しますが、フローログのクエリは IP アドレスを対象とするため、プリンシパルを IP アドレスに変換する必要があります。この変換の詳細は、この記事の後半の実践例で説明します。
レポート用バケットを 1 日中読み取っている分析ロールを想像してみてください。ある日の午後、このロールがレポート用バケットではなく顧客記録バケットから 1,000 個のオブジェクトを読み取ったとします。GuardDuty は反応しません。認証済みのロールが有効な GetObject 呼び出しを行うこと自体は、他の環境では不審とみなされないからです。一方、お客様のクエリはこれを検出します。そのロールが、このバケットの読み取りが想定されるプリンシパルのリストに含まれていないからです。お客様が適用した分類こそが、何も起きていないように見える状況をシグナルに変えるのです。
図 2 は、CloudTrail に記録された機密バケットからの大量の読み取り、VPC フローログに記録された大量のアウトバウンド転送、Route 53 Resolver ログに記録された登録されて間もないドメインの名前解決を示しています。
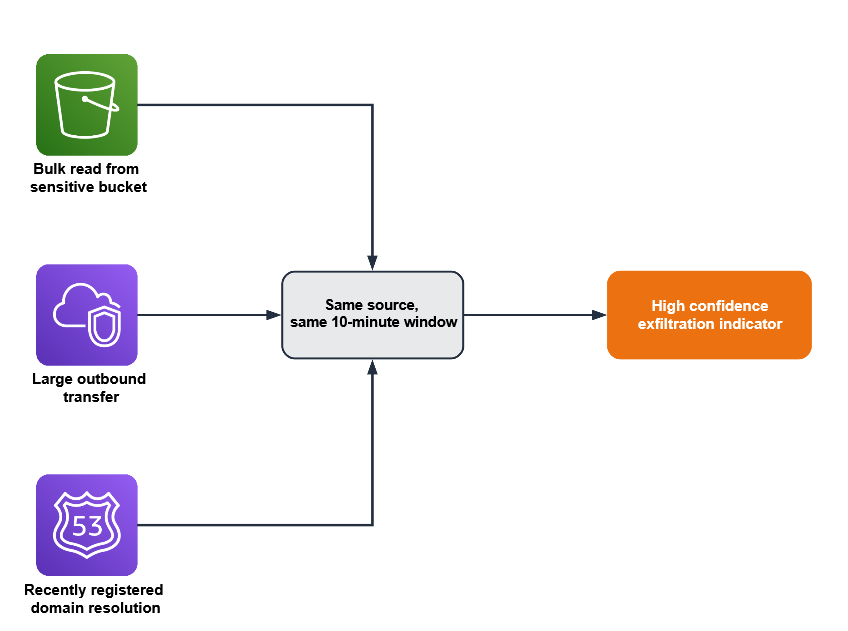
図 2: 単一の時間枠内で重なり合い、データ持ち出しを示す 3 つのシグナル
パターン 2: アクセスポリシーを逸脱するロールチェーン
ビルドのために 1 つ目のロールを引き受け、続いてリリースのために 2 つ目のロールを引き受けるデプロイを想像してみてください。あるプリンシパルにとって、この 2 ホップの AssumeRole チェーンは日常的なものですが、別のプリンシパルにとってはポリシー違反になります。このパターンの前提となるのは、組織が許可するチェーン、つまり信頼トポロジーです。その知識をクエリに組み込みましょう。
このパターンでは、次の 3 つの条件を満たすものを検出します。
- CloudTrail に、短い時間枠内で同じ送信元からの複数の
AssumeRole呼び出しが記録されている - チェーンが
CreateAccessKey、PutRolePolicy、AttachUserPolicyなどのセキュリティ上重要なアクションで終わる - 起点となるアイデンティティが、ポリシー上、そのチェーンを実行する主体として想定されていない
CloudWatch Logs Insights で CloudTrail ロググループを選択し、2 ホップ以上のチェーンを抽出する次のクエリを実行してください。
チェーンは最小で 2 ホップです。環境内でロールを頻繁に連鎖させている場合は、カウントを引き上げてください。デプロイパイプラインは 1 時間に複数のロールを引き受けることが多く、AWS Security Hub などの AWS サービスプリンシパルも同様です。パイプラインロールや既知の AWS サービスプリンシパルなど、複数のロールを引き受けることが想定されるアイデンティティは除外してください。残ったものが調査対象です。例えば、人が通常とは異なる時間帯に複数のロールを引き受け、最終的に新しいアクセスキーを作成しているケースなどです。この区別はデータとして管理してください。つまり、正常とみなすアイデンティティとアクションをリスト化し、そのリストから外れるチェーンを確認します。
パターン 3: キーを所有するワークロード以外で使用される暗号化キー
ここでのシグナルは、リソースの所有関係です。特定の AWS Key Management Service (AWS KMS) キーはワークロードの暗号化キーを作成および管理するもので、1 つのキーは決済サービスなど 1 つのワークロード専用であるべきです。キーに対する Decrypt 呼び出しは有効かつ認可された API アクションなので、呼び出し自体に不審な点はありません。別のプリンシパルによるこのキーの使用を、改めて確認すべき事象に変えるのは、お客様が定めた所有ルールです。
このパターンは、1 つのワークロードに限定されたカスタマーマネージドキーにのみ適用されます。AWS マネージドキー (alias/aws/*) や、意図的に複数のサービス間で共有しているカスタマーマネージドキーには適用されません。このルールをデプロイする前に、キーポリシーの Principal ブロックで、キーが単一のワークロード向けであることを確認してください。
次の 2 つの条件がそろう場合は、不正使用の可能性があります。
- CloudTrail に、1 つのワークロードに関連付けられたキーに対する
DecryptまたはGenerateDataKeyの呼び出しが記録されている - 呼び出し元のプリンシパルが、そのワークロードを所有するロールではない
CloudTrail ロググループに対して次のクエリを実行し、特定のキーに対して API を呼び出したプリンシパルを一覧表示します。
返された結果を、想定している 1 つのワークロードロールと比較してください。そのキーを使用する想定外のプリンシパルが見つかれば、それがシグナルです。キーの不正使用はデータ窃取の初期段階に見られる行動であり、この相関分析では、所有関係を把握しているお客様にしか検出できないアクティビティをとらえられます。
決済データベースを暗号化しているキーを例に考えてみましょう。通常の運用では決済サービスのロールがこのキーに対して API を呼び出し、それ以外のロールが呼び出すことはないはずです。開発者ロールや新しく作成されたロールがこのキーに対して Decrypt を実行した場合、呼び出しは成功し、単独で見れば通常の操作にしか見えません。これを問題として扱う根拠は、お客様が頭の中で把握している所有ルールであり、このクエリはそれを明文化したものです。
パターン 4: 変更ウィンドウ外での特権アクション
まずクエリを確認し、そのうえで意味を読み解いていきましょう。
このクエリは CloudTrail ロググループに対して実行します。スケジュール実行する際は対象期間を業務時間外に絞り込み、変更ウィンドウ外のアクティビティだけが返されるようにします。ここで何を正常とみなすかは、お客様の変更プロセスによって決まります。本番環境のセキュリティやアイデンティティに関する変更は、定められた時間帯にパイプラインを通じて、既知のアクターによって実行されます。午前 2 時にコンソールから行われたポリシー変更が、パイプラインではなく人によるものであれば、こうした想定には当てはまりません。シグナルとなるのは、PutRolePolicy や AuthorizeSecurityGroupIngress などのセキュリティ上重要な変更が、ウィンドウ外に、パイプラインロールではなく人によって行われた場合です。
想定されるアクターは除外してください。例えば、デプロイパイプラインロール、パッチ自動化ロール、AWS CloudFormation や AWS Systems Manager などの AWS サービスプリンシパルです。残るのは、プロセス外で行われた特権的な変更です。これは攻撃者がアクセスを永続化するために行う行動であると同時に、お客様自身の変更管理の規律に照らして起こるべきではない事象でもあります。
パイプラインは、平日の午後に毎日実行されるデプロイの中でセキュリティグループルールを開放することがあります。一方、週末の深夜に人がセキュリティグループルールを開放する場合は、同じ API コールでも意味がまったく異なります。両者を区別するのは、スケジュールとアクターという、どちらもお客様が定義する事実です。
最初の相関ルールを構築する
以下のウォークスルーでは、パターン 1 を例に、最初から最後までの実装手順を示します。他の 3 つのパターンも、それぞれのクエリを用いて同じ設計に従います。
前提条件
このウォークスルーのクエリに必要なデータを取得するには、以下の前提条件を満たす必要があります。開始する前に、それぞれを確認してください。
- 管理イベントを CloudWatch Logs ロググループに記録する CloudTrail 証跡があること
- 機密性の高い S3 バケットで CloudTrail データイベントが有効になっていること
- GuardDuty が有効で、保護プランと拡張脅威検出も有効になっていること
- VPC フローログが本番 VPC で有効になっていること
- Amazon Route 53 Resolver クエリログ記録が有効になっていること
CloudTrail、GuardDuty、VPC フローログ、Route 53 Resolver クエリログ記録は、相関分析で結び付ける生のシグナルを提供します。これらが有効になっていない場合、この記事のクエリは空の結果を返します。
ステップ 1: バケットと、その読み取りが想定されるプリンシパルを記録する
監視対象とする機密バケットを 1 つ選び、そのバケットの読み取りを許可されたプリンシパルを書き留めます。このリストは、バージョン管理された設定ファイルや Amazon DynamoDB テーブル (マネージド NoSQL データベース) など、自動化の仕組みからアクセスできる場所に保存してください。
この例では、わかりやすさを優先してリストをハードコードしています。本番環境では、再デプロイせずに更新できるように、DynamoDB テーブルや Parameter Store からリストを読み込んでください。
ステップ 2: しきい値を設定する前にベースラインを把握する
通常時の 1 週間分のアクティビティに対してパターン 1 のクエリを実行します。そのバケットの読み取り回数の 95 パーセンタイルを求め、それより大きい値をアラートのしきい値として使用します。このステップを踏むことで、正当な大量アクセスが後で誤検知を引き起こすのを防げます。
ステップ 5 で関数を設定する際に、この値を THRESHOLD_READS 環境変数に設定します。
ステップ 3: アクセスクエリを実行する
CloudWatch コンソールで、次の操作を行います。
- [ログ]、[ログのインサイト] の順に選択します。
- [ロググループの選択] ドロップダウンで、CloudTrail ロググループを選択します。
- 時間範囲を [3h] (過去 3 時間) に設定します。
- クエリエディタにパターン 1 のクエリを貼り付けます。
- your-sensitive-bucket をバケット名に置き換えます。
- [クエリの実行] を選択します。
- 結果テーブルに表示されたプリンシパルを確認します。
- 各プリンシパルを、ステップ 1 で記録した読み取りが想定されるプリンシパルのリストと照合し、リストに含まれていないものにフラグを付けます。
各結果にはプリンシパルが含まれています。ステップ 4 では、このプリンシパルを IP アドレスに変換します。
ステップ 4: ネットワークアクティビティと相関付ける
CloudTrail は AWS Identity and Access Management (IAM) プリンシパル単位でアクションを記録し、VPC フローログは IP アドレス単位でトラフィックを記録します。2 つのシグナルを結び付けるには、プリンシパルを対応する IP アドレスに変換します。
ロールが Amazon Elastic Compute Cloud (Amazon EC2) インスタンスにアタッチされている場合、userIdentity.principalId フィールドのコロンの後ろにインスタンス ID が含まれます。形式は AROAEXAMPLE:i-1234567890abcdef0 です。このインスタンス ID をコピーし、プライベート IP アドレスを調べます。
他のコンピューティングタイプでは方法が異なります。VPC に接続された AWS Lambda 関数は、サブネット内の Elastic Network Interface を経由してトラフィックを送信するため、それらのインターフェイスのアドレスで相関付けます。Amazon Elastic Container Service (Amazon ECS) タスクの場合、ネットワークインターフェイスはタスクメタデータに記録されます。インスタンスを伴わない通常のロール引き受けセッションの場合は、CloudTrail の sourceIPAddress フィールドに呼び出し元のアドレスが既に記録されているため、それを使って直接相関付けます。
パターン 1 のフローログのクエリを実行し、srcAddr をそのアドレスでフィルタリングして、Amazon S3 の読み取りタイムスタンプから 10 分以内の範囲に絞り込みます。一致する結果があれば、同じ時間枠内に、同じ送信元が機密データの読み取りと大量の外部転送の両方を行っていることになります。CloudTrail イベントが CloudWatch Logs に到達するのは API コールの 5~15 分後なので、クエリ時刻ではなく eventTime で相関付けてください。また、クエリのルックバック期間は相関付けの時間枠よりも広く取ります。例えば、30~60 分前までさかのぼってクエリを実行しつつ、相関付けは 10 分間の eventTime の時間枠で行います。ステップ 3 と 4 は手動による検証で、ステップ 5 でこれらを自動化します。
図 2 では、DNS の名前解決が 3 つ目の裏付けシグナルとして示されています。このウォークスルーで実装するのは、CloudTrail と VPC フローログの相関分析です。DNS を追加するには、同じ run_query() のパターンを Route 53 Resolver クエリログのロググループに適用してください。
ステップ 5: チェックを自動化する
クエリを Lambda 関数 (サーバーを管理せずにコードを実行できるサーバーレスコンピューティング) に移行し、結果を通知チャネルに送信して、定期的に実行されるようにスケジュールを設定します。以下のサブ手順を順に実行してください。
通知チャネルを作成するには
- Amazon Simple Notification Service (Amazon SNS) コンソールを開きます。Amazon SNS は、サブスクライバーに通知を配信するマネージドメッセージングサービスです。
- ナビゲーションペインで、[トピック] を選択します。
- [トピックの作成] を選択します。
- [タイプ] で [スタンダード] を選択します。
- [名前] に
security-correlation-alertsと入力します。 - [トピックの作成] を選択します。
- トピックの詳細ページの上部に表示されるトピックの Amazon リソースネーム (ARN) を書き留めておきます。この ARN は関数で使用します。
- [サブスクリプションの作成] を選択します。
- [プロトコル] で [E メール] を選択します。
- [エンドポイント] に、E メールアドレスまたはインシデント管理のエンドポイントを入力します。
- [サブスクリプションの作成] を選択し、AWS から届く E メールでサブスクリプションを確認します。
EventBridge Scheduler の実行ロールを作成するには
スケジュールには関数を呼び出すためのロールが必要です。また、そのロールの信頼ポリシーには、ロールの利用をお客様が所有するスケジュールに限定する条件が必要です。これらの条件がないと、スケジューラサービスにアクセスできる別のアカウントが、理論上このロールを呼び出せてしまいます。これは「混乱した代理問題」として知られる不正使用の一種です。
1. scheduler-trust-policy.json という名前の信頼ポリシーファイルを作成します。
2. ロールを作成し、関数を呼び出すためのアクセス許可をアタッチします。このロールで指定した関数以外を呼び出せないように、Resource は特定の関数 ARN に限定してください。
関数を作成すると、Lambda によって実行ロールが自動的に作成されます。この関数に必要なアクセス許可は、後の手順でそのロールにアタッチします。
相関関数をデプロイするには
- Lambda コンソールを開きます。
- [関数の作成] を選択します。
- [関数名] に
CorrelationFunctionと入力します。 - [ランタイム] で、最新の Python ランタイムを選択します。
- [関数の作成] を選択します。
- [コード] タブで、デフォルトのコードを次の関数に置き換え、[デプロイ] を選択します。
- [設定] タブで [一般設定] を選択し、[編集] を選択します。[タイムアウト] を 5 分 (300 秒) に設定します。CloudWatch Logs Insights のクエリは非同期で実行され、大規模なロググループでは 30~60 秒かかることがあります。[保存] を選択します。
- [設定] タブで [環境変数] を選択し、[編集] を選択して、
CLOUDTRAIL_LOG_GROUP、FLOWLOGS_LOG_GROUP、SNS_TOPIC_ARN、SENSITIVE_BUCKET、THRESHOLD_READSを追加します。 - [設定] タブで [アクセス権限] を選択し、実行ロールを開いて、次の最小権限のポリシーをアタッチします。
REGION、ACCOUNT-ID、およびロググループ名を実際の値に置き換えてください。ec2:DescribeInstances アクションはリソースレベルのアクセス許可をサポートしていないため、このステートメントには Resource: "*" が必要です。その他のステートメントは、特定の ARN に限定しています。
自動実行をスケジュールするには
Amazon EventBridge (イベントを使用してアプリケーションを接続するサーバーレスのイベントバス) は、スケジュールに従ってターゲットを実行できます。先ほど作成したロールを使用して、コマンドラインからスケジュールを作成します。
ステップ 6: エンリッチメント用のコンテキストを追加する (オプション)
エンリッチメントは独立したシグナルを追加することでトリアージの時間を短縮しますが、相関分析の動作に必須ではありません。なお、このステップではコストが発生します。地理位置情報プロバイダーに API コールの料金を支払う必要があるほか、Lambda の実行時間が延びる分、Lambda の料金も増加します。IP の地理位置情報を追加するには、地理位置情報 API にサインアップし、次の関数をコードに追加して、ハンドラーが IP を解決する箇所で呼び出します。
ハンドラーのループ内で ip を解決した後に、アラートに位置情報を追加します。
ステップ 7: 追加のパターンとアカウントへ拡張する
相関ルールのライブラリが大きくなってきたら、EventBridge、Lambda、AWS Step Functions (複数のサービスをワークフローとして連携させるサーバーレスのオーケストレーションサービス) を使用してロジックを自動化されたパイプラインに移行し、相関分析の結果を Security Hub の検出結果と並べて表示します。大規模なサービス横断の相関分析には、CloudWatch の統合データおよびテレメトリ機能を活用できます。この機能では、セキュリティとコンプライアンスのデータを OCSF 形式に変換し、CloudTrail、VPC フローログ、DNS ログなどのソースを 1 つのインターフェイスからクエリできます。長期的な分析には、Security Lake と Athena の組み合わせが有力な選択肢です。保持期間とクエリの要件に合ったクエリ基盤を選択してください。
図 3 は、EventBridge、Lambda、Step Functions、AWS Security Hub などの AWS サービスで構築した相関分析パイプラインを示しています。このパイプラインでは、データソースからスケジュールされたクエリとエンリッチメントを経て、自動対応と一元的な可視性の確保へとつながります。
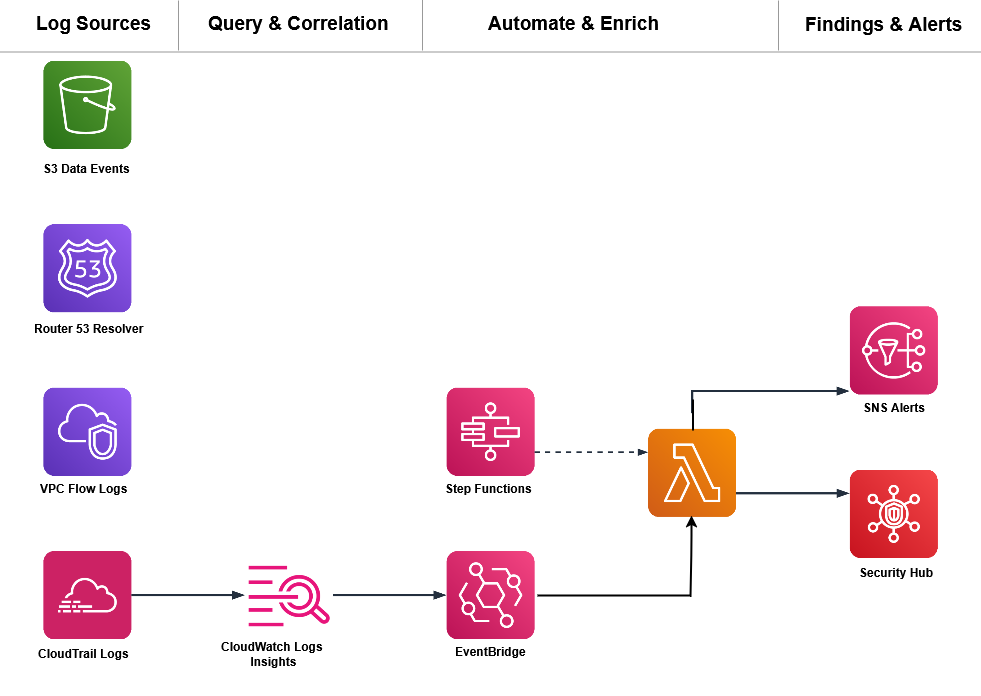
図 3: AWS サービスで構築した相関分析パイプライン
まとめ
この記事では、GuardDuty 拡張脅威検出にビジネスコンテキストを重ね合わせ、お客様の環境に固有の攻撃をとらえる 4 つの相関分析パターンを紹介しました。どの相関分析を構築する場合にも共通する原則がいくつかあります。
- アイデンティティが主要な相関キー: 同じプリンシパルを複数のサービスにわたって追跡します。
- 時間枠が重要 (ただし、攻撃の種類によって異なる): 自動化された高速なシーケンスでは、数分以内に発生したイベントは通常関連しています。この記事で使用した 10 分間のビンは、そのようなパターンに適しています。一方、時間をかけて行われる偵察や手動の偵察は数時間から数日にわたることがあるため、自動化されたパターンとは異なり、じっくりと進められるパターンの場合は、時間枠を広げてください。
- コンテキストはお客様が追加するもの: データ分類、通常のアクセスパターン、リソースの所有関係、変更ウィンドウは、お客様が検出に加えるシグナルです。
- 1 つのルールから始める: 適切にチューニングされた 1 つの相関分析のほうが、相関付けられていない大量のアラートよりも、重要なアクティビティを的確にとらえられます。
GuardDuty 拡張脅威検出は、多くのお客様に共通する多段階のパターンに対処します。この記事の相関分析は、お客様のビジネスコンテキストでしか提供できないレイヤーを追加するものです。今週まず 1 つのパターンから始めてお客様自身のトラフィックで検証し、信頼性を確認できたら次のパターンを追加してください。
参考資料
- Amazon GuardDuty 拡張脅威検出 – GuardDuty が多段階攻撃のパターンを自動的に相関付ける仕組み
- CloudWatch Logs Insights のクエリ構文 – この記事で使用しているクエリ言語のリファレンス
- AWS CloudTrail によるデータイベントのログ記録 – パターンが依存する Amazon S3 データイベントを有効にする
- CloudWatch Logs への CloudTrail イベントの送信 – クエリ可能なロググループに証跡を配信する
- 組織の証跡の作成 – AWS Organizations 内のすべてのアカウントのイベントを単一のロググループに配信する
- VPC フローログ – ネットワークトラフィックのシグナルに関するフィールドリファレンス
- Amazon Route 53 Resolver クエリログ記録 – 裏付けに使用する DNS シグナルをキャプチャする
- MITRE ATT&CK – 攻撃の戦術と手法に関する業界フレームワーク
- Open Cybersecurity Schema Framework (OCSF) – Security Lake が使用するスキーマ
本ブログは Security Solutions Architect の 中島 章博 が翻訳しました。