O blog da AWS
Arquitetura de referência do eproc na AWS
Por Allyson Oliveira e Carlos Moraes é arquitetos de soluções da AWS no time de Setor Público.
Neste post, apresentamos uma arquitetura de referência para o eproc. A aplicação roda no Amazon Elastic Compute Cloud (Amazon EC2), o banco no Amazon Aurora MySQL-Compatible Edition e os documentos em serviços de armazenamento. Os serviços gerenciados transferem à AWS a replicação do banco, os patches da infraestrutura gerenciada e a substituição de nós com falha.
O que é o eproc
O eproc é um sistema de Processo Judicial Eletrônico usado para a tramitação digital de processos judiciais. Ele automatiza o fluxo processual desde o protocolo até a decisão final.
Desenvolvido pela Justiça Federal da 4ª Região, o sistema começou a ser utilizado em 2003 e reúne mais de duas décadas de evolução. Sua adoção por outros tribunais ampliou o uso da plataforma para diferentes contextos do Judiciário brasileiro.
A operação envolve peticionamento eletrônico, consulta aos autos, gestão de prazos e comunicação entre as partes. São atividades que exigem uma infraestrutura capaz de acompanhar o crescimento do acervo e a variação no volume de acessos.
Uma experiência do Judiciário brasileiro
O Tribunal de Justiça do Rio Grande do Sul (TJRS) apresentou no AWS re:Invent 2024 a migração do eproc para a AWS durante as enchentes daquele ano [1]. O ambiente descrito na sessão incluía um banco MySQL de 10 TB, 388 milhões de documentos, que ocupavam 184 TB, e mais de 100 servidores. A apresentação relata uma migração de três semanas com o Amazon Aurora, o AWS Database Migration Service (AWS DMS) e o AWS DataSync.
Como os componentes se conectam
A referência mantém os dados judiciais, incluindo backups, na região AWS América do Sul (São Paulo), sa-east-1. A escolha considera a Lei Geral de Proteção de Dados Pessoais (LGPD) e as resoluções do Conselho Nacional de Justiça (CNJ).
O Amazon Route 53 resolve o nome do serviço para um Application Load Balancer (ALB). As requisições HTTPS chegam ao ALB, que usa certificados do AWS Certificate Manager (ACM). O ALB está associado a uma lista de controle de acesso da web (web ACL) do AWS WAF. Em seguida, as requisições seguem para as instâncias do Amazon EC2 da aplicação [2]. O balanceador usa sub-redes públicas em três Zonas de Disponibilidade (AZs), enquanto aplicação, cache e banco ficam em sub-redes privadas.
As instâncias acessam o Amazon Aurora para os dados transacionais e o Amazon ElastiCache para as funções de cache e sessão homologadas no ambiente. O Amazon Simple Storage Service (Amazon S3) armazena os documentos como objetos. O Amazon Elastic File System (Amazon EFS) atende aos componentes que precisam de arquivos compartilhados por Network File System (NFS).
O acesso ao Amazon S3 a partir das sub-redes privadas usa um gateway VPC endpoint da Amazon Virtual Private Cloud (Amazon VPC) [3]. Assim, o tráfego fica na rede da AWS, sem cobrança de processamento de NAT. As demais saídas, como atualizações de pacotes, passam por um NAT gateway em cada AZ. O acesso a outras APIs da AWS pode usar interface VPC endpoints.
A Figura 1 apresenta a organização desses componentes e a distribuição da aplicação e do banco de dados entre Zonas de Disponibilidade.
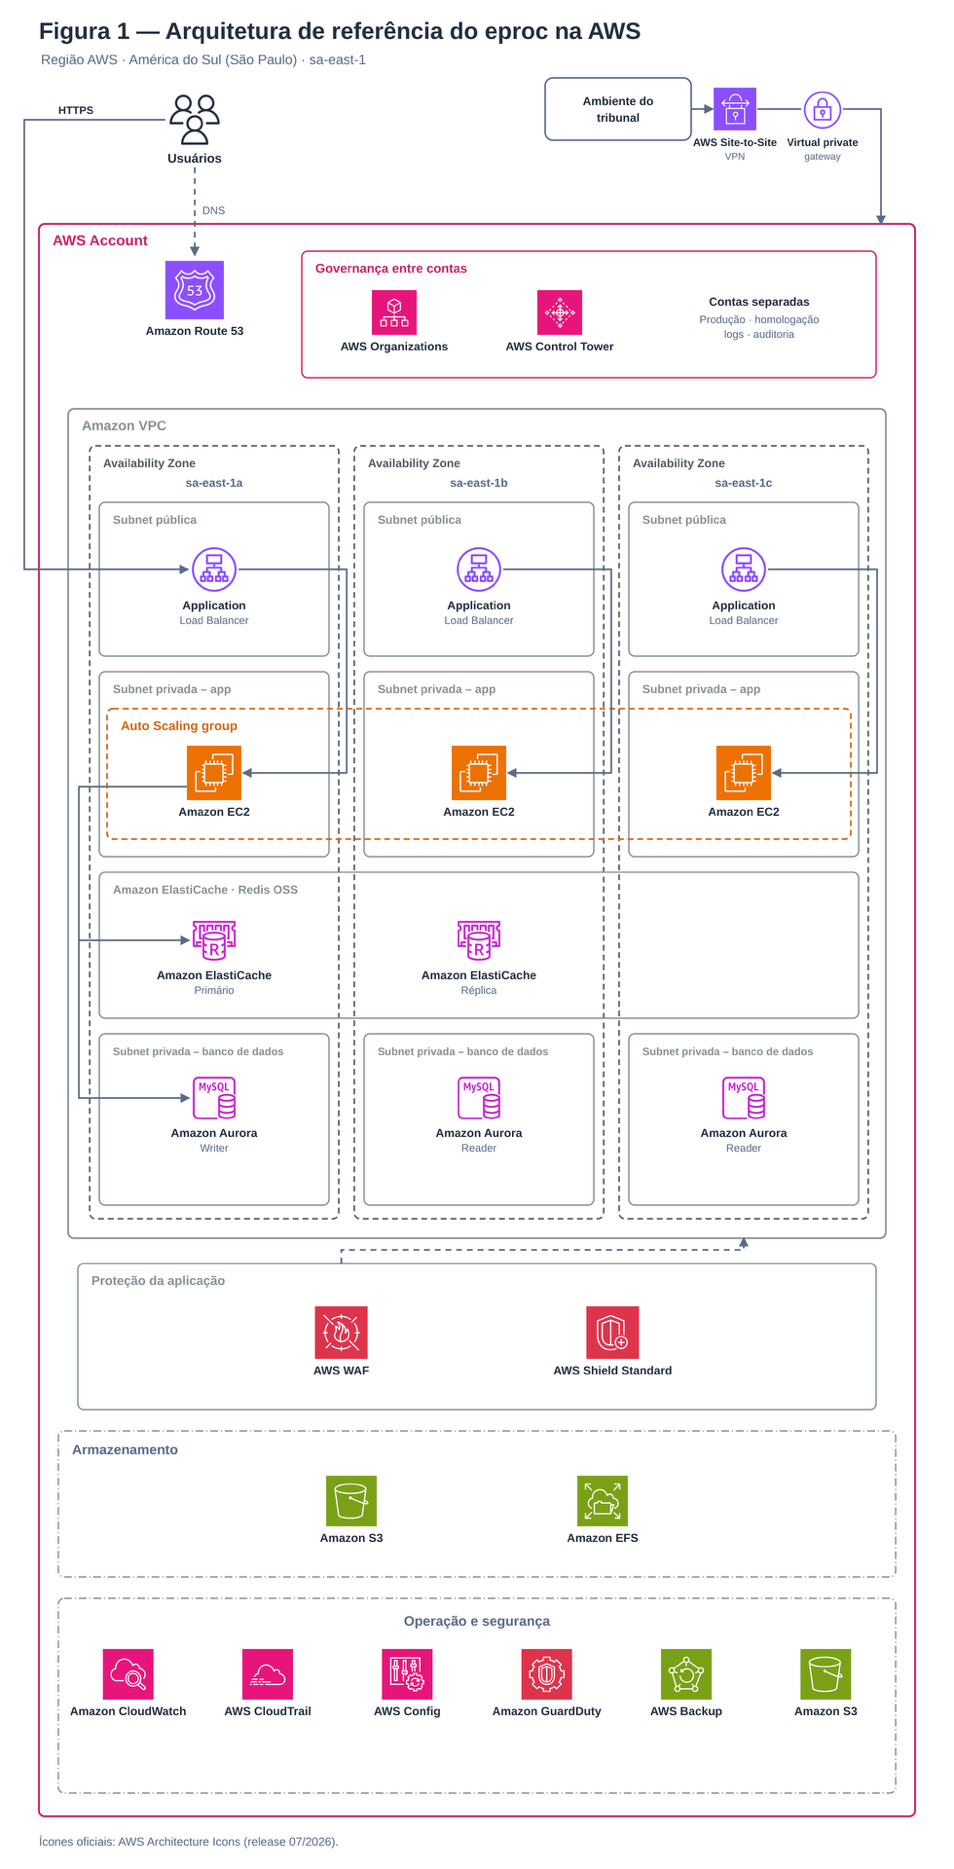
Figura 1. Arquitetura de referência do eproc na AWS na região São Paulo (sa-east-1).
Amazon Aurora na camada transacional
O Amazon Aurora assume a administração da infraestrutura do banco, incluindo o armazenamento distribuído e sua replicação [4]. A equipe do tribunal deixa de operar replicação e volumes de disco e concentra a atuação nas consultas, no dimensionamento e no comportamento da aplicação.
A arquitetura do Amazon Aurora separa computação e armazenamento. Gravador e leitores compartilham um volume que mantém seis cópias dos dados em três AZs, independentemente do número de instâncias [5]. Ao adicionar um leitor, o serviço o conecta ao volume existente, sem criar outra cópia completa do banco.
Essa separação também participa da recuperação após falhas. Nesta referência, o cluster usa um gravador e dois leitores, cada um em uma AZ. Se o gravador falhar, o Amazon Aurora promove automaticamente um leitor, e a documentação indica que o serviço normalmente é restabelecido em menos de 60 segundos, muitas vezes em menos de 30 segundos [6]. Esse tempo deve ser medido nos testes do tribunal. Como os dados já estão no armazenamento distribuído, a recuperação não depende de restaurar um backup completo.
A aplicação usa o endpoint do cluster, que aponta para o gravador atual. O endereço continua o mesmo após a promoção de um leitor. A troca, porém, depende da atualização do DNS, e aplicações PHP com conexões persistentes podem demorar a reconectar. O proxy do Amazon Relational Database Service (Amazon RDS), o Amazon RDS Proxy, mantém um pool de conexões e reduz esse tempo [3]. Outra opção é usar um tempo de vida (TTL) de DNS baixo no cliente, com lógica de nova tentativa na aplicação.
Os leitores também atendem consultas. O Amazon Aurora oferece até 15 réplicas de leitura, acessíveis pelo endpoint de leitura do cluster. Se o eproc permitir separar leituras e escritas, esse recurso amplia a capacidade de consulta, considerando o atraso de replicação.
A compatibilidade com MySQL mantém drivers e ferramentas conhecidos pela equipe [7]. A homologação confirma a versão do mecanismo frente às consultas, permissões e integrações do eproc.
Disponibilidade e capacidade da aplicação
A camada de aplicação usa um grupo do Amazon EC2 Auto Scaling distribuído entre três AZs [8]. Como ponto de partida, uma capacidade mínima de três instâncias, uma por AZ, mantém duas instâncias atendendo se uma zona falhar, enquanto o grupo repõe a capacidade nas demais. Esse valor deve ser validado nos testes de carga de cada tribunal.
O ALB verifica a integridade dos destinos e encaminha o tráfego às instâncias saudáveis. Com as verificações do balanceador habilitadas no grupo, o Amazon EC2 Auto Scaling substitui instâncias com falha sem intervenção manual.
As políticas de escala adicionam ou removem instâncias conforme a utilização de CPU ou as requisições por destino. Os testes de carga devem reproduzir consultas aos autos, envio de documentos e integrações para definir limites e capacidade mínima com margem para picos e falhas.
A substituição de instâncias depende de uma imagem de implantação com as versões homologadas da aplicação e suas dependências. Sessões e arquivos necessários ao atendimento devem continuar acessíveis após a troca de um servidor. A administração do sistema operacional, do PHP e do servidor web continua sob responsabilidade da equipe que administra essa camada.
Cache e armazenamento de documentos
O Amazon ElastiCache pode atender às funções de cache ou sessão já usadas com Redis, conforme a configuração homologada do eproc [9]. O serviço substitui nós com falha e aplica atualizações de software em janelas de manutenção definidas pela equipe.
Nesta referência, o cluster usa um nó primário e uma réplica em outra AZ, com Multi-AZ e failover automático habilitados. Em caso de falha do nó primário, o serviço promove a réplica, e a aplicação precisa lidar com a troca de conexão e com a eventual perda de dados ainda não replicados. Além do Redis Open Source Software (Redis OSS), o Amazon ElastiCache oferece o Valkey, mecanismo compatível com Redis OSS que vale avaliar na homologação, inclusive pelo custo.
Para os documentos armazenados como objetos, o Amazon S3 permite ampliar o acervo sem administrar servidores de arquivos ou provisionar volumes [10]. Versionamento e políticas de ciclo de vida protegem versões dos objetos e organizam o armazenamento conforme os requisitos de retenção e acesso.
Os buckets permanecem sem acesso público. A aplicação recebe permissões para os recursos necessários, e o acesso aos documentos continua sujeito às regras do eproc.
O Amazon EFS atende aos componentes que precisam de um sistema de arquivos compartilhado [11]. Sua capacidade acompanha a inclusão e a remoção de arquivos, sem provisionamento prévio de um volume fixo. A opção Regional mantém os dados de forma redundante entre AZs e permite que diferentes instâncias do Amazon EC2 acessem o mesmo sistema de arquivos.
Segurança e governança entre contas
Conforme o Modelo de Responsabilidade Compartilhada da AWS, a AWS protege a infraestrutura que executa os serviços da nuvem. O tribunal configura os controles sob sua responsabilidade, como regras do AWS WAF, permissões de acesso, criptografia e controles de rede.
O AWS WAF inspeciona as requisições que chegam ao ALB e aplica regras para padrões de tráfego malicioso ou indesejado e controle de taxa [12]. As regras ficam centralizadas no ponto de entrada da aplicação, sem configuração em cada servidor. O AWS Shield Standard complementa a proteção contra eventos de negação de serviço distribuída (DDoS).
As regras do AWS WAF devem considerar os fluxos legítimos do eproc, incluindo uploads e operações com grande volume de parâmetros. Os controles de rede restringem as conexões entre as camadas aos caminhos necessários para a aplicação.
No AWS Identity and Access Management (IAM), funções e políticas definem as permissões dos componentes [13]. A criptografia em repouso usa a integração dos serviços com o AWS Key Management Service (AWS KMS), que separa o controle de acesso às chaves das permissões sobre os dados. As conexões usam criptografia em trânsito.
As credenciais do Amazon Aurora e do Amazon ElastiCache não ficam em arquivos nem na imagem de implantação. Elas ficam no AWS Secrets Manager, com rotação automática [3], e a aplicação PHP as obtém em tempo de execução pela função do IAM das instâncias.
O Amazon GuardDuty analisa fontes de dados e gera descobertas de possíveis ameaças [14]. A análise das descobertas e a detecção dentro do eproc continuam com o tribunal. Integrações com o Amazon EventBridge encaminham as descobertas e acionam as respostas previstas nos procedimentos do tribunal.
A governança usa AWS Organizations e AWS Control Tower [15]. Produção e homologação ficam em contas distintas, com contas dedicadas a auditoria e centralização de registros, e o AWS Control Tower cria novas contas já com configurações e controles padronizados.
Visibilidade sobre a operação
O Amazon CloudWatch reúne métricas, logs e alarmes para acompanhar o ambiente [16]. A equipe pode observar o tempo de resposta, os erros do balanceador, a utilização das instâncias e o comportamento das conexões com o banco. Essa visibilidade ajuda a identificar qual camada precisa de ajuste e a acompanhar o resultado de uma mudança.
O AWS CloudTrail registra chamadas de API conforme a configuração de auditoria, e o AWS Config registra configurações dos recursos compatíveis e avalia regras de conformidade [17]. Esses serviços ajudam a reconstruir alterações no ambiente e a identificar desvios das configurações estabelecidas.
Para registrar operações sobre objetos do Amazon S3, é necessário habilitar os eventos de dados correspondentes no AWS CloudTrail, pois eles não são incluídos por padrão nas trilhas. A auditoria dos atos praticados dentro do eproc continua sendo feita pela própria aplicação.
Backup e recuperação do serviço
O Amazon Aurora realiza backups contínuos e permite recuperar o banco para um ponto no tempo dentro do período de retenção, configurável de 1 a 35 dias [18]. Esse recurso cobre alterações indevidas nos dados, situação que os mecanismos de disponibilidade não resolvem.
O AWS Backup centraliza planos e retenções para clusters do Amazon Aurora, sistemas de arquivos do Amazon EFS e buckets do Amazon S3. Para o Amazon S3, o serviço exige versionamento habilitado nos buckets protegidos. A equipe acompanha a execução dos backups em um único console e aplica políticas a grupos de recursos por tags.
No eproc, a recuperação precisa preservar a relação entre os registros do banco e os documentos processuais. Os testes devem verificar se os documentos apontados nos autos podem ser recuperados e abertos após a restauração. A recuperação de cada serviço, isoladamente, não confirma a consistência da aplicação.
O tribunal define o objetivo de ponto de recuperação (RPO), a perda de dados aceitável, e o objetivo de tempo de recuperação (RTO), o tempo para retomar o serviço. Ambos são medidos com a restauração dos dados e a validação do eproc.
A distribuição entre AZs trata falhas dentro da região. Para indisponibilidade regional, existem o Amazon Aurora Global Database, a replicação entre regiões do Amazon S3 e as cópias entre regiões do AWS Backup. Uma cópia fora do Brasil leva dados judiciais para outro país, decisão a avaliar frente à LGPD e às normas do CNJ.
Integração e migração
As integrações que continuam no datacenter do tribunal podem usar o AWS Site-to-Site VPN. Cada conexão oferece dois túneis Internet Protocol Security (IPsec), o que permite planejar redundância, e ambos precisam ser configurados e testados com os equipamentos e enlaces do tribunal [19].
Para o acervo, a banda da VPN é limitada por túnel. A 1 Gbps contínuo, 184 TB levam cerca de 17 dias. O AWS DirectConnect oferece banda dedicada e previsível quando o prazo é curto ou a operação continua híbrida [3]. Desde 7 de novembro de 2025, os dispositivos AWS Snowball Edge estão disponíveis apenas para clientes existentes, e a AWS encerra o suporte a eles em 31 de dezembro de 2026 em todas as Regiões comerciais. Para transferência física, a AWS indica o AWS Data Transfer Terminal, conforme a disponibilidade de locais.
Para o banco, o AWS DMS faz a carga inicial e a replicação contínua de alterações, conforme a compatibilidade dos endpoints. Assim, a carga principal é transferida antes da mudança definitiva de ambiente, e a sincronização final fica restrita às alterações recentes.
Para arquivos e objetos, o AWS DataSync automatiza transferências entre sistemas de armazenamento compatíveis e valida a integridade dos dados copiados. AWS DMS e AWS DataSync também foram usados na migração do TJRS [1].
A entrada em produção ocorre após a validação dos dados e das integrações, com critérios definidos para retorno ao ambiente anterior. A aplicação pode seguir em máquinas virtuais enquanto as camadas de dados passam a serviços gerenciados.
Conclusão
A arquitetura usa os serviços da AWS para assumir replicação, administração do armazenamento e recuperação da infraestrutura. Com o Amazon Aurora, a equipe opera um banco compatível com MySQL apoiado por armazenamento distribuído. Na aplicação, o ALB e o Amazon EC2 Auto Scaling retiram destinos com falha, substituem instâncias e ajustam a capacidade.
O próximo passo é validar o desenho com a versão do sistema, o perfil de acessos e os objetivos de recuperação do tribunal. O AWS Well-Architected Framework serve como roteiro [20]. Testes de carga, failover e restauração definem a configuração de produção. Para começar, o tribunal pode fazer essa revisão na AWS Well-Architected Tool, com apoio do time de conta da AWS ou de um parceiro AWS.
Referências
As fontes estão numeradas conforme as citações entre colchetes no texto.
[1] TJRS no AWS re:Invent 2024
Apresentação pública sobre a migração do TJRS em três semanas
[2] Application Load Balancer
Componentes, distribuição de tráfego e verificações de integridade
[3] Rede, conectividade e credenciais
Gateway VPC endpoints para o Amazon S3
Certificados do AWS Certificate Manager no ALB
Rotação de credenciais no AWS Secrets Manager
Proxy do Amazon Relational Database Service (Amazon RDS) com Amazon Aurora
Conexões dedicadas entre o datacenter e a AWS
[4] Amazon Aurora
Visão geral e compatibilidade com MySQL e PostgreSQL
[5] Armazenamento do Amazon Aurora
Volume compartilhado e replicação entre três AZs
[6] Alta disponibilidade do Amazon Aurora
Réplicas, endpoints e recuperação após falhas
[7] Migração e compatibilidade do Amazon Aurora MySQL
Considerações para a migração
Diferenças entre Aurora MySQL versão 3 e MySQL 8.0
[8] Amazon EC2 Auto Scaling
Benefícios e distribuição entre Zonas de Disponibilidade
Políticas de escala por métricas de CPU e requisições
Verificações de integridade no grupo Auto Scaling
[9] Amazon ElastiCache
Distribuição entre AZs e failover com Redis OSS e Valkey
[10] Amazon S3
Armazenamento de objetos e recursos de proteção
[11] Amazon EFS
Sistemas de arquivos, NFS e armazenamento Regional
[12] Proteção do tráfego
AWS WAF e inspeção de requisições
AWS Shield Standard
[13] Identidade e criptografia
Boas práticas do AWS Identity and Access Management (IAM)
AWS Key Management Service
[14] Amazon GuardDuty
Detecção de ameaças e integração com outros serviços
[15] AWS Control Tower
Landing zone, controles e governança com AWS Organizations
[16] Amazon CloudWatch
[17] Auditoria e configuração
Eventos de dados no AWS CloudTrail
AWS Config e avaliação de recursos
[18] Backup e recuperação
Políticas e recursos do AWS Backup
Backups e recuperação para um ponto no tempo no Aurora
[19] Conectividade e transferência de dados
Conexões VPN entre o datacenter e a AWS
AWS Database Migration Service
AWS DataSync
[20] Boas práticas arquiteturais da AWS
Framework para revisão de decisões arquiteturais
Planejamento de recuperação de desastres e objetivos de recuperação
Sobre os autores
 |
Allyson Oliveira é arquiteto de soluções da AWS no time de Setor Público, apoiando tribunais e órgãos do Judiciário em suas jornadas de modernização. Atua com arquitetura de dados moderna e inteligência artificial agêntica aplicadas ao setor público. |
 |
Carlos Moraes é arquiteto de soluções da AWS no time de Setor Público. Já liderou diversos projetos de infraestrutura, migração e modernização de aplicações em ambientes on-premises e em nuvem, com foco em arquiteturas resilientes, escaláveis e otimizadas em custo. |