Amazon Web Services ブログ
株式会社コーテッグ様の「聞くだけ」で分析が完結する AI 分析基盤「Dotta」を Amazon Bedrock AgentCore で実現
本記事は、株式会社コーテッグ様と Amazon Web Services Japan による共同執筆です。
みなさん、こんにちは。アマゾンウェブサービスジャパンの古山です。
生成 AI の活用は、チャットボットによる応答から、自律的にタスクを進める「AI エージェント」の実用化へとステージが移りつつあります。本記事では、Amazon Bedrock AgentCore を中核とした非同期 AI エージェント基盤により、自然言語で問いかけるだけでデータの分析・可視化・レポート生成までを完結させる AI 分析プラットフォーム「Dotta(ドッタ)」を構築された、株式会社コーテッグ様の事例をご紹介します。
コーテッグ様について
株式会社コーテッグ様(以下、コーテッグ様)は、AI とクラウド技術を軸に、サービスの企画・開発・運営を行うエンジニアリングカンパニーです。生成 AI・機械学習を活用したシステム開発とデータ活用支援、Web・モバイルアプリケーション開発、要件定義から運用保守までのフルサイクル開発、技術コンサルティングを手がけられるとともに、自社プロダクトとして、本記事でご紹介する AI データ分析プラットフォーム「Dotta」と、医療機関向けの AI 予約・受付システム「ソトマチ」を提供されています。
コーテッグ様は以前より AWS 上で生成 AI の活用を進められており、2024 年 11 月には、Amazon Bedrock のマルチモーダルモデルを活用した「診察券の自動読み取り機能」により、導入医療機関全体で月間 7,500 時間の業務削減を実現されました(詳細は既存の事例ブログ「生成 AI-OCR 機能で診察券読取業務を効率化、月間 7,500 時間の削減に成功」をご覧ください)。
この成功体験を通じて、同社は生成 AI が単なる文字認識や文章生成にとどまらず、業務プロセスそのものを変革する力を持つことを確信されました。その次の挑戦として取り組まれたのが、”自律的に分析を進める AI エージェント” による分析プラットフォーム「Dotta」です。
提供の背景
データが意思決定を左右する時代になりました。しかし多くの企業では、データ分析はいまも一部の専門人材に依存する “属人的な作業” にとどまっています。コーテッグ様は、クライアントとの対話を通じて、現場に共通する次のような課題があると考えました。
- 分析を依頼してから結果が出るまで時間がかかり、意思決定のスピードが上がらない
- SQL やデータ基盤を扱える一部のエンジニアに依存し、依頼と待ち時間が慢性化している
- BI ツールを導入したものの、設定や操作が難しく現場に定着しない
- 週次・月次の定期レポート作成に、毎回まとまった工数が奪われる
生成 AI の進化は、こうした課題の解き方を大きく変えつつあります。人手不足が続くなかでも少人数で成果を出すために、同社は “チャットボット” の先にある「自律的に分析を進める AI エージェント」に着目しました。
「すべての人に、AI で分析力を。」——このコンセプトのもと、コーテッグは専門知識の有無を問わず誰もが自然言語で分析を完結できる仕組みとして「Dotta」を開発しました。
Amazon Bedrock を活用したサービスの概要
「Dotta」は「聞くだけで分析完了」をコンセプトに、分析の専門知識がなくても “問いかけるだけ” で結果にたどり着ける体験を提供します。主要機能は次の 4 つです。
- 自然言語クエリ:「先月の売上を地域別に見せて」といった問いかけだけで、データの取得・集計を実行します。
- AI ビジュアライゼーション:データの内容に応じて最適なグラフ・チャートを AI が自動で選定し可視化します。
- 自動レポート生成:分析結果を PDF・Markdown・Word 形式で出力します。
- マルチデータソース連携:CSV ファイルや MySQL・PostgreSQL などの各種データベース、Amazon Redshift をはじめとするクラウドデータウェアハウスなど、多様なデータソースに対応します。
対象はマーケティング・営業・プロダクト・経営企画など幅広い職種で、広告効果分析(チャネル別 ROAS・CPA 分析)、営業パイプライン管理、ユーザー行動分析、経営ダッシュボードの作成といった用途が想定されています。これらの分析を、Amazon Bedrock 上で動作する AI エージェントが自律的に進めることで実現しています。
AWS サービスの採用理由
コーテッグ様が「Dotta」の基盤に AWS を選んだ理由は、大きく 3 つあります。
1 つ目は、Amazon Bedrock の本番運用実績と信頼です。前述の「診察券の自動読み取り機能」を通じて、Amazon Bedrock を本番環境で運用してきた実績があり、その品質・安定性への信頼が既にありました。また、Amazon Bedrock への入出力データがモデルの学習に利用されない点は、顧客の業務データを扱う分析プラットフォームにとって必須の要件でした。
2 つ目は、Amazon Bedrock AgentCore による AI エージェント特有の要件への対応です。数分に及ぶ長時間実行、セッションごとの分離された実行環境といった、AI エージェントならではの実行要件をマネージドサービスとして満たせることが、採用の決め手となりました。
3 つ目は、少人数でも運用できるサーバーレス・マネージドサービス群です。Amazon SQS、AWS Lambda、Amazon DynamoDB などを組み合わせることで、インフラ管理の負担を最小限に抑えながら、スケーラブルな非同期処理基盤を実現できると判断しました。ソトマチで培った AWS の知見をそのまま活かせることも、開発スピードの面で大きな利点でした。
主要機能と独自性の高い技術的特徴
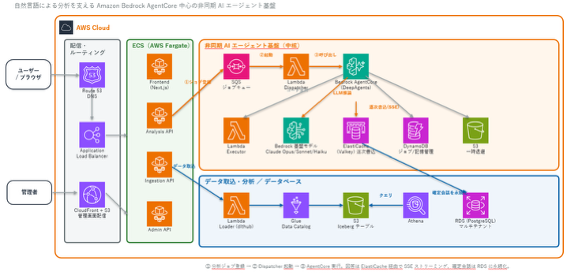
「聞くだけ」という体験の裏側では、AI エージェントが自律的に考え、必要なコードを書き、データを集計しています。これを支えるのが、Amazon Bedrock AgentCore を用いた非同期 AI エージェント基盤です。分析処理は数十秒から数分に及ぶことがあるため、ユーザーの操作をブロックしない非同期ジョブとして設計されています。
フロントエンド / API 層
利用者向け画面(Next.js によるフロントエンド)と、分析を担う「Analysis API」、データ取込を担う「Ingestion API」、認証・組織管理を担う「Admin API」は、いずれも Amazon ECS(AWS Fargate)上で稼働しています。アクセスは Amazon Route 53 でドメインを管理し、Application Load Balancer でアクセス先を振り分けます。管理者向けの管理画面は Amazon CloudFront と Amazon S3 で配信されています。
非同期 AI エージェント基盤(中核)
自然言語の問いかけを受け取ってから回答を返すまでの流れは、次のように構成されています。
- ジョブ登録:Analysis API がユーザーのメッセージを Amazon SQS にジョブとして登録します。
- 自動起動・呼び出し:SQS をトリガーに AWS Lambda(Dispatcher)が起動し、Amazon Bedrock AgentCore Runtime を呼び出します。
- エージェントによる分析:AgentCore Runtime 上で DeepAgents(LangChain)による分析エージェントが動作します。推論には Amazon Bedrock の基盤モデルを用い、分析には Claude Opus 4.8 / Sonnet 4.6、軽量な処理には Claude Haiku 4.5 と、用途に応じてモデルを使い分けています。
- コード実行:分析に必要なコードの実行は AWS Lambda(Executor)が担います。
- 回答のストリーミング:エージェントが生成した回答は Amazon ElastiCache(Valkey)に逐次書き込まれ、Analysis API がそれを読み取って SSE(Server-Sent Events)でブラウザへリアルタイムに流します。読了後は TTL により自動削除される一時領域として扱われます。
- 会話の永続化:確定した会話は Amazon RDS(PostgreSQL)に永続化されます。これにより、ストリーミング中(未確定)の会話は ElastiCache から、確定済みの過去会話は RDS から取得し、途切れのないチャット履歴の表示・再生を実現しています。
ジョブの進行状況、二重実行を防ぐためのロック、エージェントの生存確認(heartbeat)、そしてエージェントの記憶管理(DeepAgents の checkpointer)は Amazon DynamoDB で管理されます。処理途中の大きな一時データは Amazon S3 に退避して受け渡します。
ユーザー操作による一時停止・再開にも対応しており、キャンセル要求を受け取ると安全に中断して checkpoint とそこまでのメッセージを保存し、後から途中再開できます(Human-in-the-Loop の入力待ちも同様の仕組みで扱われます)。
データ取込・分析基盤
分析対象のデータは、Ingestion API から AWS Lambda(Loader、dlthub を利用)でデータを変換・登録し、AWS Glue Data Catalog と Amazon S3 上の Apache Iceberg テーブルに蓄積されます。蓄積したデータへのクエリには Amazon Athena が用いられています。サービス本体のデータは Amazon RDS(PostgreSQL)でマルチテナント構成として管理されています。
開発段階での苦労と、工夫したポイント
長時間実行される分析処理を UI をブロックせずに扱うことが、同社にとって大きな課題でした。Amazon SQS・AWS Lambda・Amazon Bedrock AgentCore を組み合わせた非同期ジョブとして設計することで、ユーザーは待ち時間中も操作を続けられ、処理の進行はストリーミングで確認できるようになっています。
また、ストリーミング中(未確定)の会話と確定済みの会話を、それぞれ Amazon ElastiCache と Amazon RDS という異なる保存先から取得しつつ、利用者からは 1 つの連続した会話として見えるように繋ぎ込む点にも工夫を要したといいます。
加えて、Amazon DynamoDB による二重実行ロック・heartbeat での生存監視・checkpointer による記憶管理を組み合わせることで、処理の途中停止と再開、そして信頼性を両立させています。
Well-Architected Framework に基づく設計
オペレーショナルエクセレンス
各ノードの状態を Amazon CloudWatch で監視するとともに、ジョブの進行状況やエージェントの heartbeat を Amazon DynamoDB に記録することで、非同期処理の可観測性を確保しています。これにより、長時間ジョブの停滞や異常を早期に検知できる運用フローが整えられています。
セキュリティ
永続化データ(Amazon RDS、Amazon S3)を暗号化し、機密性の高いデータを保護しています。AWS IAM による最小権限のアクセス制御を行い、マルチテナント環境ではテナント間のデータ分離を徹底しています。また、VPC 内のプライベートネットワークで内部通信を完結させ、外部への通信は NAT Gateway を経由させることで、安全な通信経路を確保しています。
信頼性
非同期ジョブは Amazon DynamoDB による二重実行ロックで重複起動を防ぎ、checkpoint による中断・再開に対応しています。SQS・Lambda・AgentCore などマネージドサービスを中心に構成することで、スケールと可用性を確保しています。
パフォーマンス効率
分析には高性能なモデル、軽量な処理には Claude Haiku 4.5 と、用途に応じて基盤モデルを使い分けることで応答性とコストのバランスを取っています。回答のストリーミングには Amazon ElastiCache(Valkey)を用いて低遅延を実現し、大量データのクエリには Apache Iceberg と Amazon Athena によるスケーラブルな分析基盤を採用しています。
コスト最適化
サーバーレス・マネージドサービスを中心に構成することで、利用量に応じたコストとしています。基盤モデルの適材適所での使い分けや、一時データを TTL で自動削除する仕組みにより、無駄なリソース消費を抑えています。
ビジネスインパクトと今後の展望
想定される効果(試算)
「Dotta」がもたらす効果は、何より “時間” として表れます。ここでは、1 名あたり 1 週間に 5 件の分析業務が発生するクライアントの事例をもとに、コーテッグ様による導入効果の試算を紹介します。
前提条件
- 1 件の分析業務(データ抽出 → 集計 → 可視化 → レポート化)に、従来は 1 名あたり平均 240 分を要していると仮定
- 「Dotta」では自然言語で問いかけることで、同じ分析を平均 10 分程度で完了できると想定
試算
- 1 件あたりの削減時間 = 240 分 − 10 分 = 230 分
- 1 名あたり週の削減時間 = 230 分 × 5 件 = 1,150 分(約 19.2 時間)
- 10 名のチームで月(4 週)換算すると、約 19.2 時間 × 10 名 × 4 週 = 月あたり約 768 時間の削減
※上記はあくまで前提条件を置いた試算であり、実際の効果はデータ量・分析内容・利用状況により変動します。
今後の展望
コーテッグ様は今後、以下の機能拡充を進めていく予定です。
-
- データソース登録の AI エージェント化
- 対応データソースのさらなる拡充
- 可視化・レポート表現の高度化
「すべての人に、AI で分析力を。」——専門知識の有無にかかわらず、誰もがデータにもとづいて “その場で” 意思決定できる世界の実現に向けて、コーテッグ様の挑戦は続きます。
まとめ
本記事では、Amazon Bedrock AgentCore を中核とした非同期 AI エージェント基盤により、「聞くだけ」で分析が完結するプラットフォーム「Dotta」を実現した、コーテッグ様の事例を紹介しました。生成 AI-OCR による業務効率化(前回の事例)から、自律的な AI エージェント基盤へ——同社の取り組みは、生成 AI 活用のステージを一歩ずつ確実に進める好例といえます。
AI エージェントの本番運用に必要なランタイム・メモリ・アイデンティティ管理などをマネージドで提供する Amazon Bedrock AgentCore は、本事例のような長時間実行・非同期型のエージェント基盤の構築を強力に支援します。生成 AI や AI エージェントの活用にご興味をお持ちのお客様は、ぜひ AWS までお問い合わせください。
(左から)
大松 宏之 — アマゾン ウェブ サービス ジャパン合同会社 ソリューションアーキテクト
高石 明義 様 — 株式会社コーテッグ 代表取締役
古山 玄弥 — アマゾン ウェブ サービス ジャパン合同会社 アカウントマネージャー